Представлен EVA: вариационный автокодировщик с самообучаемым априорным распределением
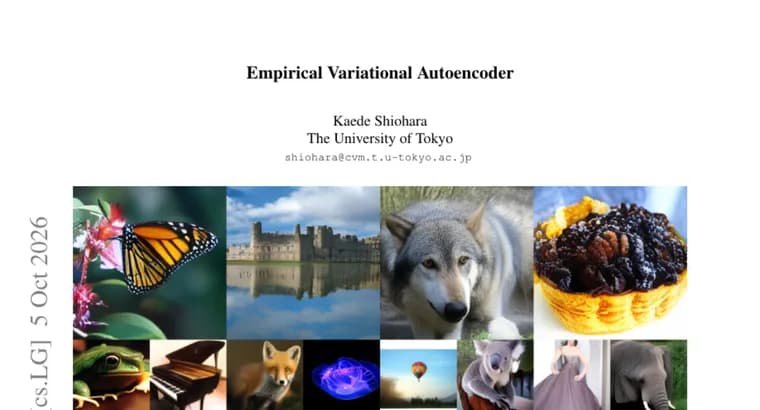
В статье, опубликованной на Hugging Face Papers, представлен Empirical Variational Autoencoder (EVA), общая генеративная схема для непрерывных (то есть не векторно-квантованных) последовательностей.
EVA опирается на нижнюю оценку правдоподобия (evidence lower bound) обычного вариационного автокодировщика (VAE), но устроен иначе в одном ключевом месте. В обычном VAE скрытое пространство подгоняют под стандартное гауссово (нормальное) априорное распределение. В EVA это ограничение заменено на самопредсказанные априорные распределения: авторегрессионные априорные распределения эмпирически выучиваются из обучающих данных. По утверждению авторов, реализовать это можно одним дополнительным линейным слоем поверх VAE.
Зачем это нужно: авторы пишут, что EVA существенно сокращает разрыв между априорным и апостериорным распределениями в скрытом пространстве, который обычно наблюдается в классических VAE. Это, по их словам, даёт высококачественную ancestral sampling (предковую выборку) при генерации последовательных данных.
Проверка: авторы сообщают об обширных экспериментах по синтезу изображений и звука. Вывод такой: EVA достигает качества генерации, сопоставимого с авторегрессионными диффузионными базовыми моделями, при гораздо более быстром времени вывода. Это утверждение самих авторов; в тексте аннотации нет ни метрик, ни названий наборов данных, ни размеров моделей, ни коэффициентов ускорения, а базовые модели названы лишь общим словом «авторегрессионные диффузионные». Качество описано как «сопоставимое», а не как лучшее или равное.
Ключевые факты
- EVA (Empirical Variational Autoencoder), общая генеративная схема для непрерывных, не векторно-квантованных последовательностей.
- Вместо стандартного гауссова априорного распределения модель учит авторегрессионные априорные распределения из обучающих данных, оставаясь на нижней оценке правдоподобия VAE.
- По словам авторов, для этого достаточно одного дополнительного линейного слоя поверх VAE.
- Заявлено существенное сокращение разрыва между априорным и апостериорным распределениями, типичного для обычных VAE.
- На синтезе изображений и звука качество, по утверждению авторов, сопоставимо с авторегрессионными диффузионными базовыми моделями при гораздо более быстром выводе.
Почему это важно
Классические VAE страдают от разрыва между априорным и апостериорным распределениями в скрытом пространстве, а диффузионные подходы дают качество ценой медленного вывода. EVA, по заявлению авторов, пытается совместить сопоставимое качество с гораздо более быстрым выводом, меняя лишь способ задания априорного распределения. Идея простая по реализации: один дополнительный линейный слой поверх VAE.
Кому это важно
Исследователям генеративных моделей для изображений и звука, а также тем, кто работает с автокодировщиками и авторегрессионными моделями над непрерывными скрытыми представлениями. Для практиков это пока скорее сигнал о направлении исследований, чем готовый инструмент.
Как это применить
Из аннотации следует, что EVA можно получить, добавив один линейный слой к существующему VAE, и это единственная практическая подробность. О выпуске кода или моделей в источнике не говорится. Чтобы оценить применимость, нужно читать полный текст статьи и смотреть результаты экспериментов.
Можно ли доверять
Все утверждения о качестве, скорости и сокращении разрыва между распределениями принадлежат самим авторам и приведены в аннотации. Авторы и организации в тексте не названы. Числовых результатов нет: ни метрик, ни наборов данных, ни размеров моделей, ни коэффициентов ускорения. Базовые модели описаны только как «авторегрессионные диффузионные», конкретные не названы. Независимого подтверждения нет.
Риски и подводные камни
Формулировка «сопоставимое качество» не означает превосходства над базовыми моделями, а «гораздо более быстрый вывод» не подкреплён цифрами. Не видно, на каких данных и против каких именно моделей проводилось сравнение. Тезис о «высококачественной ancestral sampling (предковой выборке)» тоже остаётся заявлением авторов, пока не проверены детали экспериментов.