Предложены HybridAgents: ИИ-агенты чередуют скрытые рассуждения и текст
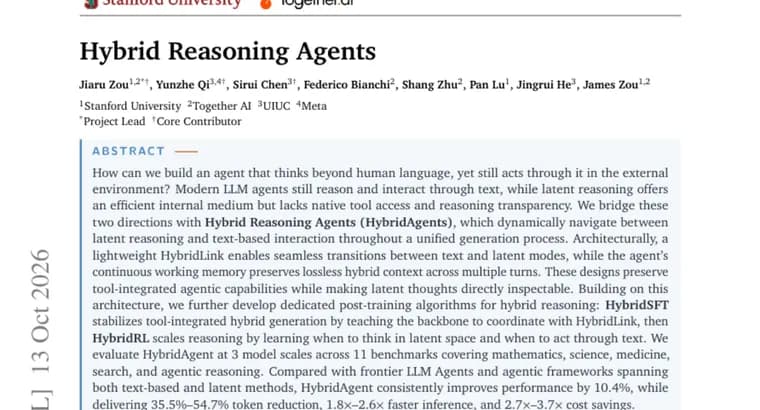
Современные LLM-агенты рассуждают и действуют через текст. Латентные рассуждения (мысли, которые модель ведёт во внутренних представлениях, а не в словах) эффективнее, но у них нет нативного доступа к инструментам и нет прозрачности хода мысли. Работа «Hybrid Reasoning Agents» предлагает соединить два подхода: HybridAgents динамически переключаются между латентными рассуждениями и текстовым взаимодействием в рамках единого процесса генерации.
Архитектура строится на двух элементах. Лёгкий модуль HybridLink обеспечивает переходы между текстовым и латентным режимами, а непрерывная рабочая память агента сохраняет «гибридный» контекст без потерь на протяжении нескольких ходов. По заявлению авторов, это сохраняет агентные способности с инструментами и одновременно делает латентные мысли доступными для прямого осмотра.
Для обучения разработаны специальные алгоритмы постобучения. HybridSFT стабилизирует генерацию с инструментами, обучая базовую модель согласованно работать с HybridLink. HybridRL (обучение с подкреплением) масштабирует рассуждение, учась определять, когда думать в латентном пространстве, а когда действовать через текст.
Оценка проведена на трёх масштабах моделей и 11 бенчмарках по математике, науке, медицине, поиску и агентным рассуждениям. В сравнении с передовыми LLM-агентами и агентными фреймворками, как текстовыми, так и латентными, HybridAgent, по данным аннотации, стабильно улучшает результат на 10,4%, сокращает расход токенов на 35,5-54,7%, ускоряет вывод в 1,8-2,6 раза и экономит стоимость в 2,7-3,7 раза. Код и данные опубликованы на GitHub в репозитории организации togethercomputer.
Ключевые факты
- HybridAgents в одном процессе генерации переключаются между латентными рассуждениями и текстовым взаимодействием с инструментами.
- Ключевые элементы: модуль HybridLink для переходов между режимами и непрерывная рабочая память, хранящая гибридный контекст без потерь между ходами.
- Обучение двухэтапное: HybridSFT стабилизирует генерацию с инструментами, HybridRL учит агента выбирать между латентным мышлением и текстовым действием.
- Оценка на трёх масштабах моделей и 11 бенчмарках (математика, наука, медицина, поиск, агентные задачи): улучшение на 10,4%, токенов меньше на 35,5-54,7%, вывод быстрее в 1,8-2,6 раза, стоимость ниже в 2,7-3,7 раза.
- Код и данные доступны на GitHub.
Почему это важно
Работа пытается решить типичное противоречие: латентные рассуждения экономичны, но не умеют обращаться к инструментам и непрозрачны, а текстовые агенты прозрачны и умеют пользоваться инструментами, но тратят много токенов. Гибридный подход обещает взять достоинства обоих. Если заявленные цифры подтвердятся, это сразу снижает стоимость и время работы агентов.
Кому это важно
Исследователям агентных систем и латентных рассуждений, командам, которые разворачивают LLM-агентов и считают расходы на токены и задержку, а также тем, кого интересует интерпретируемость: по заявлению авторов, латентные мысли в такой схеме можно напрямую осматривать.
Как это применить
Код и данные опубликованы на GitHub (togethercomputer/HybridAgent). Практическое применение потребует переобучения базовой модели: предлагаемая схема включает постобучение HybridSFT и HybridRL, так что это не готовая надстройка над любым агентом. Какие именно модели использованы и каких они размеров, в аннотации не раскрыто.
Можно ли доверять
Это аннотация научной работы: все цифры приведены самими авторами. В тексте не названы конкретные базовые модели, 11 бенчмарков и системы, с которыми шло сравнение, не указана база для оценок экономии токенов, скорости и стоимости, не уточнено, является ли 10,4% процентными пунктами или относительным приростом, средним или медианой. Сведений о рецензировании и месте публикации нет, поэтому результаты стоит считать заявленными, но не независимо проверенными.
Риски и подводные камни
Диапазоны экономии (35,5-54,7% по токенам, 1,8-2,6 раза по скорости, 2,7-3,7 раза по стоимости) приведены без указания, от чего считаны. Результаты по отдельным бенчмаркам, ограничения и случаи неудач в аннотации не описаны. Метод требует специального обучения, а значит, перенос на другие модели и задачи нужно проверять отдельно.