Предложен EvidenceConnect: данные, чтобы ИИ связывал детали картинки
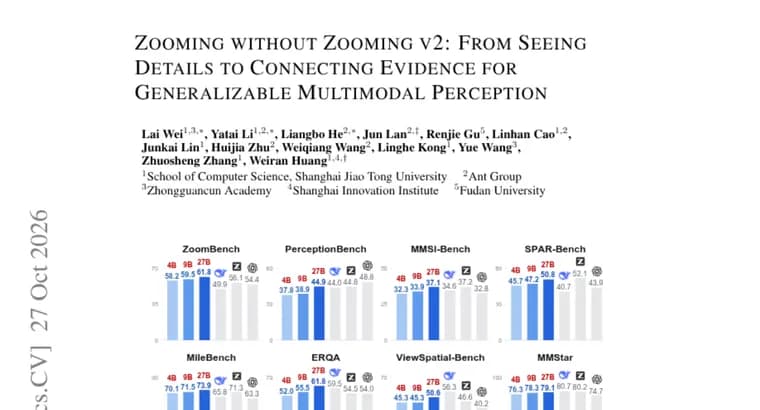
Препринт «Zooming without Zooming v2» посвящён мультимодальному восприятию, способности нейросетей понимать изображения вместе с текстом. Авторы отмечают, что пространственное восприятие и понимание длинного мультимодального контекста, две ключевые задачи для воплощённого ИИ (embodied AI) и мультимодальных агентов. Но синтезировать для них целевые качественные обучающие данные, по словам авторов, трудно и дорого.
Ключевая идея работы: эти задачи опираются на общую способность, которую авторы называют «связыванием свидетельств» (connecting evidence). Она включает четыре шага: найти релевантные визуальные факты, привязать их к нужным объектам, восстановить связи между ними и собрать из этого ответ. По утверждению авторов, целевые данные для такой способности синтезировать гораздо проще, чем данные для самих задач.
Для этого предложен EvidenceConnect, простой во внедрении фреймворк синтеза данных. Он берёт увеличенные фрагменты связанных областей одного изображения и по ним генерирует вопросы, требующие сравнить, объединить или выстроить в цепочку визуальные свидетельства.
Качество контролируется двумя способами. Во-первых, эталонный ответ сохраняется, только если с ним согласны независимые визуально-языковые модели (VLM). Во-вторых, тесты с исключением областей отбрасывают вопросы, ответ на которые остаётся верным даже после удаления выбранных областей, то есть вопросы, не требующие этих деталей.
На полученных данных базовые VLM дообучают методом RLVR; результат называется Zooming without Zooming v2 (ZwZ2). Хотя данные не подгонялись ни под один целевой тест, ZwZ2, как заявляют авторы, улучшает тонкое и пространственное восприятие, а также даёт дополнительный выигрыш в пространственных рассуждениях для воплощённого ИИ, понимании длинного мультимодального контекста, задачах мультимодальных агентов и общем визуальном рассуждении. Из этого авторы делают вывод, что EvidenceConnect, эффективный способ обучать связыванию свидетельств, а усиление этой общей способности, как они предполагают, ведёт к более обобщаемому мультимодальному восприятию.
Ключевые факты
- EvidenceConnect синтезирует вопросы по увеличенным фрагментам связанных областей одного изображения: их нужно сравнить, объединить или выстроить в цепочку.
- Контроль качества: эталонный ответ остаётся, только если с ним согласны независимые VLM; вопросы, ответ на которые переживает удаление выбранных областей, отбрасываются.
- Базовые VLM дообучают на этих данных методом RLVR, так получается Zooming without Zooming v2 (ZwZ2).
- Авторы заявляют улучшение тонкого и пространственного восприятия и дополнительный рост в задачах воплощённого ИИ, длинного мультимодального контекста, агентов и общего визуального рассуждения.
- Данные не подгонялись под конкретные тесты; из результатов авторы заключают, что усиление общей способности «связывать свидетельства» делает восприятие более обобщаемым.
Почему это важно
Данные для обучения мультимодальных моделей пространственному восприятию и длинному контексту, по словам авторов, трудно и дорого синтезировать. Работа предлагает обходной путь: вместо данных под каждую задачу тренировать одну общую способность, связывать визуальные факты. Если подход работает, это может удешевить подготовку данных для разных мультимодальных задач сразу. Пока это заявление авторов препринта, а не независимо подтверждённый результат.
Кому это важно
Исследователям и инженерам, которые обучают визуально-языковые модели и ищут способы синтезировать для них данные. Также интересно тем, кто работает над воплощённым ИИ и мультимодальными агентами: именно эти направления авторы называют основными потребителями улучшенного восприятия.
Как это применить
Из описания видна схема, которую можно взять за ориентир: взять изображение, выделить связанные области, сгенерировать вопросы на сравнение, объединение или цепочку свидетельств, оставить только те ответы, с которыми согласны независимые VLM, и отсечь вопросы, ответ на которые не меняется при удалении областей. Затем дообучить базовую VLM методом RLVR. Для готового применения этого текста недостаточно: сведений о релизе кода, модели или набора данных в описании нет.
Можно ли доверять
Источник, аннотация препринта на Hugging Face, то есть самоописание авторов, а не независимая проверка. Улучшения описаны только качественно: названий тестов, значений метрик и величины прироста в тексте нет, как нет и сравнения с другими моделями. Не указано также, какие именно базовые VLM использовались. Вывод про обобщаемость сформулирован осторожно («предполагают»), и читать его стоит как гипотезу, а не доказанный факт.
Риски и подводные камни
Без цифр оценить масштаб улучшения невозможно. Неизвестны объём синтезированных данных и стоимость обучения, поэтому практичность подхода не ясна. Контроль качества опирается на согласие других VLM, а значит, ошибки таких моделей теоретически могут попасть в эталонные ответы. Это осторожное соображение, а не утверждение источника. Утверждение о «более обобщаемом восприятии» остаётся предположением авторов до появления подробных результатов и независимых проверок.