Предложен единый алгоритм обучения базовых моделей: от предобучения до RL
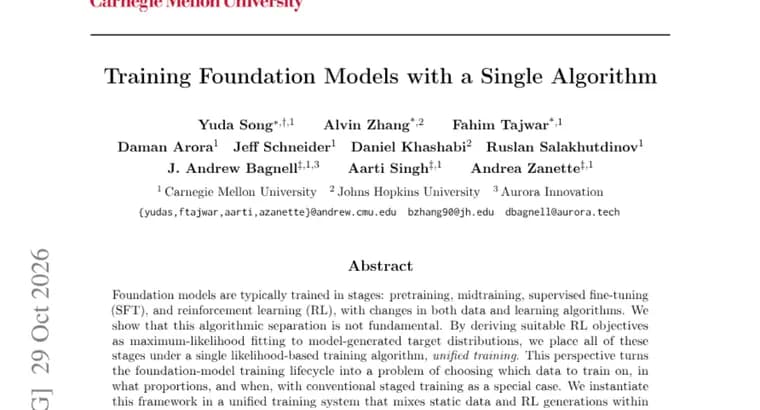
Базовые модели обычно обучают по этапам: предобучение, промежуточное обучение (midtraining), контролируемое дообучение (SFT) и обучение с подкреплением (RL). На разных этапах меняются и данные, и алгоритмы обучения. Авторы препринта, опубликованного на Hugging Face Papers, пишут, что такое разделение по алгоритмам не является фундаментальным.
Их ключевой шаг, вывод подходящих целевых функций RL как подгонки по максимуму правдоподобия к целевым распределениям, которые порождает сама модель. Благодаря этому все перечисленные этапы попадают под один алгоритм обучения на основе правдоподобия, который авторы называют «единым обучением» (unified training).
При таком взгляде жизненный цикл обучения базовой модели превращается в задачу выбора: на каких данных обучать, в каких пропорциях и когда. Привычное поэтапное обучение при этом оказывается частным случаем.
На практике авторы реализовали подход в системе единого обучения, которая смешивает статические данные и генерации, полученные в RL, внутри одного тренера (trainer). По их утверждению, в контролируемых и реальных экспериментах единое обучение улучшает баланс между точностью и затратами вычислений, расширяет охват задач, сохраняет более широкие возможности модели и даёт более сильную отправную точку для непрерывного обучения. Работа, по словам авторов, закладывает основу для единой науки об обучении базовых моделей, связывающей математические принципы, инфраструктуру обучения и развитие возможностей моделей.
В доступном описании нет количественных результатов: не названы метрики, наборы данных, размеры моделей и базовые методы для сравнения.
Ключевые факты
- Авторы утверждают, что разделение обучения базовых моделей на предобучение, промежуточное обучение, SFT и RL по типу алгоритма не фундаментально.
- Основа подхода: целевые функции RL выводятся как подгонка по максимуму правдоподобия к распределениям, порождаемым самой моделью.
- Весь цикл обучения сводится к выбору данных, их пропорций и момента подачи; поэтапное обучение, частный случай.
- Реализована система, которая смешивает статические данные и RL-генерации в одном тренере.
- Заявлено улучшение баланса точность/вычисления и охвата задач без потери широких возможностей, но в описании нет цифр.
Почему это важно
Обучение современных базовых моделей традиционно строится как цепочка отдельных этапов с разными алгоритмами и разной инфраструктурой. Если утверждение авторов верно, эти этапы можно описывать одним математическим языком, а вопрос «как обучать» заменяется вопросом «на каких данных, в каких пропорциях и когда». Это концептуальная заявка: она не про новую модель, а про способ думать о всём цикле обучения.
Кому это важно
Прежде всего исследователям и инженерам, которые занимаются обучением больших языковых моделей: предобучением, SFT и RL. Также тем, кто строит инфраструктуру обучения и думает о непрерывном обучении моделей, поскольку авторы заявляют, что их подход даёт для него более сильную отправную точку.
Как это применить
Прямого практического рецепта в доступном описании нет: упоминается лишь система единого обучения, смешивающая статические данные и RL-генерации в одном тренере. О публикации кода, моделей или самой системы в описании не говорится. Пока это повод изучить полный текст препринта и посмотреть, насколько вывод целевых функций RL как подгонки по правдоподобию применим к вашему конвейеру обучения.
Можно ли доверять
Это препринт, а описание, лишь краткая аннотация. Все утверждения о выигрыше в балансе точности и вычислений, охвате задач и сохранении возможностей принадлежат самим авторам и в аннотации не подкреплены цифрами, названиями наборов данных или сравнением с известными базовыми методами. Оценить силу результата можно только по полному тексту и независимой проверке.
Риски и подводные камни
Главный риск, принять концептуальную заявку за доказанный результат: без количественных данных неясно, насколько велик выигрыш и воспроизводим ли он. Неясно также, на каких моделях и задачах проводились эксперименты и подходит ли метод для масштабов, на которых обучаются современные базовые модели. Формулировка о «единой науке» обучения пока остаётся программной.
«Мы показываем, что это алгоритмическое разделение не является фундаментальным.»
— авторы препринта «Training Foundation Models with a Single Algorithm»