Платоновскую гипотезу доказали для JEPA: модель на 109M обошла языковые на 72B
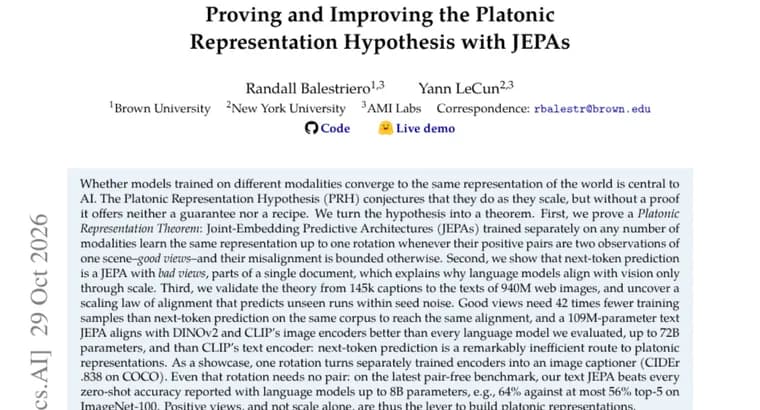
Статья с Hugging Face Papers берётся за Platonic Representation Hypothesis (PRH, «платоновская гипотеза представлений»): идею, что модели, обученные на разных модальностях, по мере роста сходятся к одному и тому же представлению мира. Без доказательства, пишут авторы, гипотеза не даёт ни гарантии, ни рецепта. Они заявляют, что превращают её в теорему.
Первый результат: теорема о платоновском представлении. Архитектуры Joint-Embedding Predictive Architectures (JEPA), обученные отдельно на любом числе модальностей, учат одно и то же представление с точностью до одного поворота. Условия таковы: положительные пары, это два наблюдения одной и той же сцены («хорошие ракурсы», good views), а рассогласование в остальном ограничено.
Второй результат: предсказание следующего токена, по утверждению авторов, это JEPA с «плохими ракурсами», то есть с разными частями одного документа. Отсюда они объясняют, почему языковые модели сближаются со зрением только за счёт масштаба.
Третий результат: экспериментальная проверка на данных от 145 тысяч подписей до текстов к 940 млн веб-изображений. Авторы нашли закон масштабирования согласованности, который предсказывает не виденные прежде запуски в пределах шума от случайного зерна. Хорошие ракурсы требуют в 42 раза меньше обучающих примеров, чем предсказание следующего токена на том же корпусе, чтобы достичь той же согласованности. Текстовая JEPA на 109 млн параметров согласуется с кодировщиками изображений DINOv2 и CLIP лучше, чем любая из оценённых языковых моделей (до 72 млрд параметров), и лучше текстового кодировщика CLIP. Вывод авторов: предсказание следующего токена, крайне неэффективный путь к платоновским представлениям.
В качестве демонстрации один поворот превращает раздельно обученные кодировщики в модель подписей к изображениям (CIDEr 0,838 на COCO). Причём и этому повороту пара не нужна: на новейшем бенчмарке без парных данных текстовая JEPA авторов превосходит все zero-shot результаты языковых моделей до 8 млрд параметров, например, 64% против максимум 56% по top-5 на ImageNet-100. Итог: рычаг построения платоновских представлений, положительные ракурсы, а не один только масштаб.
Ключевые факты
- Авторы заявляют теорему: отдельно обученные JEPA на любом числе модальностей учат одно представление с точностью до одного поворота, если положительные пары, два наблюдения одной сцены, а рассогласование в остальном ограничено.
- Предсказание следующего токена трактуется как JEPA с «плохими ракурсами» (части одного документа); это, по мнению авторов, объясняет, почему языковые модели сближаются со зрением лишь через масштаб.
- Хорошим ракурсам нужно в 42 раза меньше обучающих примеров, чем предсказанию следующего токена на том же корпусе, для той же согласованности.
- Текстовая JEPA на 109 млн параметров согласуется с DINOv2 и кодировщиками изображений CLIP лучше всех оценённых языковых моделей до 72 млрд параметров.
- Без парных данных текстовая JEPA даёт 64% против максимум 56% top-5 на ImageNet-100 у zero-shot моделей до 8 млрд; один поворот между кодировщиками даёт подписи к изображениям с CIDEr 0,838 на COCO.
Почему это важно
Вопрос, сходятся ли модели разных модальностей к одному представлению мира, авторы называют центральным для ИИ. Платоновская гипотеза до сих пор была предположением; здесь заявлено формальное доказательство для класса JEPA и вывод, что решающим фактором служат «хорошие ракурсы» (два наблюдения одной сцены), а не только размер модели. Если это подтвердится, получается практический рецепт: согласованности между модальностями можно добиваться выбором обучающей задачи, а не наращиванием масштаба.
Кому это важно
Исследователям представлений и мультимодальных моделей, а также тем, кто работает с JEPA и самообучением. Интересно и тем, кто сравнивает предсказание следующего токена с альтернативными целями обучения: авторы утверждают, что для платоновских представлений оно крайне неэффективно.
Как это применить
Прямого готового инструмента в описании нет, это теоретическая работа с экспериментами. Идея для практики такова: строить положительные пары из двух наблюдений одной сцены (например, изображение и его подпись), а не из частей одного документа. Сведений о коде, данных или весах в тексте нет.
Можно ли доверять
Это аннотация статьи, а не полный текст: ход доказательства, его допущения помимо ограниченного рассогласования и величина этой границы не приведены. Не указаны форма закона масштабирования, название бенчмарка без парных данных и то, какие именно языковые модели сравнивались (известны лишь потолки 72 млрд и 8 млрд). Результат CIDEr 0,838 дан без базового уровня для сравнения. Все выводы, заявления самих авторов; о независимой проверке или рецензировании в тексте не сказано. В тексте также не названы авторы и организации.
Риски и подводные камни
Теорема действует при заданных условиях: положительные пары должны быть настоящими двумя наблюдениями одной сцены. В реальных данных такие пары не всегда доступны, и вывод о превосходстве над языковыми моделями относится к согласованности с кодировщиками изображений, а не к общему качеству текстовых моделей. Сравнение размеров (109 млн против 72 млрд параметров) касается одной метрики согласованности, и переносить его на другие задачи нельзя без дополнительных проверок.
«Положительные ракурсы, а не один лишь масштаб, вот рычаг для построения платоновских представлений.»
— Из аннотации статьи