PACT: новый метод RL-дообучения языковых моделей обошёл GRPO и PPO
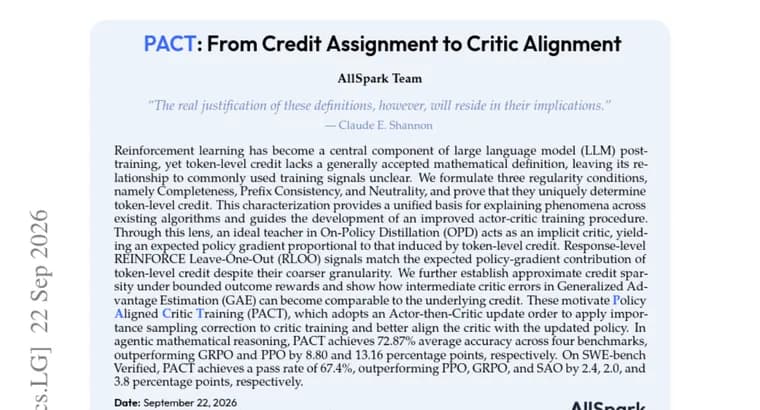
В RL-дообучении больших языковых моделей давно не было формального математического определения того, как распределять «заслугу» (credit) за итоговый результат между отдельными токенами ответа, из-за этого было неясно, почему одни обучающие сигналы работают лучше других. Авторы работы формулируют три условия регулярности, Completeness (полнота), Prefix Consistency (согласованность по префиксу) и Neutrality (нейтральность), и доказывают, что вместе они однозначно определяют токен-уровневую «заслугу». На основе этой характеристики они показывают, как соотносятся между собой уже используемые обучающие сигналы: «идеальный учитель» в методе On-Policy Distillation (OPD) фактически действует как неявный критик, а сигналы response-level REINFORCE Leave-One-Out (RLOO), несмотря на более грубую детализацию, по ожидаемому вкладу в градиент политики совпадают с токен-уровневой «заслугой». Также показано, что при ограниченных итоговых наградах «заслуга» приближённо разрежена (сосредоточена на немногих токенах), а в методе Generalized Advantage Estimation (GAE) промежуточные ошибки критика могут становиться сопоставимы по величине с самой «заслугой», то есть мешать обучению.
На основе этих наблюдений авторы предлагают процедуру Policy Aligned Critic Training (PACT): она использует порядок обновления «сначала актёр, потом критик» и применяет коррекцию через importance sampling при обучении критика, чтобы точнее согласовать его с уже обновлённой политикой. В экспериментах на агентных задачах математических рассуждений PACT показывает среднюю точность 72,87% на четырёх бенчмарках, превосходя GRPO на 8,80 процентного пункта и PPO, на 13,16 процентного пункта. На бенчмарке SWE-bench Verified (задачи по программированию) PACT достигает доли решённых задач 67,4%, что выше PPO на 2,4 процентного пункта, GRPO, на 2,0 процентного пункта и метода SAO, на 3,8 процентного пункта.
Ключевые факты
- Три условия регулярности, Completeness, Prefix Consistency и Neutrality, однозначно определяют токен-уровневую «заслугу» в RL-дообучении LLM
- Показано, что «идеальный учитель» в On-Policy Distillation действует как неявный критик, а сигналы RLOO совпадают по ожидаемому вкладу в градиент с токен-уровневой заслугой
- Предложен метод PACT с порядком обновления «сначала актёр, потом критик» и коррекцией importance sampling для критика
- На агентных задачах математических рассуждений PACT показывает 72,87% средней точности, на 8,80 п.п. выше GRPO и на 13,16 п.п. выше PPO
- На SWE-bench Verified PACT достигает 67,4% решённых задач, выше PPO на 2,4 п.п., GRPO на 2,0 п.п. и SAO на 3,8 п.п.
Почему это важно
До этой работы токен-уровневое распределение «заслуги» в обучении с подкреплением для языковых моделей не имело общепринятого математического определения, из-за чего было неясно, как соотносятся между собой разные обучающие сигналы и алгоритмы (GRPO, PPO, RLOO, GAE). Строгая характеристика через три условия регулярности даёт единую основу для объяснения, почему одни методы работают лучше других, и позволяет целенаправленно улучшать процедуру обучения критика.
Кому это важно
Исследователям и инженерам, которые занимаются RL-дообучением больших языковых моделей для задач рассуждения и агентных сценариев, в частности, математики и автоматизированного программирования, где итоговое качество модели напрямую зависит от эффективности алгоритма обучения с подкреплением.
Как это применить
PACT, это изменение порядка обновления actor-critic (сначала обновляется актёр, затем критик с коррекцией importance sampling), которое можно встроить в существующие пайплайны RL-дообучения LLM как альтернативу GRPO или PPO для повышения точности на задачах рассуждения и кода.
Можно ли доверять
Материал опубликован как научная работа на странице Hugging Face Papers; в доступном тексте не указаны ни авторы, ни организации, ни дата публикации, а детали используемых бенчмарков и метод сравнения SAO не раскрыты. Приведённые цифры, результаты самих авторов, независимая проверка или рецензирование в источнике не упоминаются.
Риски и подводные камни
Результаты получены на ограниченном наборе тестов, четырёх бенчмарках математических агентных рассуждений (без раскрытия их состава) и SWE-bench Verified, что затрудняет оценку того, насколько улучшения переносятся на другие задачи и модели. Отсутствие информации об авторах и рецензировании также не позволяет независимо оценить методологию.