Opus5.5 с Claude Code получил 6 золотых медалей в бенчмарке AAArena
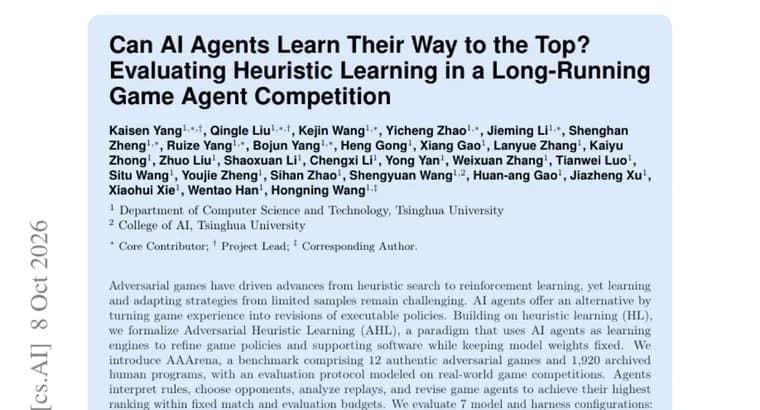
Авторы статьи формализуют подход Adversarial Heuristic Learning (AHL, состязательное эвристическое обучение). Идея в том, что ИИ-агент служит «движком обучения»: он превращает игровой опыт в правки исполняемых политик (стратегий) и вспомогательного программного обеспечения, а веса самой модели остаются неизменными. Отправная точка, эвристическое обучение (heuristic learning, HL); авторы отмечают, что обучение и адаптация стратегий по ограниченному числу примеров в состязательных играх остаются трудной задачей.
Для проверки подхода представлен бенчмарк AAArena: 12 настоящих состязательных игр и 1 920 архивных программ, написанных людьми. Протокол оценки устроен по образцу реальных игровых соревнований. Агент должен самостоятельно разобрать правила, выбрать соперников, проанализировать записи матчей и переписать своего игрового агента, чтобы занять как можно более высокое место при фиксированных бюджетах на матчи и оценку.
Главный результат: из оценённых конфигураций «модель + среда запуска агента» Opus5.5 с Claude Code получил 6 золотых медалей, тогда как ни одна оценённая конфигурация не возглавила остальные 6 человеческих рейтингов (лестниц). Качество в целом ниже в играх с более сложным описанием правил.
Дополнительные эксперименты показали две вещи. Во-первых, улучшению политики помогают выбор соперников и плотная обратная связь. Во-вторых, агенты учатся и на записях собственных матчей (on-policy), и на записях матчей других игроков (off-policy). Авторы делают вывод, что у эвристического обучения есть потенциал в состязательных играх, но сохраняются проблемы с пониманием игры, реализацией стратегии и разработкой политики на длинном горизонте.
Ключевые факты
- Adversarial Heuristic Learning (AHL): ИИ-агент улучшает игровые политики и вспомогательное ПО, а веса модели остаются фиксированными.
- Бенчмарк AAArena включает 12 настоящих состязательных игр и 1 920 архивных программ людей; протокол смоделирован по реальным игровым соревнованиям.
- Opus5.5 с Claude Code получил 6 золотых медалей, а в остальных 6 человеческих рейтингах не победила ни одна оценённая конфигурация.
- Результаты в целом слабее в играх с более сложными правилами.
- Улучшению помогают выбор соперников и плотная обратная связь; агенты учатся на записях и своих матчей, и чужих.
Почему это важно
Работа проверяет, может ли ИИ-агент, не меняя веса модели, а лишь переписывая код и вспомогательные инструменты, дорасти до уровня людей в соревновательных играх. Это пример того, как долго работающий агент превращает опыт в исполняемые улучшения, а не в дообучение. Итог неоднозначный: 6 золотых медалей у лучшей конфигурации и ни одной победы в остальных 6 рейтингах показывают, что до уверенного превосходства над людьми на всём наборе игр ещё далеко.
Кому это важно
Исследователям агентов и обучения с подкреплением, которым нужен новый бенчмарк с живыми человеческими рейтингами и архивом чужих программ. Также тем, кто строит кодовых агентов на базе Claude Code и подобных сред: по сути, это замер того, как такие системы справляются с длинным циклом «разобрать правила, поиграть, разобрать записи, исправить код».
Как это применить
Прямой инструкции по применению в аннотации нет, но выводы авторов можно использовать как ориентиры при построении собственных агентов с самоулучшением: давать агенту возможность выбирать соперников (или, шире, сложность задач), обеспечивать плотную обратную связь и позволять учиться не только на собственных записях, но и на записях чужих действий. Прежде чем опираться на бенчмарк, стоит найти полный текст статьи: в аннотации не раскрыты бюджеты на матчи, список игр и результаты других конфигураций.
Можно ли доверять
Пересказ построен на аннотации статьи; в ней не названы авторы и организации, поэтому оценить репутацию команды по этому тексту нельзя. Цифры (12 игр, 1 920 программ, 6 золотых медалей, 6 нетронутых рейтингов) приведены самими авторами и в аннотации не подкреплены деталями. Независимого подтверждения в материале нет.
Риски и подводные камни
В аннотации не перечислены сами 12 игр и платформы, не названы пороги золотых медалей и не сказано, в каких именно играх они получены. Не указаны размеры фиксированных бюджетов и то, какие ещё модели и среды запуска оценивались и с каким результатом. Поэтому утверждать, что Opus5.5 с Claude Code в целом обыграл людей, нельзя: сказано лишь про 6 золотых медалей и то, что остальные 6 человеческих рейтингов ни одна конфигурация не возглавила. Кроме того, сами авторы отмечают, что результаты слабее в играх со сложными правилами и что остаются проблемы с пониманием игры, реализацией стратегии и долгосрочным планированием.