OpenAI спроектировала чип Jalapeño за 20 месяцев с помощью собственных нейросетей
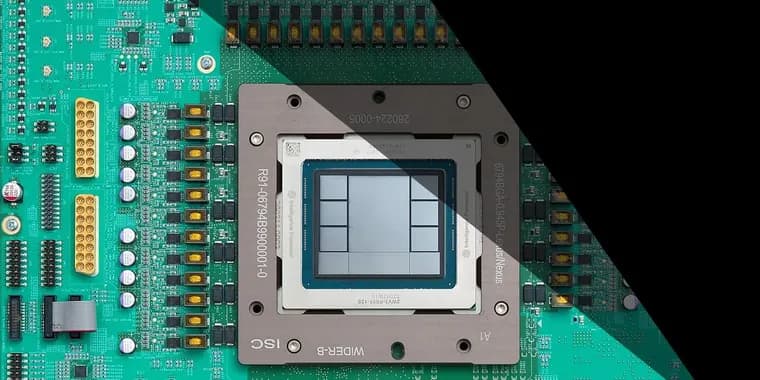
25 августа OpenAI представила Jalapeño, свой первый ИИ-ускоритель для инференса. Чип обеспечивает до 13,4 петафлопс 4-битных вычислений и обращается к 232 гигабайтам памяти по каналу с пропускной способностью 15,4 терабайта в секунду. По тестам, которые приводит сама OpenAI, Jalapeño может снижать полную задержку, время от запроса до последнего токена ответа, до 3,6 раза по сравнению с чипом Nvidia GB300, на который сейчас опирается компания, и при этом потреблять меньше энергии (точных цифр по ваттам источник не приводит). Сохранится ли этот выигрыш при массовом развёртывании в инференс-парке OpenAI, пока не ясно, сама статья называет это открытым вопросом.
Вторая часть истории, как чип спроектировали. От первой концепции архитектуры до первого кремния прошло меньше 20 месяцев, а от первого RTL-кода (регистрового описания логики чипа) до передачи дизайна в производство, всего девять. Ричард Хо, вице-президент OpenAI по аппаратному обеспечению, говорит: «Модели дают нашим инженерам суперспособности. Наши инженеры по-прежнему ведут работу, они по-прежнему принимают финальные решения о происходящем. Но они могут делать всё намного быстрее, могут исследовать намного больше путей». Команду, которая спроектировала Jalapeño, Хо описывает как в среднем меньше 100 человек за время проекта; сегодня она держится на уровне около 100 и занимается вторым и третьим поколениями чипа, без учёта специалистов партнёра проекта, компании Broadcom.
Работу разделили: OpenAI отвечала за сквозное системное проектирование, инференс-ускоритель, иерархию памяти, сетевую часть, а Broadcom занималась «физическим проектированием от вентилей и далее», как формулирует Хо. Дэвид Чин, сооснователь стартапа agentic-проектирования чипов Verkor.io, считает заявленные сроки правдоподобными, но подчёркивает: без участия Broadcom повторить их с нуля было бы невозможно. Его партнёр по Verkor.io Рави Кришна называет скорость OpenAI «относительно впечатляющим результатом» и ожидает, что дальнейший рост возможностей LLM позволил бы пройти тот же путь ещё быстрее, начни OpenAI проект сегодня. Профессор Эндрю Канг из Калифорнийского университета в Сан-Диего тоже называет темп OpenAI заметным, по его словам, «вероятно, лучшим в отрасли на сегодня».
Ключевую роль сыграл выбор инструментов. Фронтенд-процесс OpenAI построила вокруг XLS (Accelerated Hardware Synthesis), открытого инструмента синтеза высокого уровня, изначально созданного в Google, который позволяет описывать чип на языках, близких к обычному программированию: DSLX (предметно-ориентированный язык, вдохновлённый Rust) и C++, а затем сам транслирует их в Verilog, язык описания аппаратуры. «Мы думали, как использовать ИИ, чтобы ускорить проект, и ИИ оказался намного лучше в вещах, похожих на софт», говорит Крис Лири, сотрудник технического состава OpenAI, который начинал разработку XLS ещё в Google. Анкур Шривастава, директор по инициативам в области полупроводников в Мэрилендском университете, объясняет: автоматизация в проектировании чипов существует десятилетиями, но именно способность LLM понимать язык и код делает их особенно пригодными для задач, которые «всё ещё лежат в лингвистической области проблемы».
Когда в мае с фабрики пришли первые чипы, команда направила внутренние модели OpenAI на оптимизацию программного обеспечения для тестов производительности вроде InferenceX от SemiAnalysis. На тесте multi-head latent attention от DeepSeek результат вырос с 0,31% до 88,94% от теоретического потолка (заданного вычислительной мощностью и пропускной способностью памяти чипа), и это произошло примерно за 40 часов. По словам Хо, результат воспроизводим, а значит время между получением первых чипов с фабрики и выходом на серийные объёмы можно сократить: «Все наши предположения по срокам теперь будут строиться на том, что у нас есть эта возможность».
Проект начинался с помощью моделей уровня o3 (публично OpenAI выпустила её в апреле 2025 года, но команде Jalapeño она была доступна раньше). К моменту завершения проекта в распоряжении команды уже были предшественники GPT-6 Astra, модели, которые вышли публично 3 сентября 2026 года и умеют работать напрямую с Verilog, без перевода через XLS, а также, по словам Лири, почти способны самостоятельно управлять проприетарными инструментами проектирования. Хо подтвердил, что команда пользовалась и внутренними LLM, дообученными специально под проектирование чипов и недоступными публично, но отказался называть конкретные модели. По его словам, цель, перенести уроки этого проекта в коммерческие модели компании: «Можно смело сказать, что Astra и следующие за ней модели будут очень хороши в проектировании чипов».
В бэкенд-проектировании, трассировке соединений, проверке тактовой частоты и энергопотребления, подготовке данных для фабрики, ИИ помогал меньше: эту часть по большей части вела Broadcom. Тем не менее на конференции IEEE Hot Chips 2026 Хо и Лири привели цифры и по ней: ИИ-оптимизация физического дизайна позволила сократить площадь блоков матричного умножения на 10% по сравнению с оптимизированной вручную человеком базовой версией, то есть разместить больше логики на том же куске кремния. Рави Кришна из Verkor.io считает нынешний подход OpenAI к бэкенду несколько консервативным и связывает это со сроками: проект стартовал в октябре 2024 года, а модели заметно подтянулись именно с апреля 2026-го. Его партнёр по Verkor.io Суреш Кришна соглашается: по его мнению, ничто не мешает построить агентный цикл, который в основном автоматизирует и бэкенд-часть процесса.
Для второго поколения чипа Хо и Лири готовят пересмотр всего процесса, добавляя ИИ в верификацию и физическое проектирование; среди новых инструментов, автоматический анализ и визуализация осциллограмм, который должен упростить поиск тактовых сигналов, связанных со сбоями. При этом Хо и Лири прямо говорят: полностью автоматизировать проектирование чипов нельзя. «Мы не утверждаем, что кто угодно может прийти и построить топовый, передовой ИИ/ML-ускоритель, используя только [платформу для кодинга OpenAI] Codex, поясняет Хо., Мы говорим о конкретных вещах: как лучше работать с Codex и как небольшая команда с жёсткими сроками добивается качественного результата».
Ключевые факты
- Чип Jalapeño: до 13,4 петафлопс 4-битных вычислений, 232 ГБ памяти с пропускной способностью 15,4 ТБ/с; по тестам OpenAI задержка от запроса до последнего токена ниже до 3,6 раза, чем у Nvidia GB300, при меньшем энергопотреблении.
- От первой концепции архитектуры до первого кремния, меньше 20 месяцев; от первого RTL-кода до передачи в производство, девять месяцев; команда OpenAI держалась в пределах ста человек, без учёта партнёра Broadcom.
- Фронтенд-проектирование (архитектура, RTL) строился вокруг открытого инструмента XLS (языки DSLX и C++, транслируемые в Verilog), по словам инженера Криса Лири, эта часть «похожа на софт», поэтому LLM справлялись с ней лучше.
- Когда в мае пришли первые чипы, ИИ-модели OpenAI помогли примерно за 40 часов поднять производительность на тесте multi-head latent attention от DeepSeek с 0,31% до 88,94% от теоретического потолка; на IEEE Hot Chips 2026 OpenAI также заявила о сокращении площади блоков матричного умножения на 10% благодаря ИИ-оптимизации физического дизайна.
- Проект начинался на моделях уровня o3, а закончился на предшественниках GPT-6 Astra (публично вышла 3 сентября 2026 года), которые уже умеют работать напрямую с Verilog, минуя XLS; бэкенд-проектирование, которым занимался Broadcom, LLM пока помогали меньше, Рави Кришна называет это следствием сроков проекта (стартовал в октябре 2024 года), а не потолком возможностей.
Почему это важно
OpenAI не просто выпустила новый ИИ-ускоритель Jalapeño, она показала на своём же проекте, что большие языковые модели уже ускоряют один из самых долгих и сложных инженерных процессов: проектирование чипов. Путь от первой концепции архитектуры до первого кремния занял меньше 20 месяцев, а независимые эксперты называют этот темп одним из лучших в отрасли на сегодня. Это меняет ожидания по срокам разработки железа в целом, а не только у самой OpenAI.
Кому это важно
Инженерам и менеджерам, которые проектируют собственные ИИ-ускорители, в OpenAI и у конкурентов; разработчикам инструментов автоматизации проектирования электроники, которым предстоит встраивать LLM в свои продукты; инвесторам и аналитикам, оценивающим, насколько быстро OpenAI сможет заместить чипы Nvidia в своём инференс-парке.
Как это применить
OpenAI построила рабочий процесс вокруг открытого инструмента синтеза высокого уровня XLS (Accelerated Hardware Synthesis, изначально из Google): инженеры пишут код на языке DSLX (вдохновлён Rust) и на C++, а XLS сам переводит его в Verilog, язык описания аппаратуры. Такая связка близка к обычной разработке ПО, поэтому LLM работали с ней эффективнее, чем с традиционными инструментами проектирования чипов. Тем, кто планирует похожий путь, стоит начинать именно с этой, «программистской» части процесса, архитектуры, RTL-кода, а не с физического размещения транзисторов на кристалле, где, по признанию самой OpenAI, ИИ пока помогает меньше.
Можно ли доверять
Технические цифры по чипу и рекордные сроки, из собственных материалов OpenAI и её презентации на конференции IEEE Hot Chips 2026. Но в статье есть и независимые голоса: сооснователи стартапа Verkor.io Дэвид Чин и Рави Кришна, а также профессор Эндрю Канг из Калифорнийского университета в Сан-Диего и Анкур Шривастава, директор по инициативам в области полупроводников в Мэрилендском университете, все четверо не связаны с проектом. Они подтверждают, что темп разработки реален и как минимум не уступает лучшим в отрасли, но уточняют: без участия партнёра OpenAI, компании Broadcom, взявшей на себя физическое проектирование, повторить такую скорость с нуля было бы невозможно.
Риски и подводные камни
Ключевые производительные цифры, до 3,6 раза меньшая задержка и меньшее энергопотребление по сравнению с чипом Nvidia GB300, это заявления самой OpenAI по её собственным тестам, а не независимые измерения; статья прямо называет открытым вопросом, сохранится ли выигрыш при массовом развёртывании чипа. Проект держался на партнёрстве с Broadcom, которая отвечала за физическое проектирование «от вентилей и далее», в этой части ИИ применялся меньше, и это ограничивает вывод о том, что весь цикл создания чипа уже можно доверить нейросетям. Сама OpenAI это подчёркивает: по словам Ричарда Хо, компания не утверждает, что кто угодно может построить топовый ИИ-ускоритель, используя только платформу для кодинга Codex, финальные решения по-прежнему принимают инженеры-люди.
«Модели дают нашим инженерам суперспособности.»
— Ричард Хо, вице-президент OpenAI по аппаратному обеспечению