OmniShowcase: нейросеть генерирует видео объекта по нескольким ракурсам с учётом 3D-формы
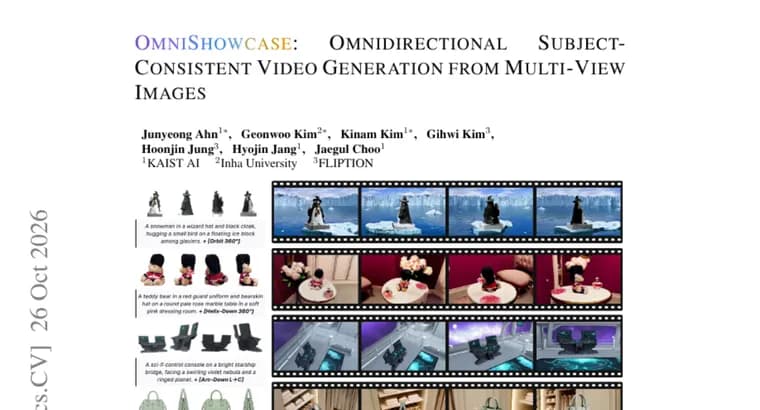
В статье представлен OmniShowcase, метод генерации видео конкретного объекта по нескольким опорным изображениям (subject-to-video, S2V). Задача остаётся трудной, когда камера показывает поверхности, которых нет на входных снимках.
Авторы описывают проблему так. Ранние S2V-методы опираются на одно опорное изображение и поэтому вынуждены «додумывать» невидимую внешность и геометрию объекта при смене ракурса. Более новые методы используют несколько опорных видов, но явно не задают 3D-структуру, которая связывает эти наблюдения. Кроме того, существующие обучающие данные не гарантируют, что смена ракурса сохраняет один и тот же трёхмерный объект.
OmniShowcase строится на двух компонентах. Первый, полностью автоматический конвейер синтеза данных: он создаёт обучающие видео вдоль разных траекторий камеры, а изменение ракурса определяется геометрией самого объекта; поддерживаются даже полные орбиты на 360 градусов. Второй, метод геометрического обусловливания: видеомодели подаётся «поворотный круг» (turntable) из карт нормалей поверхности, восстановленных по опорным видам, причём их не нужно выравнивать по времени с генерируемыми кадрами.
Для обучения и оценки авторы собрали два набора. Showcase-4K, корпус видео на основе 3D-ассетов: двенадцать типов движения камеры в 88 конфигурациях траекторий, с картами нормалей, полученными реконструкцией. ShowcaseBench, отложенная (не использованная при обучении) оценочная выборка, к которой приложены исходные меши и параметры камеры, с которыми отрисовано каждое видео.
По заявлению авторов, эксперименты показывают результат уровня state-of-the-art (лучший на сегодня) по сохранению идентичности объекта и 3D-согласованности при сопоставимом (competitive) качестве видео и движения. Числовых результатов в тексте нет. У проекта есть страница: justin4ai.github.io/OmniShowcase.
Ключевые факты
- OmniShowcase, метод генерации видео объекта по нескольким опорным изображениям с явным учётом 3D-структуры.
- Автоматический конвейер синтеза обучающих видео задаёт ракурсы через геометрию объекта, включая полные орбиты на 360 градусов.
- Видеомодель получает «поворотный круг» карт нормалей поверхности, восстановленных по опорным видам, без временного выравнивания с кадрами.
- Набор Showcase-4K охватывает двенадцать движений камеры в 88 конфигурациях траекторий; ShowcaseBench, отложенная оценочная выборка с исходными мешами и параметрами камеры.
- Авторы заявляют лучшие показатели по идентичности объекта и 3D-согласованности при сопоставимом качестве видео и движения; цифр нет.
Почему это важно
Сохранение внешности объекта при смене ракурса, одна из слабых сторон видеогенерации: когда камера показывает невидимые на входе стороны, модель вынуждена фантазировать. Работа атакует сразу две причины, названные авторами: отсутствие явной 3D-структуры и обучающие данные, не гарантирующие, что это один и тот же объект с разных сторон.
Кому это важно
Исследователям видеогенерации и 3D-согласованности, а также тем, кому нужны ролики с товаром или персонажем, снятые «вокруг» объекта. Наборы Showcase-4K и ShowcaseBench с мешами и параметрами камеры могут пригодиться для сравнения методов.
Как это применить
Прямого практического применения в тексте не описано. Известна лишь страница проекта: justin4ai.github.io/OmniShowcase. О публикации кода, весов или данных в источнике не сказано.
Можно ли доверять
Это описание статьи, где все утверждения о превосходстве исходят от самих авторов. Числовых результатов, названий конкурирующих методов и сравнений в тексте нет, поэтому заявление о state-of-the-art по идентичности и 3D-согласованности проверить по нему нельзя. Качество видео и движения названо лишь сопоставимым, а не лучшим.
Риски и подводные камни
Обучение построено на видео из 3D-ассетов, то есть на синтетических данных; как метод ведёт себя на реальных объектах, в тексте не сказано. Не указаны базовая видеомодель, её размер и вычислительные затраты. Размер Showcase-4K в видео не приведён.