Обучение с подкреплением редко учит нейросеть новому: разбор 20 моделей
Известно, что обучение с подкреплением по итоговому результату (outcome RL) повышает pass@1, долю задач, решённых с первой попытки, но не повышает pass@k при большом k (Yue et al., 2025). Авторы новой статьи обращают внимание на то, что любой pass@1 измеряется при ограничении на число токенов, и любой рецепт обучения тоже обучается с таким ограничением. Они спрашивают: прирост pass@1, это изменившееся поведение или новые знания?
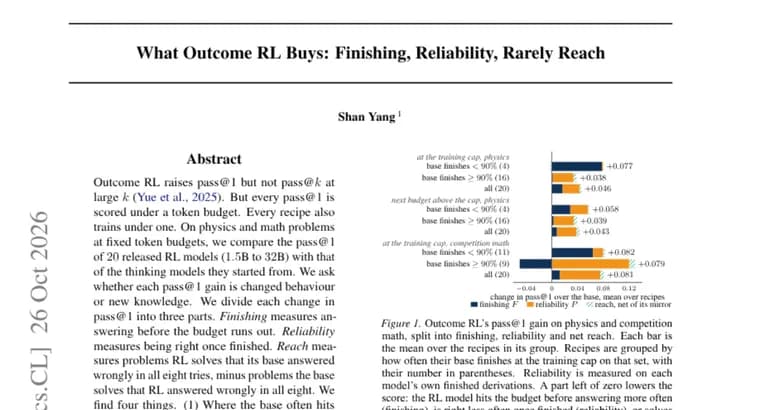
Для ответа они сравнили pass@1 у 20 опубликованных моделей, обученных с подкреплением (от 1,5 млрд до 32 млрд параметров), и у рассуждающих моделей, с которых это обучение начиналось. Сравнение шло на физических и математических задачах при фиксированных лимитах токенов. Каждое изменение pass@1 авторы делят на три части. «Доведение до ответа» (finishing), успевает ли модель ответить до исчерпания лимита. «Надёжность» (reliability), верен ли ответ, если модель ответ дала. «Охват» (reach), задачи, которые модель после RL решает, а её база неверно решила во всех восьми попытках, минус задачи, которые решает база, а RL-модель во всех восьми попытках решила неверно.
Авторы называют четыре результата. Первый: там, где база часто упирается в лимит токенов раньше, чем успевает ответить, большая часть изменения, и прироста, и падения, приходится на доведение до ответа (82% при лимитах 4k и 8k токенов). Если дать базе больше токенов, она сама закрывает большую часть этого разрыва. Второй: там, где у базы токенов хватает, прирост, это надёжность: RL-модель чаще получает верную оценку, в том числе на задачах, которые заканчивают обе модели.
Третий: по определению авторов, RL редко решает то, что не под силу базе. Охват добавляет не более 2,1 процентного пункта на любом из четырёх физико-математических наборов. Авторы проверили 144 физические задачи, которые решила только RL-модель: из них 3,5% выдерживают повторную выборку или прочтение. В случайной выборке девять из десяти новых шагов рассуждения RL, подтверждённых человеком, встречаются и в выборках базовой модели.
Четвёртый: в небольшом эксперименте с RL на модели в 8 млрд параметров прирост на новых задачах, это доведение до ответа, а надёжность не меняется. Подача физической постановки каждой задачи не показала улучшения по сравнению с обычным RL (улучшение не показано, это не то же самое, что показанный провал).
Ключевые факты
- Сравнили 20 опубликованных RL-моделей (от 1,5 млрд до 32 млрд параметров) с рассуждающими базами, с которых они стартовали; задачи по физике и математике, фиксированные лимиты токенов.
- Прирост pass@1 разложен на три части: доведение до ответа, надёжность и охват. Там, где база часто упирается в лимит, на доведение до ответа приходится 82% изменения (лимиты 4k и 8k); при большем числе токенов база сама закрывает большую часть разрыва.
- Охват добавляет не более 2,1 процентного пункта на любом из четырёх наборов; из 144 физических задач, решённых только RL-моделью, 3,5% выдерживают перепроверку.
- В малом эксперименте на модели в 8 млрд параметров прирост на новых задачах, доведение до ответа, надёжность без изменений.
Почему это важно
Обучение с подкреплением обычно подают как способ научить нейросеть рассуждать лучше. Статья предлагает более приземлённое объяснение: заметная часть прироста pass@1 связана с тем, что модель успевает ответить в рамках лимита токенов, и с более надёжными ответами. Новых способностей, по определению авторов, добавляется мало: охват не превышает 2,1 процентного пункта. Работа развивает известный вывод о том, что outcome RL повышает pass@1, но не pass@k при большом k (Yue et al., 2025).
Кому это важно
Исследователям и инженерам, которые обучают рассуждающие модели с подкреплением и оценивают их по pass@1. Также тем, кто сравнивает модели по таким метрикам и выбирает лимит токенов: при малом лимите разница между базой и RL-версией во многом отражает умение уложиться в него.
Как это применить
Практический вывод из результатов: при сравнении базовой и RL-модели стоит смотреть на прирост при разных лимитах токенов. По данным статьи, при более щедром лимите база сама закрывает большую часть разрыва в доведении до ответа. Разложение изменения pass@1 на доведение до ответа, надёжность и охват можно использовать как схему анализа, хотя в тексте статьи не указано, как получить код или данные для этого.
Можно ли доверять
Мы видим только краткое изложение работы, без перечня авторов и без названий моделей и наборов задач, поэтому проверить расчёты по тексту нельзя. Выводы относятся к четырём физико-математическим наборам и к определению охвата, которое дают сами авторы («по нашему определению»). Они не утверждают, что RL вообще не способен дать новые знания.
Риски и подводные камни
Цифра 82% дана только для лимитов 4k и 8k токенов: для больших лимитов в изложении её нет. Для случая, когда базе хватает токенов, числовая доля надёжности не названа. Эксперимент на модели в 8 млрд параметров мал по масштабу, а какой алгоритм RL в нём применялся, в изложении не сказано. Результат «подача физической постановки не показала улучшения» означает отсутствие показанного эффекта, а не доказанную бесполезность приёма.
«По нашему определению, RL редко решает то, что не под силу его базовой модели.»
— авторы статьи