NVIDIA анонсировала Nemotron-pretraining-Indic-v1: 2,8 трлн токенов на 22 языках Индии
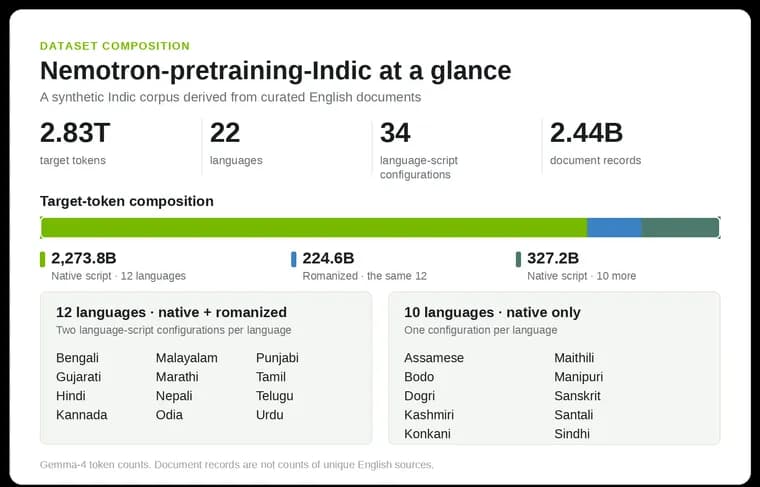
NVIDIA совместно с индийским технологическим институтом IIT Madras и его лабораторией AI4Bharat анонсировала Nemotron-pretraining-Indic-v1, синтетический корпус для предобучения примерно на 2,8 трлн токенов на 22 индийских языках. Это все языки, перечисленные в Конституции Индии; по данным переписи 2011 года, они родные для 97% жителей страны, почти 1,2 млрд человек. Корпус «выйдет в ближайшее время» вместе с открытым конвейером генерации данных на GPU, которым он создан; точной даты в тексте нет.
Корпус строится из английских исходных документов: берутся 15 подмножеств Nemotron-CC-v2 (веб-тексты, вопросы и ответы, математика, код и другое). Документы переводятся на индийские языки, а в процессе используется NeMo Data Designer, открытый фреймворк NVIDIA для генерации синтетических данных. Каждая запись прослеживается до исходного документа, а результат сверяется со входом. Конвейер содержит весь рецепт, промпты, цепочки работы с LLM и проверки качества, так что разработчики могут подставить свои исходные документы и сгенерировать больше данных. Авторы подчёркивают, что синтетика дополняет тексты, написанные носителями языков: те по-прежнему нужны для местных знаний и культурного контекста.
В корпусе 2601,0 млрд токенов на родном письме и 224,6 млрд токенов романизированного текста (запись индийского языка латиницей, а не перевод на английский); счёт ведётся токенизатором Gemma-4. Родное письмо есть для всех 22 языков, романизация, для двенадцати: бенгальского, гуджарати, хинди, каннада, малаялам, маратхи, непальского, одия, панджаби, тамильского, телугу и урду. Всего получается 34 языково-письменные конфигурации. Ещё десять языков, ассамский, бодо, догри, кашмирский, конкани, майтхили, манипури, санскрит, сантали и синдхи, представлены только родным письмом. Важная оговорка авторов: «родное письмо» здесь означает систему письменности, сам текст всё равно переведён с английского. Записи включают переводы и письменные варианты одних и тех же источников, поэтому это не число уникальных английских документов.
Для двенадцати языков документы переводят целиком моделью Gemma-4-31B-it, затем та же модель оценивает перевод по рубрике, вдохновлённой MQM (открытой системой классификации ошибок перевода: смысл, беглость, терминология, стиль, форматирование). Оставляют только результаты с оценкой не ниже 75 из 100 (это баллы рубрики, а не процент точности). Остальные исправляют по обратной связи и оценивают повторно; так вернули 438,4 млрд токенов, уже входящих в общий итог. Романизацию делают отдельным шагом, из принятых переводов на родном письме, а не напрямую с английского: по первичному сравнению с участием людей так меньше выдуманных добавок и остаточного английского. Для остальных десяти языков перевод выполняет Indic Translate, модель документного перевода от Bodhan AI (некоммерческий центр ИИ в образовании при IIT Madras), оценивает её Gemma-4-31B-it; порог тот же, 75 из 100, данные только на родном письме и без переписывания по обратной связи. Для длинных текстов на сантали перевод идёт перекрывающимися окнами, а манипури переводят сначала бенгальским письмом и затем конвертируют в мейтей-майек.
Влияние на модели показано на Nemotron 3.5 Super VL. Дополнительное предобучение (CPT) на индийских данных имело настроенный бюджет 100 млрд токенов, из них 10% (10 млрд) пришлись на смесь синтетических и естественных индийских текстов из двенадцатиязычного подмножества этого корпуса; остальные 90% сохранили пропорции прежней смеси. По сравнению с чекпойнтом до этого этапа результаты выросли на всех пяти индийских бенчмарках знаний и рассуждений, MILU, Indic MMLU-Pro, Indic ARC-Challenge, Indic ARC-Easy и Indic GSM8K, на 4,98-9,82 процентного пункта. Авторы оговаривают, что сравнение не выделяет вклад именно синтетического корпуса: этап смешивал синтетические и естественные данные. Для финальной модели Nemotron 3.5 Super VL лучше Nemotron 3 Super на пяти из шести показанных задач (знания, рассуждения, математика, код, перевод), но следование инструкциям на IFEval 1.5 просело на 2,04 пункта. Улучшились и все четыре измерения IndiVibe (открытый бенчмарк Sarvam AI из промптов в стиле ассистента на индийских языках): полезность, беглость, верность языку и письму, уместная многословность; это предварительные условные оценки предпочтения, а не прямые доли побед. Оценка полного корпуса, включая восстановленные переписанные тексты и остальные десять языков, следующий шаг контролируемых исследований. Авторы планируют опираться на корпус в будущих моделях Nemotron.
Ключевые факты
- Nemotron-pretraining-Indic-v1: примерно 2,8 трлн токенов на 22 языках из Конституции Индии, 2601,0 млрд на родном письме и 224,6 млрд романизированных (токенизатор Gemma-4); выход «в ближайшее время».
- Вместе с корпусом обещан открытый конвейер генерации: промпты, рабочие цепочки LLM и проверки качества; перевод и оценка на Gemma-4-31B-it, порог, не менее 75 из 100 по рубрике на основе MQM.
- Романизация есть для 12 языков из 22; всего 34 языково-письменные конфигурации. Тексты на родном письме, переводы с английского из 15 подмножеств Nemotron-CC-v2.
- Этап индийского CPT для Nemotron 3.5 Super VL (10 млрд индийских токенов из бюджета 100 млрд) дал рост на пяти бенчмарках на 4,98-9,82 процентного пункта, но вклад именно синтетики авторы не выделяют.
- Итоговая Nemotron 3.5 Super VL лучше Nemotron 3 Super на пяти из шести задач, при этом IFEval 1.5 снизился на 2,04 пункта.
Почему это важно
Руководитель AI4Bharat Митеш Кхапра, на которого ссылаются авторы, объясняет отставание технологий для индийских языков от английского тем, что данных для них не хватает. Анонс отвечает на это двумя вещами: большим объёмом синтетических данных и открытым рецептом, по которому их можно генерировать дальше. Важна и прозрачность: у каждой записи сохраняется идентификатор исходного документа, поэтому данные можно проверять. Оговорка: пока это анонс, сам корпус ещё не опубликован.
Кому это важно
Командам, которые обучают или дообучают модели для индийских языков и ищут объёмный материал по математике, коду и вопросам-ответам на этих языках. Также исследователям синтетических данных и машинного перевода: рецепт с оценкой по рубрике и ремонтом результатов можно изучать и повторять на своих источниках.
Как это применить
Авторы советуют после выхода выбрать нужные языки и письменности, посмотреть образец, изучить карточку датасета и лицензию перед обучением. Конфигурации обозначаются тегами языка, письма и региона: hi-Deva-IN, хинди на деванагари, hi-Latn-IN, романизированный хинди. Доступна потоковая загрузка через Hugging Face Datasets без скачивания всего корпуса; для воспроизводимости стоит зафиксировать ревизию датасета. Можно использовать корпус как есть, адаптировать промпты и проверки или подставить свои исходные документы. Условия лицензии и идентификатор репозитория в видимом тексте не названы.
Можно ли доверять
Это блог самих разработчиков (NVIDIA и AI4Bharat), цифры по приросту качества, из их же технического отчёта о Nemotron 3.5 Super VL. Авторы сами делают важные оговорки: сравнение до и после CPT не изолирует вклад синтетического корпуса, оценки IndiVibe предварительные, а полный корпус целиком в контролируемых исследованиях ещё не оценён. Выводы о том, что смесь синтетики и естественных текстов работает, подаются как поддержка рецепта, а не как окончательный ответ для других моделей и языков. Независимых проверок в тексте нет.
Риски и подводные камни
Все тексты на родном письме, переводы с английского, поэтому местные знания и культурный контекст они передают хуже написанных носителями; авторы сами говорят, что естественные тексты остаются необходимыми. Записи включают переводы и письменные варианты одних и тех же источников, и родное и романизированное письмо могут выражать одно содержание, это нужно учитывать при составлении смеси. Токены корпуса, это инвентарь, а не бюджет обучения, и числа зависят от токенизатора. Оценка 75 из 100, баллы рубрики, а не точность. У десяти языков нет романизации и переписывания по обратной связи. Рост на бенчмарках сопровождался просадкой следования инструкциям на IFEval 1.5 на 2,04 пункта у итоговой модели; сроки выхода корпуса, только «скоро».
«у нас недостаточно данных для индийских языков.»
— Митеш Кхапра, руководитель AI4Bharat (цитата приведена в блоге NVIDIA и AI4Bharat)