NAVA-WAM: робота учат действиям по видео без разметки действий
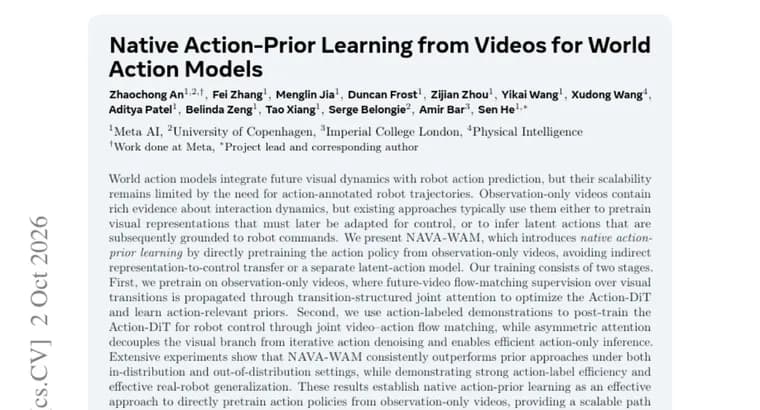
Мировые модели действий (world action models) объединяют предсказание будущей визуальной динамики с предсказанием действий робота, но их масштабирование, по словам авторов, ограничено потребностью в траекториях робота с разметкой действий. Видео без такой разметки содержат богатую информацию о динамике взаимодействий, однако существующие подходы, как пишут авторы, обычно используют их двумя способами: либо для предобучения визуальных представлений, которые потом нужно адаптировать под управление, либо для вывода скрытых (латентных) действий, которые затем приходится привязывать к командам робота.
Авторы представляют NAVA-WAM и вводят «нативное обучение априорных знаний о действиях» (native action-prior learning): политику действий предобучают напрямую на видео без разметки действий. Это позволяет обойтись без непрямого переноса «представление, управление» и без отдельной модели латентных действий.
Обучение состоит из двух этапов. На первом модель предобучается на видео без разметки: обучающий сигнал, предсказание будущего видео методом flow matching (согласование потоков) по визуальным переходам, через структурированное по переходам совместное внимание (transition-structured joint attention) передаётся в Action-DiT, и тот усваивает априорные знания, значимые для действий. На втором этапе Action-DiT дообучается для управления роботом на демонстрациях с размеченными действиями через совместный flow matching видео и действий; асимметричное внимание отделяет визуальную ветвь от итеративного шумоподавления действий и позволяет эффективно выдавать только действия.
По утверждению авторов, масштабные эксперименты показывают, что NAVA-WAM стабильно превосходит прежние подходы как в условиях, близких к обучающим (in-distribution), так и вне их (out-of-distribution), демонстрирует высокую эффективность по числу размеченных действий и эффективное обобщение на реальном роботе. Авторы делают вывод, что нативное обучение априорных знаний о действиях, эффективный способ напрямую предобучать политики действий на видео без разметки и масштабируемый путь за пределы данных робота с разметкой действий.
Ключевые факты
- NAVA-WAM, мировая модель действий, у которой политика действий предобучается напрямую на видео без разметки действий.
- Подход обходится без переноса от визуальных представлений к управлению и без отдельной модели латентных действий.
- Обучение в два этапа: предобучение на видео (flow matching по визуальным переходам), затем дообучение на демонстрациях с размеченными действиями.
- Асимметричное внимание отделяет визуальную ветвь от шумоподавления действий и даёт эффективный вывод только действий.
- Авторы заявляют стабильное превосходство над прежними подходами, эффективность по числу размеченных действий и обобщение на реальном роботе; количественных цифр в аннотации нет.
Почему это важно
Главное узкое место мировых моделей действий, нехватка траекторий робота с размеченными действиями. Идея работы в том, чтобы использовать для предобучения политики обычные видео без такой разметки напрямую, а не через промежуточные представления или латентные действия. Авторы называют это масштабируемым путём за пределы размеченных данных робота.
Кому это важно
Исследователям в области робототехники и обучения политик управления, а также тем, кто работает с мировыми моделями и диффузионными трансформерами для действий.
Как это применить
Из аннотации практических инструкций не следует: о коде, весах, наборах данных и конкретных роботах там не сказано. Схема, описанная авторами, предобучение Action-DiT на видео без разметки, затем дообучение на демонстрациях с размеченными действиями.
Можно ли доверять
Это аннотация научной статьи на странице Hugging Face Papers, все утверждения о превосходстве и обобщении принадлежат самим авторам. В тексте нет численных результатов, названий бенчмарков и базовых методов для сравнения, поэтому масштаб преимущества оценить нельзя. Авторы и организации в тексте не названы.
Риски и подводные камни
Заявления о «стабильном превосходстве» и «эффективном обобщении на реальном роботе» в аннотации не подкреплены цифрами; какие задачи и какой робот использовались, неизвестно. Ограничения и случаи неудач в тексте не описаны, так что до чтения полной статьи выводы стоит считать предварительными.