Метод WiD ускоряет обучение PixelDiT-XL: на 37,5% меньше эпох
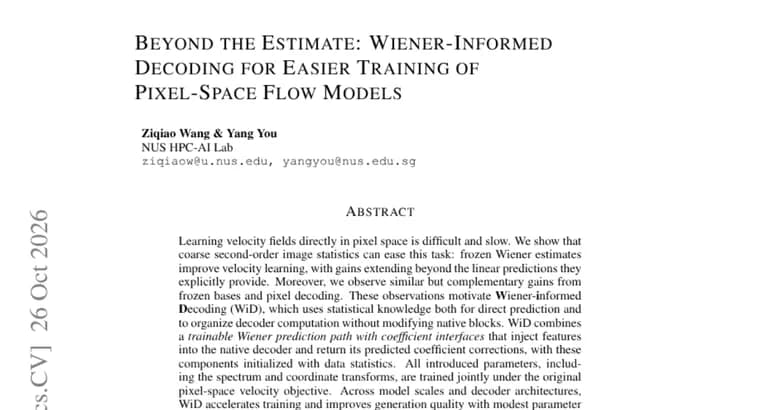
Статья из каталога Hugging Face Papers посвящена тому, что учить потоковые (flow) модели генерации изображений прямо в пиксельном пространстве трудно и медленно: приходится восстанавливать поля скоростей непосредственно по пикселям. Авторы показывают, что задачу можно облегчить грубой статистикой второго порядка по изображениям. Замороженные винеровские оценки (Wiener estimates) улучшают обучение полей скоростей, причём выигрыш выходит за рамки тех линейных предсказаний, которые эти оценки дают явно. Кроме того, авторы наблюдают схожий, но дополняющий друг друга выигрыш от замороженных базисов и от пиксельного декодирования.
Из этих наблюдений вырос метод Wiener-informed Decoding (WiD). Он использует статистические знания двумя способами: для прямого предсказания и для организации вычислений в декодере, причём штатные блоки декодера не меняются. WiD объединяет обучаемый путь винеровского предсказания с «интерфейсами коэффициентов»: они подают признаки в родной декодер и возвращают предсказанные им поправки к коэффициентам. Эти компоненты инициализируются статистикой данных. Все добавленные параметры, включая спектр и преобразования координат, обучаются совместно под исходной пиксельной целевой функцией скорости.
По заявлению авторов, на разных масштабах моделей и архитектурах декодера WiD ускоряет обучение и улучшает качество генерации при скромных дополнительных параметрах. Метод также даёт более гладкие траектории градиентов и остаётся эффективным вместе с выравниванием представлений (representation alignment). Авторы пишут, что WiD улучшает и классово-условную генерацию, и генерацию по тексту при разных разрешениях.
Главный числовой результат: на ImageNet 256 x 256 модель PixelDiT-XL с WiD достигает FID 1,53 после 500 эпох (чем ниже FID, тем лучше) и показывает качество, сопоставимое с PixelDiT, при том что эпох на обучение нужно на 37,5% меньше. Вывод авторов: статистические шумоподавители (денойзеры) полезны не только самой оценкой, их вычислительная структура тоже может облегчить обучение в пиксельном пространстве.
Ключевые факты
- WiD (Wiener-informed Decoding) использует грубую статистику второго порядка и замороженные винеровские оценки, чтобы облегчить обучение потоковых моделей в пиксельном пространстве.
- Метод не меняет штатные блоки декодера: добавляет обучаемый путь винеровского предсказания и интерфейсы коэффициентов, инициализированные статистикой данных.
- На ImageNet 256 x 256 PixelDiT-XL с WiD достигает FID 1,53 после 500 эпох.
- Качество, сопоставимое с PixelDiT, достигается при 37,5% меньшем числе эпох обучения.
- Авторы заявляют об улучшении при разных масштабах моделей, разрешениях и в генерации по тексту, а также о более гладких траекториях градиентов.
Почему это важно
Обучение моделей прямо в пиксельном пространстве, без промежуточного сжатого представления, остаётся трудным и медленным, с этого авторы и начинают. Работа предлагает способ сократить обучение: по заявлению авторов, до сопоставимого с PixelDiT качества WiD доходит за 37,5% меньше эпох. Это шаг в исследовательском направлении, а не готовый продукт.
Кому это важно
Прежде всего исследователям генеративных диффузионных и потоковых моделей, которые работают в пиксельном пространстве и интересуются архитектурой PixelDiT. Также тем, кто изучает использование классической статистики изображений (винеровских оценок) внутри нейросетевых декодеров.
Как это применить
Из текста описания видно только общую схему: к существующему декодеру добавляются обучаемый винеровский путь и интерфейсы коэффициентов, всё инициализируется статистикой данных, а обучение идёт под прежней пиксельной целью. Кода, весов и релиза в источнике не упомянуто, поэтому практическое воспроизведение потребует знакомства с полным текстом статьи.
Можно ли доверять
Все утверждения, самооценка авторов из аннотации в каталоге Hugging Face Papers. В источнике не названы ни авторы, ни организации, ни дата. Не приведены базовое значение FID для PixelDiT и число эпох, которое ему нужно для сопоставимого качества, известно лишь сокращение на 37,5%. Метрики для генерации по тексту и размер добавочных параметров («скромные») не раскрыты. Независимой проверки в материале нет.
Риски и подводные камни
Заявленный результат приведён для одной конфигурации: ImageNet 256 x 256 и модель XL. Об остальных разрешениях и размерах моделей сказано лишь общими словами. Вычислительная стоимость, время обучения и аппаратура не указаны, так что выигрыш в эпохах не обязательно переводится в выигрыш по времени или затратам. Метод добавляет параметры и компоненты, которые нужно инициализировать статистикой данных.