Метод Swift улучшает обучение диффузионных моделей без затрат при генерации
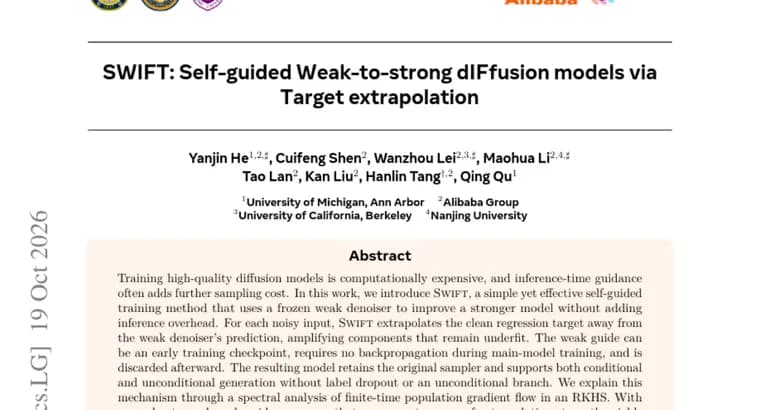
Обучать качественные диффузионные модели дорого, а управление на этапе генерации (inference-time guidance) обычно ещё и удорожает сэмплирование. В статье предложен метод Swift: простое самонаправляемое (self-guided) обучение, в котором замороженный слабый денойзер (модель, убирающая шум) помогает улучшить более сильную модель, не добавляя затрат при генерации.
Механика такая. Для каждого зашумлённого входа Swift экстраполирует целевое значение регрессии (чистое изображение) в сторону от предсказания слабого денойзера, тем самым усиливая те компоненты, которые у модели всё ещё недообучены. В роли слабого «гида» может выступать ранний чекпойнт самой модели; при обучении основной модели через него не нужно пропускать обратное распространение ошибки, а после обучения он выбрасывается.
Итоговая модель сохраняет исходный сэмплер и умеет генерировать как с условием, так и без него, без отбрасывания меток (label dropout) и без отдельной безусловной ветви. Механизм авторы объясняют спектральным анализом конечновременного популяционного градиентного потока в RKHS (воспроизводящем ядерном гильбертовом пространстве). При слабом гиде, остановленном на ранней стадии, они доказывают: существует непустой диапазон сил экстраполяции, при котором ошибка относительно апостериорного среднего строго ниже, чем у сопоставимого стандартного обучения, хотя цель сдвигается от апостериорного среднего.
Эксперименты на CIFAR-10 и ImageNet-256, по заявлению авторов, показывают улучшения для разных масштабов моделей и представлений. В одной из конфигураций ImageNet-256 Swift превосходит лучший FID базовой модели, затрачивая примерно вдвое меньше суммарных вычислений на обучение, включая подготовку гида и накладные расходы. На RAEv2 метод даёт FID 1,15 без guidance при генерации и 0,99 с ним. Вывод авторов: экстраполяция цели, эффективный подход к обучению диффузионных моделей «от слабого к сильному» с быстрой генерацией одной моделью.
Ключевые факты
- Swift, самонаправляемое обучение диффузионных моделей: замороженный слабый денойзер (например, ранний чекпойнт) используется для экстраполяции целевого значения от его предсказания.
- Дополнительных затрат при генерации нет: слабый гид после обучения отбрасывается, исходный сэмплер сохраняется, ветвь безусловной генерации и label dropout не нужны.
- В одной конфигурации ImageNet-256 Swift превзошёл лучший FID базовой модели примерно при половине суммарных вычислений на обучение (с учётом подготовки гида).
- На RAEv2 заявлен FID 1,15 без guidance при генерации и 0,99 с guidance.
- Авторы доказывают, что при слабом гиде с ранней остановкой есть диапазон сил экстраполяции, дающий строго меньшую ошибку относительно апостериорного среднего, чем стандартное обучение.
Почему это важно
Стоимость обучения диффузионных моделей и стоимость сэмплирования, две главные статьи расходов в генерации изображений. Классическое управление на этапе генерации (guidance) улучшает качество, но удорожает каждую генерацию. Swift переносит выигрыш в обучение: итоговая модель остаётся одиночной и работает с прежним сэмплером. Если заявленные результаты воспроизведутся, это путь к более дешёвому получению качественных моделей.
Кому это важно
Исследователям и инженерам, которые обучают диффузионные модели для изображений, особенно на ImageNet-подобных задачах. Тем, кого интересует сокращение затрат на генерацию без отдельной безусловной ветви. Для широкой публики материал малоинтересен: это техническая работа о методе обучения.
Как это применить
Практическая схема из аннотации: взять ранний чекпойнт обучаемой модели как слабого гида, заморозить его и при обучении основной модели сдвигать целевое значение от предсказания гида, подбирая силу экстраполяции. Гид не требует обратного распространения ошибки и после обучения удаляется. Конкретные гиперпараметры и конфигурации в аннотации не приведены, поэтому для воспроизведения нужен полный текст статьи.
Можно ли доверять
Это препринт, и источник, его аннотация; все утверждения принадлежат авторам. Значения FID для базовых моделей, размеры моделей и точная конфигурация ImageNet-256, давшая выигрыш примерно вдвое по вычислениям, в тексте не указаны. Сравнения цифр на RAEv2 с другими опубликованными моделями тоже нет. Теоретическое доказательство относится к специальной постановке (слабый гид с ранней остановкой, анализ в RKHS), так что переносить его на практические сети стоит осторожно.
Риски и подводные камни
Выигрыш в вычислениях заявлен для одной конфигурации и не обязательно воспроизводится везде. Сила экстраполяции, параметр, который нужно подбирать: теория гарантирует лишь существование подходящего диапазона. Метод требует предварительно подготовить слабый гид; его затраты авторы включили в подсчёт вычислений. Результаты получены на CIFAR-10 и ImageNet-256, а перенос на другие данные и более крупные модели в аннотации не показан.