Метод LOWN ускорил диффузионную нейросеть LLaDA-V: 35,3% вычислений при 99,6% качества
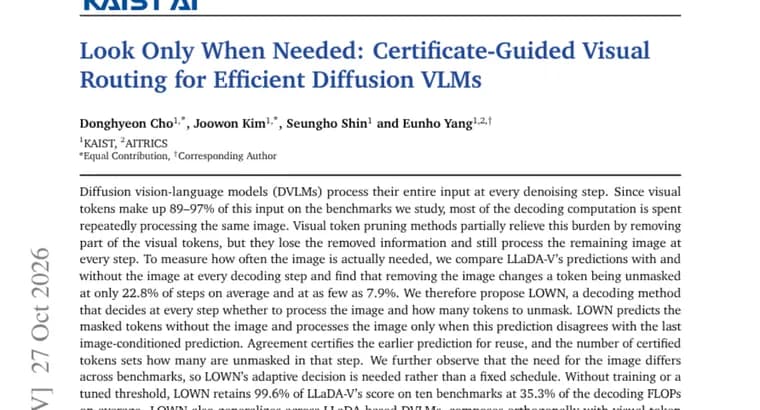
Диффузионные мультимодальные модели (DVLM), которые работают с изображением и текстом, на каждом шаге шумоподавления обрабатывают весь вход целиком. По наблюдению авторов, визуальные токены составляют 89-97% этого входа на изученных ими бенчмарках, поэтому большая часть вычислений при декодировании уходит на многократную обработку одной и той же картинки. Методы прореживания визуальных токенов (pruning) лишь частично снимают нагрузку: они теряют удалённую информацию, а оставшуюся часть изображения всё равно обрабатывают на каждом шаге.
Чтобы измерить, как часто изображение действительно нужно, авторы на каждом шаге декодирования сравнили предсказания LLaDA-V с изображением и без него. Оказалось, что удаление картинки меняет раскрываемый токен лишь на 22,8% шагов в среднем, а в минимуме, на 7,9%.
На этом наблюдении построен LOWN, метод декодирования, который на каждом шаге решает, обрабатывать ли изображение и сколько токенов раскрывать. LOWN предсказывает замаскированные токены без изображения и обращается к картинке только тогда, когда это предсказание расходится с последним предсказанием, сделанным с учётом изображения. Совпадение «заверяет» прежнее предсказание для повторного использования, а число заверенных токенов определяет, сколько токенов раскрывается на этом шаге. Авторы также отмечают, что потребность в изображении различается между бенчмарками, поэтому нужно адаптивное решение, а не фиксированное расписание.
Без дообучения и подбираемого порога LOWN сохраняет 99,6% оценки LLaDA-V на десяти бенчмарках при 35,3% вычислений (FLOPs) декодирования в среднем. По утверждению авторов, метод обобщается на другие DVLM на основе LLaDA, ортогонально сочетается с прореживанием визуальных токенов и работает с кэшированием ключей и значений (key-value caching), давая дополнительный выигрыш в эффективности. Код и страница проекта доступны по ссылке https://hyeon9698.github.io/LOWN/.
Ключевые факты
- Визуальные токены занимают 89-97% входа диффузионных мультимодальных моделей на изученных бенчмарках, но изображение нужно далеко не на каждом шаге.
- Удаление картинки меняет раскрываемый токен у LLaDA-V лишь на 22,8% шагов в среднем и на 7,9% в минимуме.
- LOWN сравнивает предсказание без изображения с последним предсказанием с изображением и обрабатывает картинку только при расхождении.
- Без обучения и настраиваемого порога метод сохраняет 99,6% оценки LLaDA-V на десяти бенчмарках при 35,3% FLOPs декодирования в среднем.
- Метод, по словам авторов, сочетается с прореживанием визуальных токенов и кэшированием ключей и значений; код опубликован.
Почему это важно
Диффузионные мультимодальные модели тратят основную часть вычислений на повторную обработку одной и той же картинки на каждом шаге. LOWN показывает, что в значительной доле шагов изображение не меняет результат, и это позволяет сократить затраты на декодирование до 35,3% от исходных при почти неизменном качестве (99,6% оценки LLaDA-V).
Кому это важно
Исследователям и инженерам, работающим с диффузионными мультимодальными моделями на основе LLaDA, а также тем, кого интересует эффективный вывод (инференс) мультимодальных систем.
Как это применить
Метод не требует обучения и подбора порога, то есть его можно применять на этапе декодирования к существующей модели. Авторы пишут, что он работает вместе с прореживанием визуальных токенов и кэшированием ключей и значений. Код и страница проекта доступны: https://hyeon9698.github.io/LOWN/.
Можно ли доверять
Это препринт, представленный на Hugging Face Papers; цифры, заявления самих авторов. Результаты 99,6% и 35,3% приведены для LLaDA-V как усреднённые по десяти бенчмаркам; результаты по отдельным бенчмаркам и их названия в тексте не указаны. Код опубликован, что позволяет проверить результаты.
Риски и подводные камни
Экономия оценена в FLOPs декодирования, а не во времени работы или задержке, реальное ускорение может отличаться. Потребность в изображении различается между бенчмарками, поэтому выигрыш будет неодинаковым. Величина дополнительного выигрыша от прореживания и кэширования не количественно оценена.