LOOM: способ довести зацикленные MoE-модели до 9, 12 циклов вместо двух
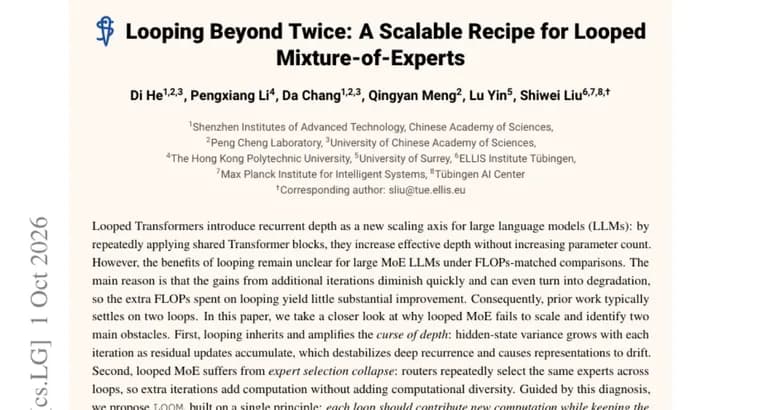
Зацикленные (looped) трансформеры повторно применяют одни и те же общие блоки, поэтому наращивают эффективную глубину без роста числа параметров. Для больших моделей со смесью экспертов (Mixture-of-Experts, MoE) польза от такого зацикливания при сравнении по одинаковым затратам вычислений (FLOPs) остаётся неясной. По словам авторов, выигрыш от каждой следующей итерации быстро падает и может смениться ухудшением, поэтому предыдущие работы обычно останавливаются на двух циклах.
Авторы называют две причины. Первая: зацикливание наследует и усиливает «проклятие глубины». Дисперсия скрытых состояний растёт с каждой итерацией по мере накопления остаточных обновлений, из-за чего глубокая рекурсия теряет устойчивость, а представления «дрейфуют». Вторая: в looped MoE происходит схлопывание выбора экспертов. Маршрутизаторы раз за разом выбирают одних и тех же экспертов на разных циклах, и дополнительные итерации добавляют вычисления, но не их разнообразие.
На основе этого диагноза предложен рецепт LOOM с одним принципом: каждый цикл должен вносить новые вычисления, сохраняя устойчивость рекуррентного состояния. Устойчивость достигается масштабированием остаточных обновлений, которое ограничивает рост дисперсии, и повторной подачей входного эмбеддинга на каждом цикле. Разнообразие обеспечивают отдельные маршрутизаторы для каждого цикла, подключающие разных экспертов, и «Looping Residual», который переносит вперёд выходы предыдущих циклов.
Эксперименты на моделях от 100M до 1,7B параметров показали стабильное масштабирование до 9, 12 циклов. При почти равных вычислительных затратах (near-iso-FLOP) модель на 700M лучше всего работает на 5 циклах: перплексия снижается с 18,36 до 16,54 по сравнению с обычной моделью без циклов, а средняя точность zero-shot растёт с 38,84% до 39,53%. Без выравнивания по FLOPs модель на 1,7B, обученная на 60B токенов, достигает пика на 9 циклах: перплексия падает с 9,62 до 7,77, средняя точность zero-shot растёт с 42,4% до 47,7%. Код опубликован на GitHub (hed-ucas/LOOM).
Ключевые факты
- Две причины, по которым looped MoE упирается в два цикла, по диагнозу авторов: рост дисперсии скрытых состояний с каждой итерацией и схлопывание выбора экспертов (одни и те же эксперты на всех циклах).
- LOOM стабилизирует рекурсию масштабированием остаточных обновлений и повторной подачей входного эмбеддинга на каждом цикле, а разнообразие даёт через отдельные маршрутизаторы на каждый цикл и Looping Residual.
- На моделях 100M, 1,7B параметров получено стабильное масштабирование до 9, 12 циклов.
- Модель на 700M при почти равных FLOPs и 5 циклах: перплексия 18,36 → 16,54, средняя точность zero-shot 38,84% → 39,53% относительно модели без циклов.
- Модель на 1,7B (60B токенов, без выравнивания по FLOPs) на 9 циклах: перплексия 9,62 → 7,77, средняя точность zero-shot 42,4% → 47,7%.
Почему это важно
Зацикленные трансформеры обещают наращивать глубину без роста числа параметров, но для MoE-моделей этот путь упирался в два цикла: дальше выигрыш быстро затухал или превращался в ухудшение. Статья разбирает две конкретные причины и предлагает рецепт, который, по сообщению авторов, позволяет масштабироваться до 9, 12 циклов на моделях 100M, 1,7B параметров. Это попытка сделать число циклов ещё одной осью масштабирования для MoE.
Кому это важно
Исследователям архитектур языковых моделей, которые работают со смесью экспертов и рекуррентной глубиной, а также командам, ищущим способы получить качество без увеличения числа параметров. Для практиков это пока материал для наблюдения: результаты получены на моделях до 1,7B параметров.
Как это применить
Код LOOM опубликован на GitHub (hed-ucas/LOOM), так что рецепт можно воспроизвести. Ключевые элементы для переноса: масштабирование остаточных обновлений, повторная подача входного эмбеддинга на каждом цикле, отдельный маршрутизатор на каждый цикл и Looping Residual. По результатам статьи число циклов подбирается под размер модели и бюджет: у модели на 700M лучший результат при почти равных FLOPs достигнут на 5 циклах, у модели на 1,7B без выравнивания по FLOPs пик пришёлся на 9 циклов.
Можно ли доверять
Это аннотация научной статьи, цифры взяты из неё и не проверены независимо. В аннотации не названы бенчмарки, по которым считается «средняя точность zero-shot». Результат на 700M получен при почти равных вычислительных затратах, а более заметный прирост модели на 1,7B (с 42,4% до 47,7%) получен без выравнивания по FLOPs, поэтому два результата нельзя сравнивать как равные. Приросты точности приведены как уровни до и после, а не как относительный рост.
Риски и подводные камни
Протестированы модели не крупнее 1,7B параметров; формулировка про «большие MoE-модели» описывает постановку проблемы, а не проверенные размеры. Не указано, на каком размере достигнуто 12 циклов и работают ли 9, 12 циклов для всех размеров. Для модели на 700M прирост точности невелик (38,84% → 39,53%) при заметном снижении перплексии. Данных о задержках, памяти и оборудовании в источнике нет, поэтому практическую цену дополнительных циклов оценить по нему нельзя.
«Каждый цикл должен вносить новые вычисления, сохраняя при этом устойчивость рекуррентного состояния.»
— авторы статьи о LOOM