Латентные языки белков PLL и SLL помогают трансформерам генерировать белки
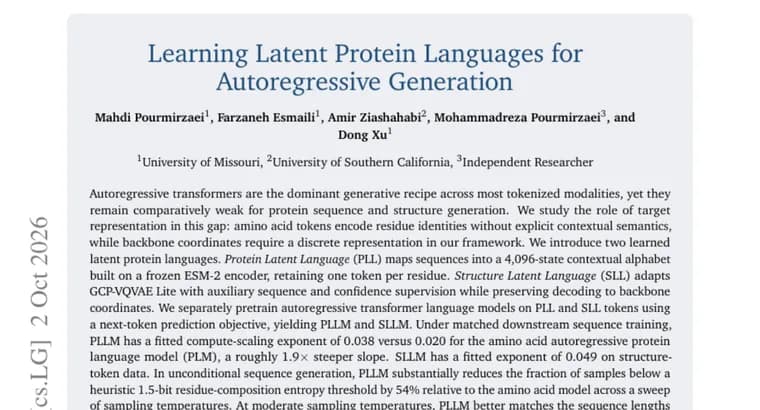
Авторы статьи исходят из того, что авторегрессионные трансформеры пока сравнительно слабы в генерации белковых последовательностей и структур. Они изучают роль целевого представления: аминокислотные токены кодируют только идентичность остатка и не несут явной контекстной семантики, а координаты остова белка в их подходе нужно переводить в дискретное представление.
Для этого предложены два обученных латентных языка. Protein Latent Language (PLL) переводит последовательность в контекстный алфавит из 4096 состояний, построенный на замороженном энкодере ESM-2; на каждый остаток приходится один токен. Structure Latent Language (SLL) адаптирует GCP-VQVAE Lite: добавлены вспомогательный контроль по последовательности и по уверенности, при этом сохраняется декодирование в координаты остова. Затем отдельно обучены авторегрессионные трансформеры на токенах PLL и SLL с предсказанием следующего токена. Получились модели PLLM и SLLM.
Результаты, которые приводят авторы. При сопоставимом обучении на последовательностях подобранный показатель масштабирования по вычислениям у PLLM равен 0,038 против 0,020 у авторегрессионной модели на аминокислотах. В безусловной генерации последовательностей PLLM при разных температурах сэмплирования на 54% (в относительном выражении) сокращает долю образцов, у которых энтропия аминокислотного состава ниже эвристического порога в 1,5 бита. В задаче предсказания структуры по последовательности замена исходного токенизатора GCP-VQVAE Lite на SLL при сопоставимом обучении снижает лучшую перплексию на валидации на 34%. Для длинных белков сэмплирование латентных токенов, по измерениям авторов, примерно в 1000 раз быстрее AlphaFold2 на основе MSA. В генерации остова SLLM, как пишут авторы, выгодно выглядит на фоне других генеративных моделей по разнообразию и новизне. Кроме того, есть ранние признаки того, что использование внутренней уверенности SLLM по токенам при сэмплировании на этапе вывода может улучшить качество предсказания структуры по сравнению с одним декодированным образцом.
Вывод авторов: обученные латентные языки белков, многообещающая основа для масштабирования авторегрессионных трансформеров и сэмплирования на этапе вывода при генерации белков.
Ключевые факты
- PLL кодирует последовательность контекстным алфавитом из 4096 состояний на замороженном энкодере ESM-2, один токен на остаток; SLL адаптирует GCP-VQVAE Lite и сохраняет декодирование в координаты остова.
- Показатель масштабирования по вычислениям у PLLM 0,038 против 0,020 у аминокислотной авторегрессионной модели при сопоставимом обучении.
- PLLM на 54% (относительно) сократила долю образцов ниже эвристического порога энтропии 1,5 бита; SLL снизил лучшую валидационную перплексию на 34% по сравнению с исходным токенизатором.
- Для длинных белков сэмплирование латентных токенов примерно в 1000 раз быстрее AlphaFold2 на основе MSA, по собственным измерениям авторов.
- Использование внутренней уверенности SLLM при сэмплировании пока показывает лишь ранние признаки улучшения предсказания структуры.
Почему это важно
Идея работы в том, что качество авторегрессионных трансформеров в белковой генерации зависит от того, на каком «языке» они предсказывают следующий токен. По утверждению авторов, обученные контекстные токены дают более крутое масштабирование по вычислениям, чем обычные аминокислотные, и быстрое сэмплирование. Это аргумент в пользу того, что подход «языковых моделей» для белков можно улучшать через представление данных, а не только через размер модели.
Кому это важно
Исследователям, которые работают с генеративными моделями белков и предсказанием структуры, а также тем, кто следит за переносом авторегрессионных трансформеров в биологию. Для широкого читателя это пока исследовательский результат, а не готовый продукт.
Как это применить
Напрямую применять пока нечего: о выпуске кода или весов в тексте не сказано. Практическая ценность для специалистов состоит в идее: взять замороженный энкодер белков (здесь ESM-2) как источник дискретного алфавита и обучать трансформер на его токенах; для структур, дискретизировать координаты остова с помощью адаптированного GCP-VQVAE Lite.
Можно ли доверять
Это аннотация статьи с Hugging Face Papers; все цифры, собственные результаты авторов, независимой проверки в тексте нет. Авторы, организации и площадка публикации в тексте не названы. Ускорение примерно в 1000 раз заявлено только для длинных белков и только относительно AlphaFold2 на основе MSA, без указания оборудования и длин белков. Проценты 54% и 34%, относительные снижения, абсолютные базовые значения не приведены. Порог в 1,5 бита назван эвристическим.
Риски и подводные камни
Быстрее не значит так же точно: в тексте не сказано, что качество предсказания структуры сопоставимо с AlphaFold2, сравнивается только скорость сэмплирования. Результат по разнообразию и новизне генерации остова дан без чисел и без названий моделей для сравнения. Эффект от использования уверенности SLLM при сэмплировании описан лишь как ранние признаки. Размеры моделей, наборы данных и вычислительные затраты в тексте не указаны, поэтому масштабируемость трудно оценить за пределами заявленных показателей.