LatentGRM: модель-судья выносит оценки без текста, время работы падает в 6, 7 раз
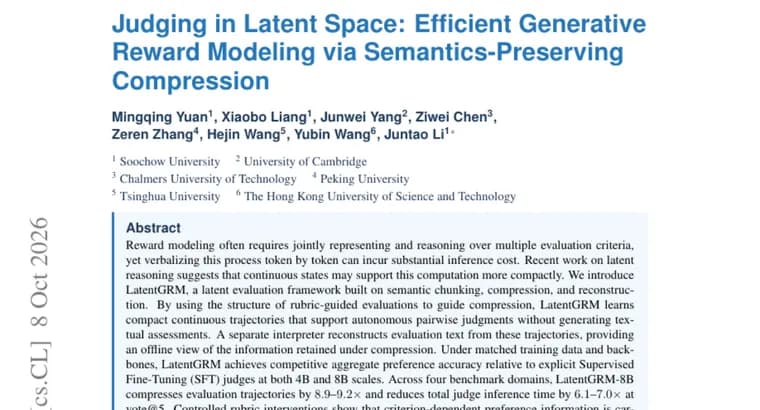
В статье представлена LatentGRM, латентная (работающая в скрытом пространстве) схема оценки для генеративных моделей вознаграждения, то есть нейросетей-судей, которые сравнивают ответы и выбирают лучший. Исходная проблема: чтобы оценить ответ сразу по нескольким критериям, судья обычно проговаривает рассуждение токен за токеном, и это заметно увеличивает стоимость вывода. Опираясь на работы о латентных рассуждениях, авторы предположили, что непрерывные состояния могут выполнять те же вычисления компактнее.
LatentGRM построена на трёх операциях: семантическом разбиении на фрагменты, сжатии и реконструкции. Структура оценок по рубрике (заранее заданному набору критериев) используется, чтобы направлять сжатие. В итоге модель учится компактным непрерывным траекториям, на основе которых самостоятельно выносит попарные суждения о предпочтении, не генерируя текстовых оценок. Отдельный интерпретатор может восстановить текст оценки из этих траекторий, это даёт офлайн-представление о том, какая информация сохраняется при сжатии.
Результаты. При одинаковых обучающих данных и базовых моделях LatentGRM показывает конкурентную совокупную точность предпочтений по сравнению с явными судьями, дообученными по схеме SFT (контролируемое дообучение), на масштабах 4B и 8B. На четырёх тестовых областях версия LatentGRM-8B сжимает траектории оценки в 8,9-9,2 раза и сокращает общее время вывода судьи в 6,1-7,0 раза при настройке vote@5. Это диапазоны по областям, а не единые цифры.
Отдельно авторы проверили, что информация о критериях действительно проходит через латентную последовательность: контролируемые вмешательства в рубрику показывают, что зависящая от критерия информация о предпочтениях переносится по ней. Общий вывод авторов: непрерывная латентная оценка может существенно снизить стоимость вывода, сохраняя конкурентное качество суждений.
Ключевые факты
- LatentGRM, судья-модель, которая выносит попарные суждения о предпочтении в скрытом пространстве, не генерируя текстовых оценок.
- Метод строится на семантическом разбиении, сжатии и реконструкции; сжатие направляется структурой оценок по рубрике.
- LatentGRM-8B сжимает траектории оценки в 8,9, 9,2 раза и сокращает общее время вывода судьи в 6,1, 7,0 раза при vote@5 (диапазоны по четырём тестовым областям).
- При одинаковых данных и базовых моделях точность предпочтений названа конкурентной относительно явных SFT-судей на 4B и 8B; превосходство не заявлено.
- Отдельный интерпретатор восстанавливает текст оценки из траекторий, чтобы офлайн увидеть, какая информация сохранилась.
Почему это важно
Модели-судьи широко используются, чтобы оценивать ответы по нескольким критериям, а проговаривание рассуждения токен за токеном делает такую оценку дорогой. LatentGRM показывает путь, при котором судья не пишет текст оценки вовсе, а работает с компактными непрерывными состояниями. По заявлению авторов, это снижает время вывода в 6,1-7,0 раза у версии 8B при vote@5 без заметной потери конкурентного качества суждений.
Кому это важно
Прежде всего тем, кто занимается моделированием вознаграждения и автоматической оценкой ответов нейросетей: командам, которые обучают судей и платят за их многократный вывод. Также работа интересна исследователям латентных рассуждений как ещё один пример переноса вычислений из текста в непрерывные состояния.
Как это применить
Прямого практического рецепта в аннотации нет: выпуск кода, модели или набора данных там не упоминается. Практически полезна сама идея, направлять сжатие структурой рубрики и обучать судью на компактных траекториях, а текстовую расшифровку получать отдельным интерпретатором только для анализа. Прежде чем опираться на метод, стоит дождаться полного текста статьи и проверить результаты на своих критериях.
Можно ли доверять
Все цифры приведены самими авторами в аннотации и пока не подтверждены независимо. Абсолютные значения точности не названы: качество описано лишь как «конкурентное» относительно явных SFT-судей, а не как лучшее. Показатели сжатия и ускорения указаны только для LatentGRM-8B. Названия четырёх тестовых областей, базовых моделей и конкретных SFT-эталонов в аннотации не приведены, поэтому оценить силу сравнения по ней нельзя.
Риски и подводные камни
Конкурентная точность не означает превосходства, и вывод о сохранённом качестве опирается на сравнение только с явными SFT-судьями на масштабах 4B и 8B. Диапазоны 8,9-9,2 раза и 6,1-7,0 раза относятся к четырём областям и режиму vote@5; в других условиях выигрыш может отличаться. Сравнение с судьями, не обученными по схеме SFT, и с другими методами латентных рассуждений в аннотации не приводится. Суждения судьи не выражены текстом, поэтому причины оценки доступны только через отдельный интерпретатор, который даёт офлайн-представление о сохранённой информации.
«Вместе эти результаты демонстрируют, что непрерывная латентная оценка может существенно снизить стоимость вывода, сохраняя конкурентное качество суждений.»
— Из аннотации статьи о LatentGRM