JevAgentHarness: малая модель 4B выбирает инструменты за ИИ-агента вместо большой LLM
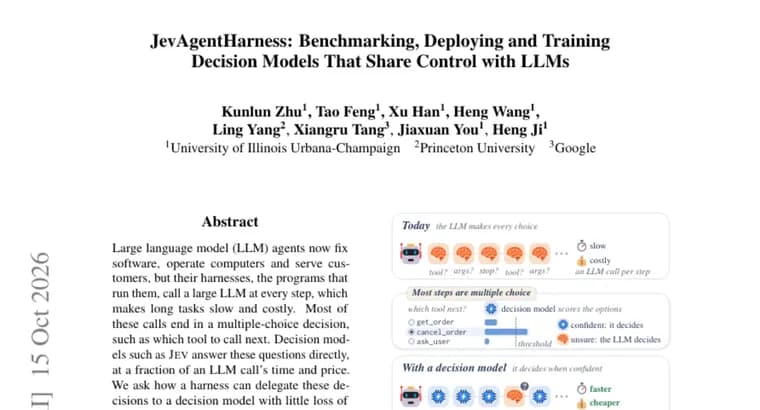
Обычно «обвязка» (harness) ИИ-агента, то есть программа, которая его запускает, вызывает большую языковую модель на каждом шаге. Из-за этого длинные задачи получаются медленными и дорогими. Авторы препринта отмечают, что большинство таких вызовов заканчивается выбором из нескольких вариантов, например какой инструмент вызвать следующим. Такие вопросы напрямую решают «модели решений» (decision models), например Jev: они отвечают на эти вопросы за долю времени и цены вызова LLM. Вопрос работы: как передать эти решения малой модели с небольшой потерей успешности.
Для оценки авторы собрали бенчмарк AgentDecisionBench. Он проверяет модели решений от изолированных вопросов до управления работающим агентом; в нём используются публичные бенчмарки и собственная среда DecisionGym. Первый результат: модель решений, самая точная на изолированных вопросах, решила только 69,5% агентных задач. Второй: если делегировать выбор инструментов без подобранного порога уверенности, успешность падает на 19,0 пункта.
На этих выводах построен JevAgentHarness. Он подбирает порог уверенности отдельно для каждого варианта выбора по собственным траекториям агента, а ниже порога решение остаётся за LLM.
Ещё одна проблема: существующие модели решений никогда не видят состояний, в которые агент попадает после собственных ошибок. Поэтому авторы обучили AgentDecision-4B, открытую модель размером 4B, на таких состояниях; метками служили ответы Jev.
Результаты. На задачах, непохожих на обучающие данные, агент с AgentDecision-4B решил 91,5% задач, а с Jev, 82,0%. На задачах, похожих на обучающие, 4B-модели, обученные таким способом, сделали агентов на 81,1-89,0% дешевле и до 2,5 раза быстрее, не потеряв 3 или более пунктов успешности. Модели, данные и обвязку обещают опубликовать на GitHub (в тексте это сформулировано в будущем времени).
Ключевые факты
- Идея: большинство вызовов LLM в обвязке агента заканчиваются выбором из вариантов (например, какой инструмент вызвать), и их можно отдать малой модели решений.
- Самая точная на изолированных вопросах модель решений решила лишь 69,5% агентных задач; делегирование выбора инструментов без подобранного порога уверенности снижало успешность на 19,0 пункта.
- JevAgentHarness подбирает порог уверенности для каждого варианта выбора по траекториям самого агента; ниже порога решает LLM.
- На задачах, непохожих на обучающие, агент с AgentDecision-4B решил 91,5% против 82,0% с Jev.
- На задачах, похожих на обучающие, 4B-модели сделали агентов на 81,1-89,0% дешевле и до 2,5 раза быстрее без потери 3 и более пунктов успешности.
Почему это важно
Стоимость и скорость длинных агентных задач упираются в то, что большая LLM вызывается на каждом шаге. Работа показывает, как заменить часть этих вызовов малой моделью и не потерять в успешности. Ключевой вывод: простая подстановка не работает, потому что делегирование выбора инструментов без порога уверенности снижало успешность на 19,0 пункта, а лучшая по точности на изолированных вопросах модель решила лишь 69,5% агентных задач. Выигрыш даёт порог, подобранный на траекториях самого агента, и обучение на состояниях после ошибок агента.
Кому это важно
Тем, кто строит или запускает ИИ-агентов с длинными цепочками шагов и считает деньги и время на вызовы большой LLM. Также исследователям, оценивающим модели решений: AgentDecisionBench проверяет их не только на изолированных вопросах, но и в управлении работающим агентом.
Как это применить
Подход состоит в том, чтобы вынести из LLM выбор из заданных вариантов (например, следующий инструмент), поручить его малой модели решений, а для каждого варианта подобрать порог уверенности на собственных траекториях агента. Когда уверенность ниже порога, решает LLM. Авторы заявляют, что модели, данные и обвязка будут опубликованы на GitHub (JevAgentHarness/JevAgentHarness); в тексте это сформулировано в будущем времени, так что готовность к использованию нужно проверять отдельно.
Можно ли доверять
Это препринт, опубликованный на странице Hugging Face; результаты приведены самими авторами, независимой проверки в материале нет. Цифры конкретны (91,5% и 82,0%, 81,1-89,0%, до 2,5 раза), но в тексте не названы публичные бенчмарки, использованные LLM и число задач, а база сравнения для экономии стоимости и скорости не указана. Экономия 81,1-89,0% и ускорение относятся к задачам, похожим на обучающие данные, а сравнение 91,5% с 82,0% относится к задачам, непохожим на них.
Риски и подводные камни
Самые громкие цифры по стоимости и скорости получены на задачах, похожих на обучающие данные, поэтому переносить их на произвольные задачи нельзя. Сам результат показывает цену ошибки: без подобранного порога успешность падает на 19,0 пункта. Код, модели и данные заявлены как будущие публикации, поэтому воспроизвести результаты сейчас может быть нельзя.