Исследователи представили TPPO: вариант PPO дал +7,0 и +8,4 пункта на математике у Qwen3
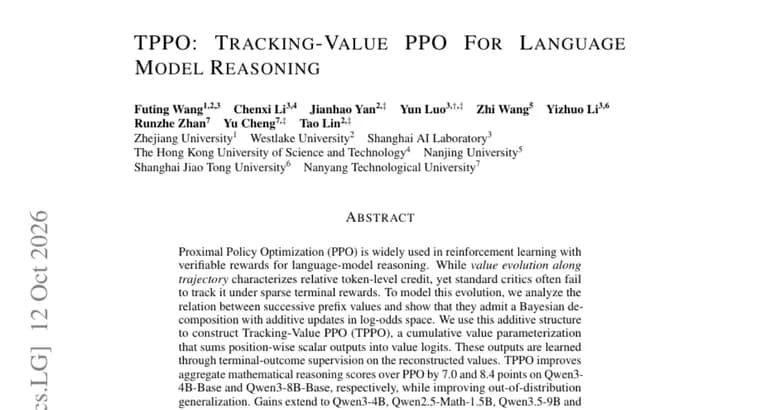
Proximal Policy Optimization (PPO) широко применяют в обучении с подкреплением с проверяемыми вознаграждениями, когда нейросеть учат рассуждать, а правильность ответа можно проверить автоматически. Авторы работы отмечают: при редких вознаграждениях, которые выдаются только по итогу всей цепочки, обычные критики (модели, оценивающие ценность состояния) плохо отслеживают, как ценность меняется по ходу траектории. Эта динамика, по их словам, как раз показывает относительный вклад отдельных токенов.
Чтобы смоделировать такую динамику, авторы анализируют связь между ценностями последовательных префиксов и показывают, что она допускает байесовское разложение с аддитивными обновлениями в пространстве логарифма шансов (log-odds). На этой аддитивной структуре построен Tracking-Value PPO (TPPO): кумулятивная параметризация ценности, в которой скалярные выходы по позициям суммируются в логиты ценности. Сами выходы обучаются с помощью супервизии по итоговому исходу на восстановленных значениях ценности.
Главный результат: TPPO улучшает агрегированные оценки математических рассуждений по сравнению с PPO на 7,0 пункта на Qwen3-4B-Base и на 8,4 пункта на Qwen3-8B-Base, а также улучшает обобщение на данные вне обучающего распределения. Прирост, по утверждению авторов, распространяется на Qwen3-4B, Qwen2.5-Math-1.5B, Qwen3.5-9B, а также на задачи countdown и научного программирования. Дополнительный анализ, как сказано в аннотации, показывает более точное отслеживание изменения ценности и более надёжные оценки преимущества (advantage). Код выложен на GitHub в репозитории LINs-lab/TPPO.
Ключевые факты
- TPPO, вариант PPO для обучения рассуждению с проверяемыми вознаграждениями: критик строится как кумулятивная сумма скалярных выходов по позициям, формирующих логиты ценности.
- Основа метода, байесовское разложение ценностей последовательных префиксов с аддитивными обновлениями в пространстве логарифма шансов.
- Прирост агрегированных оценок математических рассуждений над PPO: 7,0 пункта на Qwen3-4B-Base и 8,4 пункта на Qwen3-8B-Base (абсолютная разница в пунктах).
- Авторы также сообщают об улучшении обобщения вне распределения и о приросте на Qwen3-4B, Qwen2.5-Math-1.5B, Qwen3.5-9B, а также на задачах countdown и научного программирования.
- Код опубликован на GitHub в репозитории LINs-lab/TPPO.
Почему это важно
PPO остаётся одним из основных алгоритмов обучения рассуждению с проверяемыми вознаграждениями, а слабое место обычных критиков при редких итоговых вознаграждениях, трудность оценить вклад отдельных шагов цепочки. TPPO предлагает конкретный способ перестроить критика под эту задачу. Заявленный прирост в 7,0 и 8,4 пункта над PPO на математике заметен, но это данные самих авторов.
Кому это важно
Прежде всего исследователям и инженерам, которые обучают языковые модели рассуждению методами обучения с подкреплением и используют PPO как базовый метод. Остальным читателям работа интересна как пример того, что в связке «критик плюс PPO» ещё остаётся пространство для улучшений.
Как это применить
Код опубликован: репозиторий LINs-lab/TPPO на GitHub. Идея метода, не менять общую схему PPO, а заменить параметризацию критика на кумулятивную сумму позиционных скалярных выходов, которые превращаются в логиты ценности и обучаются по итоговому исходу. Условий лицензирования и требований к вычислениям в аннотации нет, поэтому перед использованием их стоит смотреть в самом репозитории.
Можно ли доверять
Это аннотация научной статьи со страницы Hugging Face Papers: все цифры, заявления авторов, независимая проверка в тексте не приводится. Приросты указаны как разница в пунктах относительно PPO, абсолютные значения оценок и состав «агрегированных оценок» в аннотации не раскрыты. Положительный момент, код выложен публично, так что результаты можно проверить воспроизведением.
Риски и подводные камни
В аннотации сравнение приведено только с PPO: других методов обучения с подкреплением она не упоминает. Не указаны размер прироста на других моделях и задачах, величина улучшения обобщения вне распределения, а также вычислительные затраты и скорость обучения по сравнению с PPO. Результаты относятся к конкретным моделям семейств Qwen3, Qwen2.5-Math и Qwen3.5, и переносимость на другие модели и задачи нужно проверять отдельно.