Исследователи предложили учить генерацию изображений в два этапа: авторегрессия, затем диффузия
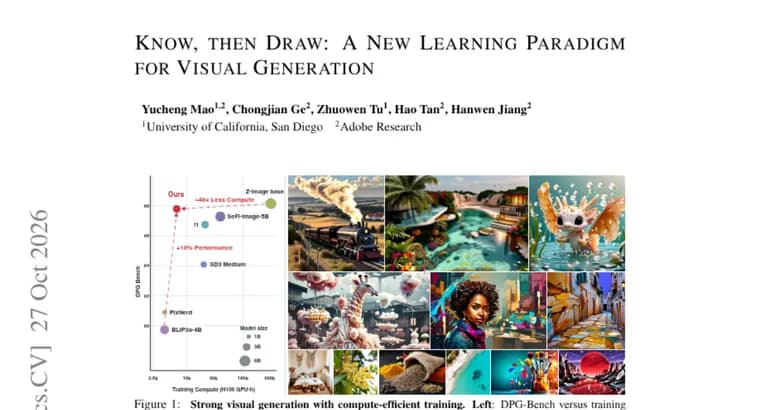
Авторы статьи исходят из того, что для генерации изображений нужны и высокоуровневые смысловые знания, и тонкие пиксельные детали. Они предлагают разделить эти роли: авторегрессионное предобучение отвечает за получение знаний, а диффузионное дообучение (post-training), за высокоточную отрисовку.
В рамках этой схемы авторы изучают цель обучения, представление данных и масштабирование как для этапа знаний, так и для этапа отрисовки. Контролируемые сравнения, по их словам, показывают, что авторегрессия, более сильная цель предобучения для последующей отрисовки: она повышает и эффективность обучения, и итоговое качество генерации.
Ещё одно наблюдение авторов: качество генерации одной лишь авторегрессионной моделью не обязательно коррелирует с итоговым результатом, а важнее оказывается смысловое (семантическое) качество. Отсюда идея чисто семантического токенизатора, обученного только на языковой разметке, без декодера изображений и без потери на реконструкцию.
Авторы также выводят оптимальные по вычислениям законы масштабирования для этапов получения знаний и отрисовки. Согласно им, авторегрессионное предобучение снижает подогнанную асимптотическую потерю отрисовки по сравнению с пиксельными диффузионными моделями, обученными с нуля.
Исходя из этих законов, авторы обучили модель «текст, изображение» на 3 млрд параметров, затратив всего 6 600 GPU-часов H100. Она набрала 86 на GenEval и 87 на DPG-Bench, что, по утверждению авторов, подтверждает предложенную схему в большом масштабе.
Ключевые факты
- Схема разделяет роли: авторегрессионное предобучение даёт знания, диффузионная доводка, высокоточную отрисовку.
- Контролируемые сравнения, по словам авторов, выявили авторегрессию как более сильную цель предобучения для последующей отрисовки.
- Качество генерации только авторегрессионной частью не обязательно связано с итогом; важнее семантическое качество, поэтому предложен чисто семантический токенизатор без декодера изображений и потери на реконструкцию.
- Выведены законы масштабирования; авторегрессионное предобучение снижает подогнанную асимптотическую потерю отрисовки относительно пиксельных диффузионных моделей, обученных с нуля.
- Модель на 3 млрд параметров обучена за 6 600 GPU-часов H100 и набрала 86 на GenEval и 87 на DPG-Bench.
Почему это важно
Работа предлагает альтернативу привычному обучению диффузионных моделей с нуля: сначала освоить смысл сцены авторегрессионно, потом доводить детали диффузией. Если выводы авторов верны, это способ получать качественную генерацию при скромных затратах: заявленные 6 600 GPU-часов H100 для модели на 3 млрд параметров.
Кому это важно
Исследователям генеративных моделей изображений и командам, обучающим собственные модели «текст, изображение» с ограниченными вычислительными ресурсами. Также будет интересно тем, кто занимается токенизацией изображений и законами масштабирования.
Как это применить
Напрямую, пока никак: в описании не упомянуты ни код, ни веса модели. Идеи можно учесть при проектировании собственных моделей: двухэтапное обучение и токенизатор, обученный только на языковой разметке, без декодера и потери на реконструкцию.
Можно ли доверять
Это описание научной статьи со страницы Hugging Face; все утверждения принадлежат авторам и в тексте не проверены независимо. Шкалы GenEval и DPG-Bench не указаны, сравнений с другими названными моделями нет, поэтому оценить место результата среди конкурентов по этому тексту нельзя. Размер снижения асимптотической потери тоже не приведён.
Риски и подводные камни
Вывод о превосходстве авторегрессионного предобучения опирается на подогнанную асимптотическую потерю отрисовки, а не на сравнение итоговых баллов бенчмарков. Законы масштабирования, экстраполяция, а подтверждение дано на одной модели в 3 млрд параметров. О данных для обучения и стоимости вывода в описании не сказано, так что переносимость результата на другие условия остаётся открытым вопросом.