Hugging Face пересобрала AUTOMATIC1111 на Gradio Workflow: 73 узла без своего GPU
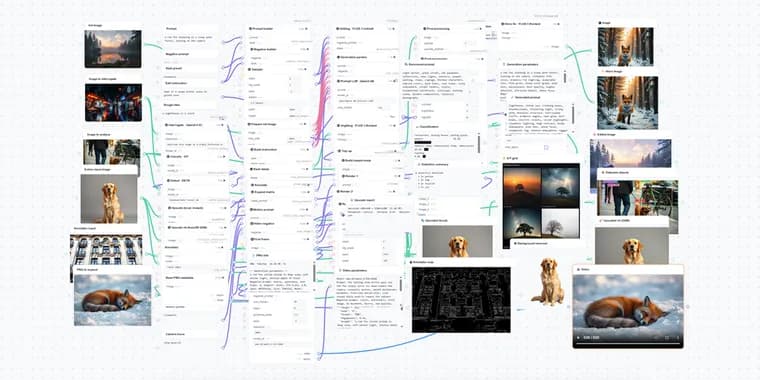
Команда Gradio, разрабатывающая одноимённую библиотеку для Hugging Face, опубликовала в блоге Hugging Face разбор Workflow1111, приложения, которое воссоздаёт большую часть функций AUTOMATIC1111 (популярного веб-интерфейса Stable Diffusion) на новом инструменте построения графов gr.Workflow (Gradio Workflow). Workflow1111, это граф из 73 узлов, собранный в одиннадцать пайплайнов обработки изображений и видео: «текст-в-изображение», повышение разрешения (hi-res fix), «изображение-в-изображение», генерация промпта через LLM, распознавание изображения в промпт через VLM, создание маски для инпейнта по детекции объектов, ControlNet-подобные аннотаторы (Canny, line art, sketch, luma-depth, posterize), увеличение изображения и удаление фона, чтение и запись метаданных PNG (PNG Info) и «изображение-в-видео».
Каждый узел канваса, это один из четырёх типов операторов: fn (обычная функция на Python), model (вызов модели через Inference Client), space (вызов другого приложения-Space на Hugging Face Hub) или dataset (строка из датасета Hub). Именно поэтому Workflow1111 не требует собственной видеокарты: вычисления идут через Inference Providers (сервис Hugging Face, который даёт доступ к чужим вычислительным мощностям) или через сторонние Space, а пользователь входит через аккаунт Hugging Face или токен доступа и расходует свою квоту. В разделе про аннотаторы авторы отдельно называют другую цифру для всего приложения, 36 операторных узлов, из которых 32 это fn-узлы, а 22 из них выполняются целиком локально без сетевого вызова; с заявленными в начале и повторёнными там же 73 узлами Workflow1111 эта цифра в тексте не сведена. По оценке авторов, примерно две трети канваса продолжает работать даже при потере сетевого соединения.
Среди конкретных примеров в тексте: этап повышения разрешения сведён к двухузловому обходу, вместо классической в AUTOMATIC1111 связки «увеличение плюс второй проход шумоподавления» результат «текст-в-изображение» уходит в модель FLUX.1-Kontext с инструкцией уточнить детали и текстуру, сохранив композицию; та же модель отрабатывает и режим «изображение-в-изображение». Пайплайн генерации промпта через LLM отправляет черновой промпт («маяк во время шторма») в модель Qwen3-4B, а затем отдельный fn-узел сокращает ответ до списка не более чем из сорока тегов. В обратном пайплайне, «прочитать изображение как промпт», модель Qwen2.5-VL описывает фотографию ночного рынка, а параллельно (оба узла используют один и тот же вход) ViT-классификатор возвращает метки с оценками: «ресторан», 51,9%, «табачная лавка», 15,6%, «магазин игрушек», 9,1%. В пайплайне маски для инпейнта модель DETR находит на уличном фото шесть объектов, троих людей, собаку, велосипед и автомобиль, после чего пайплайн параллельно рисует рамки на изображении и строит из тех же рамок маску; в облако уходит только вызов детектора, а рисование и построение маски выполняются локально средствами Pillow и NumPy. Пайплайн prompt-matrix (сетка вариаций промпта) объединяет базовый промпт «одинокий дуб» с четырьмя суффиксами, «на рассвете», «в грозу», «под Млечным Путём», «в осеннем тумане», и параллельно запускает четыре узла «текст-в-изображение» (у gr.Workflow нет оператора цикла, поэтому узлы одного уровня зависимости считаются одновременно), а финальный узел склеивает четыре результата в один лист-таблицу. Для увеличения изображения используются два узла на разных путях: локальное масштабирование методом Lanczos без сетевого вызова и модель AuraSR с четырёхкратным увеличением (×4), вызываемая как отдельный Space; удаление фона устроено так же, через отдельный Space с моделью BRIA RMBG-2.0.
Каждый выходной узел канваса автоматически превращается в REST-эндпоинт без ручного написания маршрутов: у Workflow1111 их девять, /image, /edited_image, /generated_prompt, /recovered_prompt, /detected_objects, /x_y_grid, /upscaled_local, /annotator_map и /png_info. Если запустить приложение с параметром mcp_server=True, те же эндпоинты становятся инструментами MCP (Model Context Protocol), тогда к серверу можно подключить Claude Code, Cursor или любой другой MCP-клиент, а каждый вызывающий передаёт собственный токен в заголовке X-HF-Token, так что сам Space не хранит ни одного токена. Помимо вызовов через чужую инфраструктуру, авторы показывают fn-узел, который запускает модель прямо на собственном GPU: отдельное приложение FastVideo/fastvideo-fasth3-preview вызывает FastH3, четырёхшаговую дистилляцию модели MiniMax-H3, и генерирует видео со звуком на Hugging Face ZeroGPU через одну функцию, обёрнутую декоратором @spaces.GPU; тот же код без изменений можно запустить и на своей машине.
Авторы прямо сравнивают gr.Workflow с ComfyUI: для большинства практических задач построения и развёртывания мультимодельных пайплайнов, по их словам, gr.Workflow закрывает те же потребности, узлом может быть чужое оборудование (Inference Providers, любой Space на Hub, любой API или датасет), каждый выход автоматически становится типизированным REST-эндпоинтом, посетители могут запускать канвас под собственной OAuth-идентичностью без установки чего-либо, на одном канвасе можно свободно смешивать диффузионные модели, LLM, VLM, детекторы и видеомодели, а кастомный узел, это просто функция на Python. Начать можно с нескольких строк: gr.Workflow(bind=[your_function]).launch() открывает канвас в браузере, параметр bind= превращает функции в узлы, edges= соединяет их, а команда gradio deploy публикует готовое приложение как Space на Hugging Face Hub. Тем, кто хочет начать не с нуля, авторы предлагают продублировать сам Workflow1111 (в примере кода он указан под именем ysharma/Workflow1111) и перестроить один из его одиннадцати пайплайнов, либо взять пять более простых канвасов из предыдущего поста команды, каждый, по их словам, запускается примерно за минуту.
Ключевые факты
- Workflow1111, граф из 73 узлов и одиннадцати пайплайнов на инструменте gr.Workflow (Gradio Workflow), воссоздающий большую часть функций AUTOMATIC1111: «текст-в-изображение», повышение разрешения, «изображение-в-изображение», генерацию промпта через LLM, распознавание изображения через VLM, маски для инпейнта по детекции, ControlNet-подобные аннотаторы, увеличение и удаление фона, PNG Info и «изображение-в-видео».
- Каждый узел, один из четырёх типов операторов (fn, model, space, dataset); это позволяет запускать канвас без своей видеокарты, модели считаются через Inference Providers или чужие Space под квотой вошедшего пользователя.
- В разделе про аннотаторы авторы отдельно насчитывают 36 операторных узлов (32 fn-узла, 22 из них работают полностью локально без сети), цифра, которую текст не сводит с заявленными для всего приложения 73 узлами; по оценке авторов, без сети продолжает работать примерно две трети канваса.
- Каждый выходной узел автоматически становится REST-эндпоинтом (у Workflow1111 их девять), а при запуске с mcp_server=True, инструментом MCP, который может вызвать Claude Code, Cursor или другой MCP-клиент; каждый вызывающий передаёт свой токен в заголовке X-HF-Token, так что сам Space токенов не хранит.
- Отдельный пример, приложение FastVideo/fastvideo-fasth3-preview: тот же fn-узел запускает модель FastH3 (четырёхшаговую дистилляцию MiniMax-H3) прямо на собственном GPU через декоратор @spaces.GPU, механизм подходит не только для чужой инфраструктуры, но и для локального железа.
Почему это важно
AUTOMATIC1111, веб-интерфейс Stable Diffusion, по функциональности которого команда Gradio решила проверить свой новый инструмент построения графов gr.Workflow; в тексте прямо сказано, что gr.Workflow обычно сравнивают с ComfyUI, поскольку оба, граф-редакторы для узлов. Демонстрация того, что одиннадцать пайплайнов AUTOMATIC1111 укладываются в 73 узла, а каждый вызов модели идёт через Inference Providers или чужой Space, а не через собственное железо, показывает, что полноценный узловой редактор для изображений и видео больше не требует от автора собственной видеокарты: узлы могут звать арендованные вычисления, чужой Space, произвольный API или строку датасета, и всё равно складываться в один работающий канвас. Отдельно показано, что те же выходные узлы автоматически становятся и REST-эндпоинтами, и (при включении) инструментами MCP для ИИ-агентов, один и тот же граф обслуживает и человека в браузере, и код, и агента.
Кому это важно
Тем, кто строит мультимодельные пайплайны для генерации изображений и видео и сравнивает gr.Workflow с ComfyUI или набором самописных скриптов; разработчикам на Hugging Face Spaces, которым нужен канвас, сам генерирующий REST-эндпоинты вместо маршрутов, написанных руками; тем, кто подключает к своим приложениям ИИ-агентов, те же эндпоинты можно выставить как инструменты MCP, которые вызывает Claude Code, Cursor или любой другой MCP-клиент.
Как это применить
Чтобы просто попробовать готовые пайплайны, достаточно войти по аккаунту Hugging Face или токену доступа, дальше вызовы модели идут в счёт квоты вошедшего пользователя; отдельной цены за эту квоту или за самостоятельный запуск модели на своём GPU в тексте не названо. Чтобы собрать канвас с нуля, достаточно нескольких строк: обычные функции на Python передаются в gr.Workflow(bind=[your_function]).launch(), который открывает редактируемый канвас в браузере, а команда gradio deploy публикует готовое приложение как Space. Параметр mcp_server=True превращает выходные узлы в инструменты MCP, а включённый OAuth позволяет посетителям запускать канвас под своей, а не авторской учётной записью. Кто не хочет начинать с нуля, может продублировать сам Workflow1111 (в примере кода он указан как ysharma/Workflow1111) и перестроить один из его одиннадцати пайплайнов, либо взять пять более простых канвасов из предыдущего поста той же команды, по её словам, каждый запускается примерно за минуту.
Можно ли доверять
Материал, рассказ команды Gradio о собственном инструменте на блоге Hugging Face, с кодом и разобранными примерами, а не независимый обзор; конкретный автор в тексте не назван. Числа даны детально, но не полностью сведены между собой: для всего приложения дважды заявлено 73 узла, а в разделе про аннотаторы отдельно названо 36 операторных узлов (32 fn-узла, 22 из них локальные), расхождение в самом источнике, никак не объяснённое. Показательные цифры вроде долей уверенности ViT-классификатора или скорости аннотаторов на CPU (около половины секунды), результат одного конкретного примера (ночной рынок, фасад здания), а не замера на наборе изображений или разном железе, и обобщать их на любой случай источник не позволяет.
Риски и подводные камни
Расхождение числа узлов (73 против 36) источник не разрешает, считать одну из двух цифр более точной не на чём. Каждый вызов модели идёт через чужую инфраструктуру (Inference Providers, сторонние Space) и списывается с квоты вошедшего пользователя, но ни цены, ни лимитов этой квоты, ни стоимости самостоятельного запуска модели на своём GPU текст не приводит, оценить итоговую стоимость пайплайна по одному этому посту нельзя. Режим MCP освобождает сам Space от хранения токенов, потому что каждый вызывающий агент передаёт свой токен в заголовке, но это же означает, что живой токен доступа теперь оказывается у каждого такого агента; как это влияет на безопасность и на ответственность за действия агента, пост не разбирает. Даты публикации в тексте нет, поэтому оценить по одному этому материалу, насколько актуальны перечисленные модели, эндпоинты и цифры узлов сегодня, невозможно.
«Узел может быть чужим оборудованием. Он может работать через Inference Providers, вызывать любой Space на Hub или любой API, либо брать данные из датасета.»
— команда Gradio, блог Hugging Face