Harness^2: в статье предложили рекурсивно улучшать обвязку ИИ-агентов
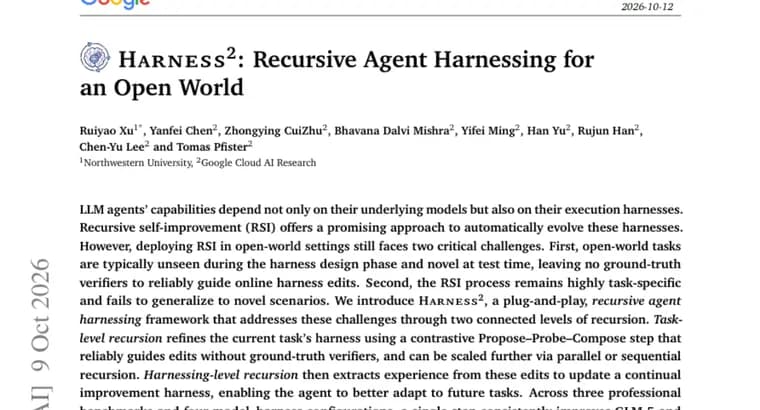
Авторы препринта исходят из того, что возможности LLM-агента определяются не только самой моделью, но и её обвязкой (harness), тем, как организовано исполнение задач. Рекурсивное самоулучшение (RSI) они называют перспективным способом автоматически развивать такие обвязки, но в «открытом мире» оно упирается в две проблемы. Во-первых, задачи заранее неизвестны и в момент работы новые, поэтому нет эталонных проверяющих (ground-truth verifiers), которые надёжно направляли бы правки обвязки на лету. Во-вторых, процесс RSI остаётся сильно привязанным к конкретной задаче и не переносится на новые сценарии. В ответ предложен Harness^2, подключаемый (plug-and-play) рекурсивный фреймворк с двумя связанными уровнями рекурсии. Рекурсия уровня задачи дорабатывает обвязку текущей задачи с помощью контрастного шага Propose-Probe-Compose, который, по заявлению авторов, надёжно направляет правки без эталонных проверяющих; его можно масштабировать параллельной или последовательной рекурсией. Рекурсия уровня самой обвязки (harnessing-level) извлекает опыт из этих правок и обновляет «обвязку непрерывного улучшения», чтобы агент лучше адаптировался к будущим задачам. Оценка проведена на трёх профессиональных бенчмарках и в четырёх конфигурациях «модель плюс обвязка». Один шаг, как сообщается, стабильно улучшает GLM-5 и Gemini 3.5 Flash по сравнению с их базовыми обвязками: прирост до 11,5 пункта на WorkBuddy-Bench, 4,5 пункта на JobBench и 11,8 процентного пункта на LAB. При увеличении бюджета рекурсии уровня задачи прирост растёт дальше.
Ключевые факты
- Harness^2, подключаемый рекурсивный фреймворк, который автоматически дорабатывает обвязку (harness) LLM-агента под новые задачи без эталонных проверяющих.
- Два уровня рекурсии: на уровне задачи, контрастный шаг Propose-Probe-Compose для правок обвязки; на уровне обвязки, извлечение опыта для обновления «обвязки непрерывного улучшения».
- Оценка: три профессиональных бенчмарка и четыре конфигурации «модель плюс обвязка» с GLM-5 и Gemini 3.5 Flash.
- Заявленный прирост после одного шага над базовой обвязкой: до 11,5 пункта на WorkBuddy-Bench, 4,5 пункта на JobBench, 11,8 процентного пункта на LAB.
- С ростом бюджета рекурсии уровня задачи приросты, по заявлению авторов, увеличиваются.
Почему это важно
Работа смещает внимание с самой модели на её обвязку: по тезису авторов, возможности агента зависят и от того, как устроено исполнение задач. Если обвязку можно улучшать автоматически и прямо во время работы, не имея эталонных проверок, это снимает одно из главных препятствий для самоулучшающихся агентов в реальных, заранее не известных задачах.
Кому это важно
Разработчикам и исследователям ИИ-агентов, которые строят обвязки вокруг LLM и сталкиваются с тем, что подбор под одну задачу не переносится на другие. Тем, кто следит за темой рекурсивного самоулучшения агентов.
Как это применить
Авторы описывают Harness^2 как подключаемый (plug-and-play) фреймворк, то есть рассчитанный на работу поверх существующей базовой обвязки. Практическая применимость пока не ясна: в источнике не названы стоимость, задержки и вычислительные затраты рекурсии, нет упоминания выпуска кода и лицензии.
Можно ли доверять
Это препринт, и все сведения здесь взяты из его аннотации: цифры заявлены самими авторами и независимо не проверены. Приведены только максимальные приросты («до»), без средних и без базовых значений; не указано, какой прирост относится к какой из двух моделей и какие именно четыре конфигурации оценивались. Сравнения с другими методами эволюции обвязок в источнике не названы.
Риски и подводные камни
Заявленные цифры, максимумы после одного шага, а не типичный результат. Единицы измерения у бенчмарков разные (пункты и процентные пункты), поэтому прирост нельзя напрямую сравнивать между ними. Что именно измеряют WorkBuddy-Bench, JobBench и LAB, в источнике не объяснено, так что оценить значимость цифр без самой статьи трудно. Рост прироста с бюджетом рекурсии подразумевает дополнительные затраты, но их размер не раскрыт.