GPT-Policy: роботов научили обучаться на лету без дообучения
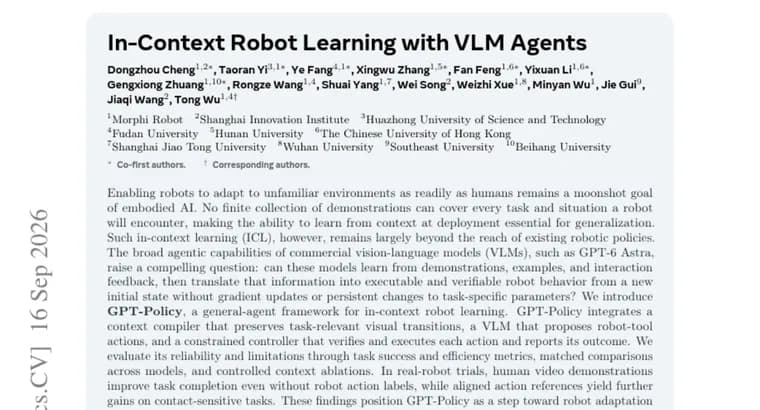
Наделить роботов способностью адаптироваться к незнакомой обстановке так же легко, как это делает человек, одна из самых труднодостижимых целей воплощённого ИИ (embodied AI). Никакой конечный набор демонстраций не может охватить все задачи и ситуации, с которыми столкнётся робот, поэтому способность учиться «в контексте» прямо во время работы (in-context learning, ICL) авторы называют необходимым условием обобщения. Но у существующих робототехнических политик такой способности практически нет.
Широкие агентные возможности коммерческих визуально-языковых моделей (VLM), в тексте как пример такой модели названа GPT-6 Astra, наводят исследователей на вопрос: можно ли заставить подобную модель учиться на демонстрациях, примерах и обратной связи от взаимодействия, а затем превращать это в исполняемое и проверяемое поведение робота из нового начального состояния, без обновления градиентов и без постоянных изменений специфичных для задачи параметров.
Ответом стал GPT-Policy, универсальный агентный фреймворк для обучения роботов в контексте. Он состоит из трёх частей: компилятор контекста, который сохраняет значимые для задачи визуальные переходы; визуально-языковая модель, которая предлагает действия робота-инструмента; и ограниченный контроллер, который проверяет и исполняет каждое действие и сообщает о его результате.
Авторы оценивали надёжность и ограничения системы через метрики успешности и эффективности выполнения задач, сравнения между моделями и контролируемые эксперименты с урезанием контекста. В испытаниях на настоящих роботах видеозаписи демонстраций человека повышали долю успешно выполненных задач даже без разметки действий самого робота, а согласованные эталонные действия давали дополнительный прирост на задачах, чувствительных к контакту.
Авторы называют GPT-Policy шагом к адаптации роботов через обучение в контексте и эмпирической основой для переноса общих возможностей VLM в физическое поведение, а также способом прояснить, какие проблемы нужно решить для надёжного внедрения такого подхода. Конкретных числовых показателей успешности, названий задач, использованных роботов-платформ, авторского состава и организаций, а также сроков публикации кода или модели в тексте препринта не приведено.
Ключевые факты
- GPT-Policy, агентный фреймворк из трёх частей: компилятор контекста (сохраняет значимые для задачи визуальные переходы), VLM (предлагает действия робота-инструмента) и ограниченный контроллер (проверяет и исполняет действия, сообщает результат).
- Цель, обучение в контексте (ICL) без обновления градиентов и без постоянных изменений параметров под конкретную задачу: адаптация происходит на лету, по демонстрациям, примерам и обратной связи.
- В экспериментах на настоящих роботах видеозаписи демонстраций человека повышали успешность задач даже без разметки действий самого робота.
- Согласованные эталонные действия дают дополнительный прирост именно на задачах, чувствительных к контакту.
- В тексте препринта нет числовых результатов, названий конкретных задач и платформ, а также имён авторов и организаций, это заявлено как эмпирическая основа для дальнейшей работы, а не готовое решение.
Почему это важно
Обучение в контексте, стандартный приём для языковых моделей, но в робототехнике его почти не было: политики обучают заранее и на фиксированном наборе демонстраций, а любая новая ситуация требует нового обучения. GPT-Policy проверяет, можно ли использовать агентные возможности готовых визуально-языковых моделей, чтобы робот учился прямо в момент работы, по демонстрациям и обратной связи, без переобучения весов.
Кому это важно
Исследователям и инженерам в области воплощённого ИИ и робототехники, которые ищут способ ускорить адаптацию роботов к новым задачам без сбора огромных датасетов и без дообучения под каждую ситуацию отдельно.
Как это применить
Практически применить пока нечего: это исследовательская работа, а не продукт. В тексте препринта не указаны ни доступность кода или модели, ни сроки. Метод пригодится как ориентир тем, кто проектирует агентные системы для роботов: разделение на компилятор контекста, предлагающую действия VLM и проверяющий контроллер, рабочая архитектурная схема, которую можно взять за основу.
Можно ли доверять
Источник, препринт с HuggingFace Papers, страница полностью прочитана и сверена. Но сама работа не публикует числовых результатов (доли успеха, сравнения с базовыми решениями), не называет авторский состав и организации в тексте аннотации и не описывает конкретные задачи и платформы экспериментов, то есть проверить заявленные улучшения по имеющемуся тексту нельзя, только по описанию метода.
Риски и подводные камни
Главный риск, перенос агентного поведения VLM в физический мир без чисел, показывающих его надёжность: контроллер, по заявлению авторов, проверяет и исполняет действия, но насколько часто он их отклоняет или ошибается, неизвестно. Задачи, чувствительные к контакту, особенно уязвимы к ошибкам предсказанных действий, и авторы прямо отмечают, что эта работа лишь проясняет, какие проблемы нужно решить перед надёжным внедрением, а не решает их.