Google Research представила федеративное обучение с проверяемой приватностью на базе TEE
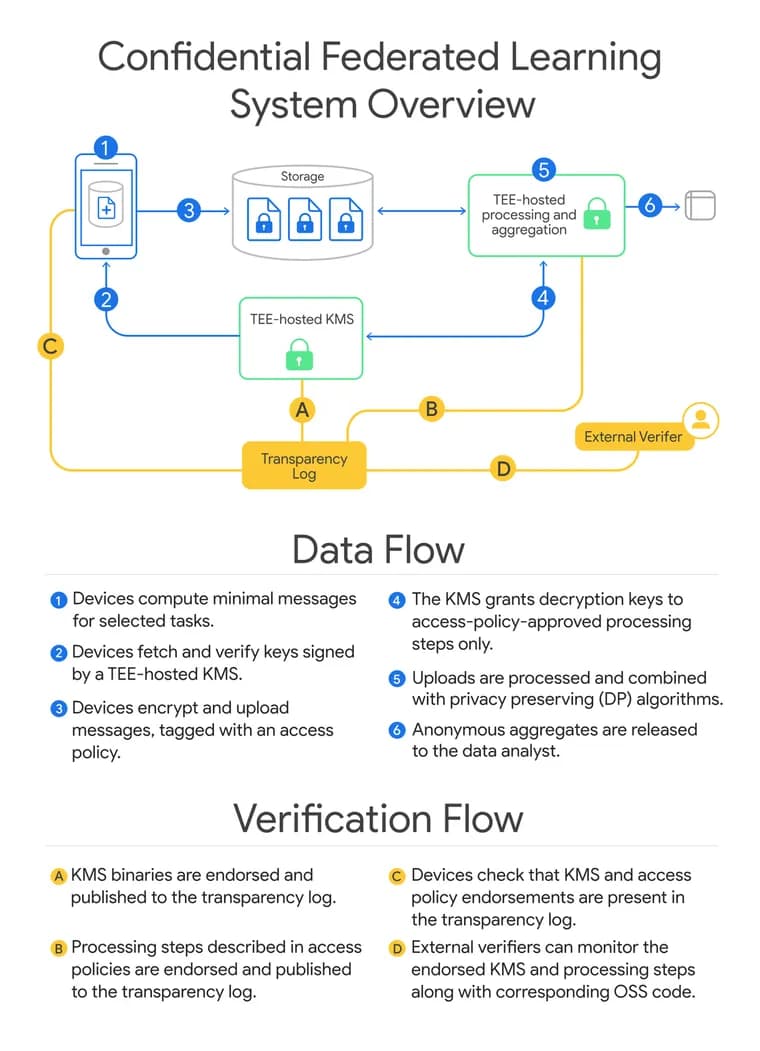
2 октября 2026 года Katharine Daly (инженер-программист) и Daniel Ramage (директор по исследованиям) из Google Research объявили о новом поколении системы федеративного обучения (Federated Learning, FL). Эту технику Google представила в 2017 году: модели обучаются на децентрализованных приватных данных. Она используется, в частности, для предсказания следующего слова и Smart Compose в Gboard, подсказок ответов в Google Messages и умного выделения текста (Smart Text Selection) в Android.
Разработка FL в Google опирается на четыре принципа приватности: минимизация данных, анонимизация данных, прозрачность и контроль, проверяемость и возможность аудита. По словам авторов, годы исследований анонимизации привели к сильным гарантиям дифференциальной приватности (DP) для рабочих моделей, через алгоритмы вроде matrix factorization DP-FTRL (MF-DP-FTRL) и распределённую дифференциальную приватность в сочетании с Secure Aggregation (защищённой агрегацией). В 2025 году компания представила расширенное определение FL, построенное на этих четырёх принципах.
Новая система использует доверенные среды выполнения (Trusted Execution Environments, TEE). Логика, которая в них работает, удалённо аттестуется (третьи стороны могут проверить, какой именно код исполняется), а также получает конфиденциальность (внутреннее состояние нельзя наблюдать) и целостность (работу нельзя нарушить), с оговоркой «в рамках ограничений TEE нынешнего поколения». Из этих свойств, которые TEE дают на уровне одной машины, собрана сквозная проверяемая FL-система. Gboard уже перешёл на неё и получает заметно более быстрые вычисления, чем в прежней системе.
Почему этого не хватало раньше. В прежних FL-системах данные устройств загружались для немедленной агрегации, но внешние наблюдатели не могли проверить, что данные нигде не логируются и не просматриваются. Secure Aggregation защитила загрузки криптографически, но не сочеталась с современными гарантиями центральной DP. Логику на сервере не могли проверить ни устройства, ни аудиторы, поэтому Google нужно было верить, что случайный шум для DP добавляется корректно. Новая система, по словам авторов, очередной шаг к тому, чтобы полностью снять необходимость доверять оператору сервера.
Как устроена защита. Операторам рабочих нагрузок видны только метрики и модельные веса с дифференциальной приватностью. Зашифрованные обучающие данные с устройств можно расшифровать и обработать только внутри TEE, где выполняются Python-программы обучения, описанные в политиках доступа, и только ограниченное время после загрузки. Устройства знают полный набор серверных нагрузок, которые могут получить их данные: политики доступа публикуются в Rekor, публичном журнале прозрачности, и внешние аудиторы могут следить за этими записями. Политики напрямую описывают Python-программу с логикой FL-обучения. Сервис управления ключами (KMS) и бинарные файлы обработки данных можно воспроизводимо собрать из открытого кода в репозитории Confidential Federated Compute на GitHub. Чтобы защитить закрытые архитектуры моделей и логику предобработки данных, TEE поддерживают подгрузку сериализованной информации в Python-программу во время работы; пока вся логика, влияющая на приватность, жёстко прописана в самой программе, закрытая логика может исполняться в TEE, а гарантии остаются проверяемыми снаружи.
Результат в Gboard. Система уже развёрнута для запуска моделей предсказания следующего слова на английском и японском языках, с более сильными гарантиями приватности и повышенной точностью (числовых значений точности в посте нет). Авторы связывают улучшения с устройством системы. Данные со всех устройств собираются до запуска серверного обучения, поэтому суточные колебания доступности устройств больше не влияют на ход обучения; расписание участия устройств можно рассчитывать динамически на сервере и использовать для настройки других параметров DP. Раньше обучение каждой такой модели могло занимать 1, 2 месяца: прогресс упирался в доступность устройств, вычисления на них и конкуренцию нескольких задач за одни и те же ресурсы. Теперь узкое место перенесено на сервер, вычисления распараллеливаются на многих машинах, и обучение существенно ускорилось, сейчас его ограничивает лишь доступность TEE-ресурсов. Точного срока обучения в новой системе пост не называет.
Что дальше. Расчёт градиентов клиентов перенесён на сервер, что снимает ограничения по вычислительным ресурсам устройств и, как пишут авторы, открывает путь к обучению всё более крупных моделей методами FL; важную роль здесь сыграет интеграция TEE с ускорителями. Система способна проверяемо исполнять любые нагрузки, выразимые на Python, и Google экспериментирует с другими типами задач, например с генерацией синтетических данных, а также с сочетанием этих TEE со специализированными TEE для инференса больших языковых моделей.
Авторы осторожны в выводах: работа, шаг к строгому доказательству того, что обработка на сервере сохраняет приватность отдельных людей, но не само доказательство. От будущего железа для TEE и продолжающихся исследований по смягчению атак по побочным каналам они ждут более глубокой защиты динамически загружаемых нагрузок от злонамеренных атак на стороне сервера. Они допускают, что когда-нибудь подобные системы получат полные доказательства корректности программных реализаций алгоритмов DP и компонентов системы.
Ключевые факты
- Google Research анонсировала новое поколение системы федеративного обучения на базе доверенных сред выполнения (TEE) с проверяемыми и поддающимися аудиту гарантиями анонимизации данных.
- Операторам видны только метрики и модельные веса с дифференциальной приватностью; данные расшифровываются только внутри TEE и ограниченное время; политики доступа публикуются в публичном журнале Rekor, а ключевые компоненты собираются воспроизводимо из открытого кода.
- Gboard уже запустил на новой системе модели предсказания следующего слова для английского и японского языков, с более сильной приватностью и повышенной точностью.
- Раньше обучение такой модели могло занимать 1, 2 месяца; теперь вычисления перенесены на сервер и распараллелены, обучение «существенно» быстрее, точной цифры нет.
- Авторы подчёркивают ограничения: гарантии зависят от возможностей TEE нынешнего поколения, атаки по побочным каналам остаются предметом исследований, а полного доказательства приватности пока нет.
Почему это важно
Главная слабость прежнего федеративного обучения, доверие к серверу: ни устройства, ни аудиторы не могли проверить, что данные не логируются и что шум для дифференциальной приватности добавляется правильно. Новая система переносит доверие с обещаний компании на проверяемый код: удалённая аттестация TEE, публичные политики доступа в журнале Rekor и воспроизводимая сборка из открытого кода. Заодно авторы заявляют выигрыш в скорости и точности, обучение, которое раньше занимало 1, 2 месяца, теперь ограничено в основном доступностью TEE-ресурсов.
Кому это важно
Исследователям и инженерам, работающим с приватным машинным обучением, дифференциальной приватностью и конфиденциальными вычислениями. Командам, которые обучают модели на пользовательских данных и должны доказывать, как эти данные обрабатываются. Аудиторам и регуляторам, интересующимся внешне проверяемой анонимизацией. Пользователям продуктов Google вроде Gboard, как конечным бенефициарам заявленных гарантий.
Как это применить
Напрямую это не продукт для подключения, а описание внутренней системы Google: в посте названы лишь Gboard как уже перешедший пользователь и открытый репозиторий Confidential Federated Compute на GitHub, откуда можно воспроизводимо собрать KMS и бинарные файлы обработки данных. Подробности проектирования изложены в отдельном техническом документе (whitepaper) с тем же названием, что и пост. Сроков внедрения в другие продукты и цен в материале нет.
Можно ли доверять
Это блог самой Google Research, написанный её сотрудниками, все утверждения исходят от разработчиков. Сам пост оговаривает, что гарантии конфиденциальности и целостности действуют с учётом ограничений TEE нынешнего поколения, а работа, лишь шаг к строгому доказательству приватности серверной обработки. Независимых аудитов и сторонних оценок в тексте не приводится; числовых значений точности, параметров дифференциальной приватности и точного времени обучения в новой системе тоже нет, только формулировки «существенное ускорение» и «повышенная точность».
Риски и подводные камни
Гарантии держатся на свойствах TEE, и авторы прямо признают, что наблюдения по побочным каналам и защита динамически загружаемых нагрузок от злонамеренных серверных атак, открытые направления, которые они надеются закрыть будущим железом и дальнейшими исследованиями. Подгрузка закрытой логики в Python-программу сохраняет проверяемость лишь при условии, что вся логика, влияющая на приватность, жёстко прописана в самой программе. Конкретный производитель и технология TEE в посте не названы, а перенос обучения на сервер делает узким местом доступность TEE-ресурсов.