Google Research предложила «сон» для языковых моделей, чтобы они не забывали
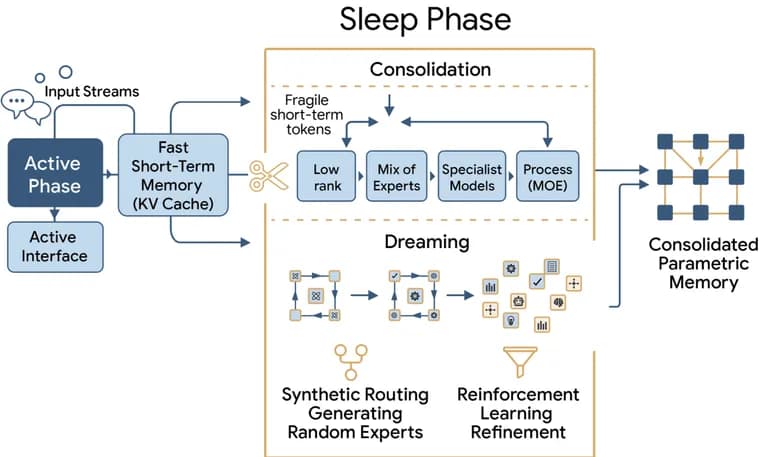
27 октября 2026 года Google Research опубликовала блог-пост Али Бехруза и Вахаба Миррокни о «фреймворке сна» (sleep framework) для непрерывного обучения больших языковых моделей. Исходная проблема: после развёртывания модели остаются почти статичными, у них фиксированная дата отсечки знаний. Постоянное обновление параметров провоцирует катастрофическое забывание, когда новое обучение резко ухудшает ранее усвоенное. Опора только на контекст (in-context learning, ICL) ограничивает память окном контекста: когда сессия заканчивается, краткосрочная информация теряется.
Авторы, вдохновляясь тем, как мозг стабилизирует память во время отдыха, предлагают наделить модель периодическим жизненным циклом: активное взаимодействие чередуется с офлайн-консолидацией памяти. В офлайн-фазе модель разблокирует заранее выделенные блоки памяти типа Mixture-of-Experts (MoE) и обновляет числовые веса на самостоятельно сгенерированных обучающих примерах. Авторы подчёркивают, что слова «сон», «сновидения» и «самосовершенствование» заимствованы из нейронауки, а сам подход работает целиком внутри фиксированной архитектуры модели и заданных людьми правил обучения; автоматический цикл дообучения не меняет ни базовый код, ни устройство модели.
Парадигма состоит из двух стадий. Первая, консолидация памяти (аналог медленноволнового сна): хрупкий краткосрочный контекст переносится в долговременные параметры. По теоретическому разбору авторов, такой «посев знаний» можно понимать как структурированную задачу низкоранговой компрессии: модель не копирует все детали, а выбирает компактный набор направлений, сохраняющих и её собственное поведение, и смысловые качества, поощряемые целью обучения. Два сигнала дополняют друг друга: дистилляция на собственных траекториях модели (on-policy) согласует консолидацию с тем, что модель реально выдаёт при работе, а семантическая награда определяет, что стоит запомнить. Расширение параметров даёт ёмкость, чтобы записать новое, не затирая уже закреплённое. Вторая стадия, «сновидения» (аналог REM-сна): цикл самосовершенствования, где случайная активация экспертов и отбор примеров по награде расширяют набор исследуемых направлений градиента, а фильтрация по градиенту выделяет самые полезные синтетические примеры. По мнению авторов, это даёт более сбалансированный ландшафт оптимизации и более устойчивый прогресс.
Результаты, которые приводят авторы. В непрерывном переводе на неизвестных модели языках (маньчжурский и каламанг) метод показал почти нулевое падение качества на многоэтапной оценке, тогда как базовые подходы ICL, Cartridges и контролируемое дообучение (SFT) сильно страдали от катастрофического забывания. На тесте BABILong метод показал «почти идеальное масштабирование» до 10 млн токенов и, по словам авторов, обошёл сильные базовые варианты, включая GPT-4 и Titans, за счёт сжатия длинного контекста прямо в параметрическую память. При усвоении новых фактов (SQuAD и продолженное предобучение, CPT) метод дал 48,9% в одиночной задаче и 46,2% в CPT и обошёл базовую модель, SFT и SEAL (Self-Adapting Language Models). На математических тестах AIME 24, AIME 25 и HMMT 25 «усиленная сном» базовая модель набрала 79,2%, 69,0% и 46,1% соответственно, опередив SFT, GRPO и on-policy self-distillation (OPSD).
Итог авторов: парадигма сна, путь к автономным, непрерывно обучающимся ИИ-системам, которые удерживают краткосрочную память, переводят новые навыки в долговременные параметры и самосовершенствуются без катастрофического забывания. Это исследовательская работа, а не готовый продукт.
Ключевые факты
- Google Research (Али Бехруз, Вахаб Миррокни) предлагает цикл для развёрнутой модели: активная работа, затем офлайн-фаза «сна» с консолидацией памяти и «сновидениями» (самосовершенствованием).
- В фазе сна модель разблокирует заранее выделенные блоки MoE и обновляет веса на самостоятельно сгенерированных примерах; архитектура и правила обучения остаются фиксированными.
- По данным авторов, метод сохраняет знания длинного контекста до 10 млн токенов на BABILong и почти не теряет качество в многоэтапном переводе на маньчжурский и каламанг.
- На SQuAD и CPT приведены 48,9% и 46,2%, на AIME 24, AIME 25 и HMMT 25, 79,2%, 69,0% и 46,1% соответственно; метод опередил заявленные базовые варианты (SFT, SEAL, GRPO, OPSD и другие).
- Теория авторов описывает консолидацию как низкоранговую компрессию, а «сновидения», как способ улучшить геометрию обучения.
Почему это важно
Развёрнутые языковые модели остаются статичными: знания замирают на дате отсечки, а попытки дообучать их на ходу приводят к катастрофическому забыванию. Контекстное обучение не решает проблему, так как память живёт только внутри сессии. Работа предлагает схему, где краткосрочный опыт переносится в параметры по расписанию, вроде отдыха. Если заявленные результаты подтвердятся, это шаг к моделям, которые накапливают знания после выпуска.
Кому это важно
Исследователям непрерывного обучения и архитектур с долгой памятью, командам, которые строят агентов с накопляемым опытом, и тем, кто следит за конкуренцией подходов к длинному контексту (в пост включены сравнения с Titans и SEAL). Для обычных пользователей это пока теория и эксперименты, а не функция продукта.
Как это применить
Готового инструмента или кода в тексте поста нет, поэтому прямого применения сейчас нет. Идея, которую можно взять на заметку: хранить заранее выделенные MoE-блоки для записи новых знаний, консолидировать контекст через дистилляцию на собственных траекториях модели с семантической наградой и отдельно запускать цикл самогенерации примеров с фильтрацией по градиенту.
Можно ли доверять
Источник, официальный блог Google Research, и все результаты в нём заявлены самими авторами. Названия статьи, ссылки на препринт и статуса рецензирования в тексте нет. Метрика, стоящая за 48,9% и 46,2%, не названа, и для сравнений не приведены числа базовых методов. Размер и тип использованной базовой модели не указаны, как и стоимость расчётов, длительность и частота фазы сна. Для переводов на маньчжурский и каламанг даны лишь слова «почти нулевое падение». Поэтому цифры стоит считать предварительными, пока нет полной работы.
Риски и подводные камни
В посте не обсуждаются ограничения и случаи неудач. Не сказано, во что обходится фаза сна по вычислениям и как часто её нужно запускать. Не названо, как контролируется то, что модель записывает в собственные веса из самогенерируемых примеров. Нет сведений о том, что подход используется или планируется в продуктах Google. Сравнения «лучше GPT-4 и Titans» нужно проверять по условиям эксперимента, которых в посте нет.
«Наша парадигма сна даёт путь к автономным, непрерывно обучающимся ИИ-системам.»
— Али Бехруз и Вахаб Миррокни, Google Research