Google анонсировала TPU 8tx и TPU 8i Max: защищённый инференс и длинный контекст
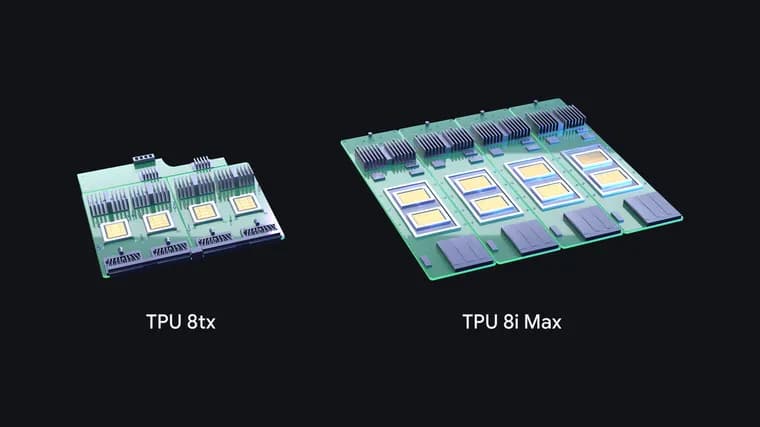
Google в блоге объявила о двух новых системах в восьмом поколении TPU (тензорных процессоров собственной разработки). TPU 8tx предназначена для защищённого и конфиденциального инференса (запуска обученных моделей), а TPU 8i Max рассчитана на огромные контекстные окна и максимальную плотность вычислений на стойку. Раньше, на Google Cloud Next в апреле, были представлены TPU 8t (для крупномасштабного обучения) и TPU 8i (для рассуждений в реальном времени). Теперь в поколении четыре системы, и Google называет это первым случаем, когда за один год представлено четыре системы TPU. По словам компании, у TPU сейчас почти 100 клиентов: передовые лаборатории, торговые фирмы, ритейлеры, университеты и другие.
TPU 8tx, по описанию Google, оптимизирована для защищённого инференса и подходит для небольшого обучения. Она создана для регулируемых предприятий и госструктур, которые запускают передовые или собственные модели и автономных агентов рядом с самыми чувствительными данными. Система построена на том же кремнии, что и TPU 8t, и работает в паре с серверными процессорами AMD EPYC 5-го поколения. Защита встроена в аппаратный уровень: данные и веса модели остаются защищёнными и изолированными даже во время обработки (обычно данные шифруют при хранении и передаче, но в памяти при вычислениях они открыты). Сеть Boardfly с низкой задержкой, созданная для рассуждений в реальном времени, даёт, по заявлению Google, до 2 раз меньшую задержку по сравнению с TPU 8t при почти нулевой потере производительности. Поскольку на одной системе есть и вычисления уровня обучения, и быстрая сеть для инференса, организации могут дообучать модели на закрытых данных, дистиллировать большие модели в малые и обучать агентов с подкреплением, не перенося чувствительные данные между кластерами.
TPU 8i Max решает проблему «стены памяти»: когда десятки ИИ-агентов одновременно работают с целой кодовой базой или часами видео, узким местом становится пропускная способность памяти. Google объединила два чипа TPU 8i в одном корпусе. По заявлению компании, система даёт вдвое больше вычислений, вдвое больше SRAM и вдвое большую пропускную способность HBM по сравнению с TPU 8i. Так как в прежний габарит стойки помещается вдвое больше кремния, дата-центры могут получить заметно больше вычислительной мощности на квадратный фут и на ватт. TPU 8i, как поясняет Google, снижает задержки обмена между чипами до половины.
Вторая половина анонса посвящена программному обеспечению. Месяц назад Google открыла код TorchTPU, поэтому код на PyTorch и модели Hugging Face работают на TPU нативно (есть также готовые бэкенды для vLLM и SGLang). Новый набор TPU-агентов с открытым кодом (в предварительной версии) подключается к инструментам программирования, включая Claude Code, Cursor и Google Antigravity, чтобы подключать TPU, искать узкие места и подбирать ядра простым языком. Новый XLA Serving Engine с открытым кодом позволяет обучать модели на Python и запускать их в C++-среде с низкой задержкой на TPU, GPU и CPU. По заявлению Google, её стек vLLM-TorchTPU показал лучшие в отрасли отношения цена/производительность на бенчмарках InferenceX и AgentX; цифры в тексте не приведены, а дальнейшие оптимизации обещаны.
Ещё в списке: Agent Compute Engine автоматически приостанавливает и возобновляет простаивающие сессии агентов, снижая затраты. Открывается код TPU Sync, слоя состояния модели, который объединяет HBM чипа, оперативную память хоста, общее хранилище и сеть дата-центра в единую иерархию памяти; Google утверждает, что он сокращает задержку передачи KV-кэша и время до первого токена (TTFT) более чем на 90%. Cloud Pathways стал общедоступным в Google Kubernetes Engine (GKE), а GKE dynamic slicing на основе оптической коммутации (OCS) тоже общедоступен: по заявлению Google, он ускоряет запуск задач до 5 раз и восстановление после сбоев до 4,5 раза.
В заключение Google пишет, что всё это возможно благодаря совместной разработке с Google DeepMind, и отмечает, что уже использует ИИ для создания следующего поколения TPU: AlphaChip и Gemini помогают выдавать схемы размещения чипов за часы, а не недели.
Ключевые факты
- Google добавила к восьмому поколению TPU две системы: TPU 8tx (защищённый и конфиденциальный инференс, плюс небольшое обучение) и TPU 8i Max (огромные контекстные окна и максимальная плотность вычислений на стойку); всего в поколении четыре системы.
- TPU 8tx построена на том же кремнии, что TPU 8t, в паре с процессорами AMD EPYC 5-го поколения; по заявлению Google, защищает данные и веса модели даже в момент обработки и даёт до 2 раз меньшую задержку, чем TPU 8t.
- TPU 8i Max объединяет два чипа TPU 8i в одном корпусе: вдвое больше вычислений, SRAM и пропускной способности HBM, чем у TPU 8i, в том же габарите стойки.
- Программная часть: открытый код TorchTPU, XLA Serving Engine и TPU Sync (по заявлению Google, сокращает задержку передачи KV и TTFT более чем на 90%), общедоступные Cloud Pathways и GKE dynamic slicing (запуск задач до 5 раз быстрее).
- Цен, сроков доступности и абсолютных характеристик новых систем в тексте нет; цифры 2,7 раза и 80% относятся к апрельскому анонсу TPU 8t и 8i.
Почему это важно
Google расширяет собственную линейку ускорителей под два конкретных запроса: работу с очень длинным контекстом и обработку чувствительных данных в защищённом режиме. Для компании это четыре системы TPU за один год, чего раньше не было. Заявленный подход: делать не только новый чип, но и «систему» вокруг него (вычисления, сеть, хранилище, упаковка), чтобы поставлять специализированные суперкомпьютеры за месяцы, а не годы. Параллельно Google открывает код программного стека (TorchTPU, XLA Serving Engine, TPU Sync), снижая барьер входа для разработчиков на PyTorch.
Кому это важно
Регулируемым предприятиям и государственным структурам, которые хотят запускать модели и агентов рядом с закрытыми данными. Командам, строящим агентные системы с контекстом в миллионы токенов или работающим с большими кодовыми базами и видео. Разработчикам на PyTorch и Hugging Face, которые рассматривают TPU как альтернативу другим ускорителям. Инженерам инфраструктуры, использующим GKE: Cloud Pathways и dynamic slicing теперь общедоступны.
Как это применить
Информации о цене и сроках доступности TPU 8tx и TPU 8i Max в тексте нет. Сразу применимы программные части: TorchTPU позволяет запускать код PyTorch и модели Hugging Face на TPU без переписывания; бэкенды для vLLM и SGLang уже готовы. Набор TPU-агентов (в предварительной версии) подключается к Claude Code, Cursor и Google Antigravity. Cloud Pathways и GKE dynamic slicing общедоступны в GKE. Для задач с закрытыми данными Google предлагает на TPU 8tx дообучение, дистилляцию и обучение агентов с подкреплением без переноса данных между кластерами.
Можно ли доверять
Источник первичный: это пост Google в собственном блоге, имя автора не указано. Все цифры производительности (до 2 раз меньшая задержка TPU 8tx против TPU 8t, более 90% по TPU Sync, до 5 раз и до 4,5 раза по dynamic slicing) заявлены самой Google, независимых измерений нет, а у большинства стоит «до». Для сокращения TTFT более чем на 90% базовый уровень сравнения не указан. Утверждение о лучшем отношении цена/производительность на InferenceX и AgentX приведено без цифр и без названий конкурирующих ускорителей. Цифры 2,7 раза и 80% взяты из апрельского анонса TPU 8t и 8i, а не измерены для 8tx и 8i Max.
Риски и подводные камни
Для TPU 8tx и TPU 8i Max в тексте нет цен, сроков и регионов, статуса (доступна ли система уже или только анонсирована), абсолютных характеристик (FLOPS, объёмов памяти, энергопотребления) и сравнения с ускорителями Nvidia или других производителей. Клиенты не названы, только категории. Пропуск в «уровне защиты»: Google говорит о защите данных и весов в процессе обработки, но подробностей модели угроз не приводит. Часть программных новинок (набор TPU-агентов) пока в предварительной версии, а дальнейшие оптимизации производительности только обещаны.
«Мы впервые представили четыре системы TPU за один год.»
— Google, пост в блоге о TPU 8tx и TPU 8i Max