Фреймворк CoworkEnv: после SFT Qwen3-VL-8B-Instruct набрала на Claw-Eval 64,1 вместо 46,6
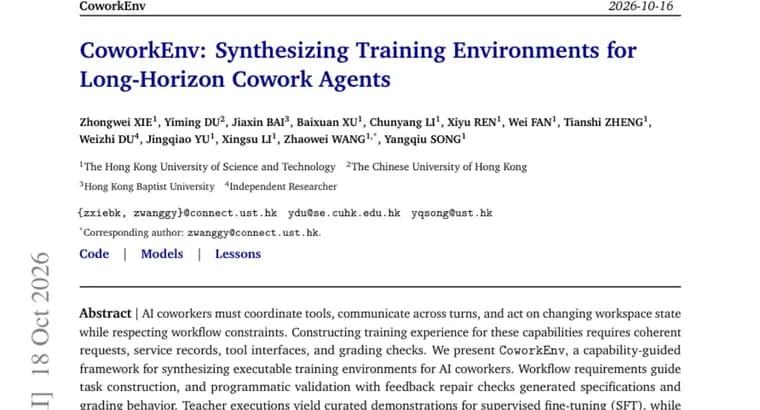
Авторы препринта исходят из того, что ИИ-коллега (AI coworker) должен координировать инструменты, общаться с пользователем на протяжении нескольких реплик и действовать в меняющемся состоянии рабочего пространства, не нарушая ограничений рабочего процесса. Чтобы обучать такие навыки, нужен связный набор материалов: согласованные запросы, служебные записи, интерфейсы инструментов и проверки для оценки результата.
Для этого предложен CoworkEnv, управляемый целевыми способностями (capability-guided) фреймворк, который синтезирует исполняемые обучающие среды для ИИ-коллег. Требования к рабочему процессу направляют построение задач, а программная проверка с исправлением по обратной связи контролирует сгенерированные спецификации и поведение оценивающих проверок. Выполнения задач «учителем» дают отобранные демонстрации для supervised fine-tuning (SFT, обучение с учителем), а взаимодействия «ученика» дают траектории и награды для reinforcement learning (RL, обучение с подкреплением).
На этих ресурсах обучены компактные модели PocketWorker. Главный приведённый результат: для Qwen3-VL-8B-Instruct SFT поднимает средний балл на Claw-Eval с 46,6 до 64,1, при этом на подмножестве многошаговых задач (Multi-turn) прирост составляет 31,9 пункта. Расширение только с SFT на ClawMark, по словам авторов, показывает применимость подхода к другим бенчмаркам для ИИ-коллег.
Для RL авторы сравнивают динамику обучения при разных настройках обработки наград и распределения заслуг по шагам (credit assignment). Растущие обучающие награды названы лишь предварительным свидетельством того, что построенные среды годятся для оптимизации политики; числовых результатов RL в тексте нет.
Ключевые факты
- CoworkEnv синтезирует исполняемые обучающие среды для ИИ-коллег: задачи строятся по требованиям рабочего процесса, а программная проверка с исправлением по обратной связи контролирует спецификации и оценивающие проверки.
- Выполнения «учителя» дают демонстрации для SFT, взаимодействия «ученика», траектории и награды для RL.
- На ресурсах фреймворка обучены компактные модели PocketWorker.
- Для Qwen3-VL-8B-Instruct SFT повышает средний балл на Claw-Eval с 46,6 до 64,1, на многошаговых задачах прирост, 31,9 пункта.
- Результаты RL описаны только как предварительные: растущие обучающие награды, без числовых итогов.
Почему это важно
Агенты, которые работают как коллеги, вызывают инструменты, ведут диалог в несколько реплик и учитывают меняющееся состояние рабочего пространства, требуют обучающего опыта со связными запросами, записями, интерфейсами и проверками. Работа предлагает способ синтезировать такие среды автоматически. Заметный результат, рост среднего балла Qwen3-VL-8B-Instruct на Claw-Eval с 46,6 до 64,1 после SFT, особенно на многошаговых задачах (+31,9 пункта).
Кому это важно
Исследователям и командам, которые обучают агентов для рабочих задач и упираются в нехватку исполняемых сред с автоматической проверкой. Также тем, кто следит за тем, как компактные модели дотягивают до задач, где важны многошаговые диалоги и работа с инструментами.
Как это применить
Из текста источника видно общую схему: строить задачи по требованиям рабочего процесса, проверять сгенерированные спецификации и оценивающие проверки программно с исправлением по обратной связи, затем собирать демонстрации «учителя» для SFT и траектории с наградами «ученика» для RL. О выпуске кода, данных или моделей в источнике не сказано, поэтому воспроизводимость и сроки доступности понятны не из него.
Можно ли доверять
Это препринт с карточки Hugging Face Papers; пересказ опирается только на аннотацию. Цифры по Claw-Eval заявлены авторами, независимой проверки в тексте нет. Сами авторы осторожны с RL: растущие обучающие награды названы лишь предварительным свидетельством того, что среды поддерживают оптимизацию политики. Для ClawMark приведён только вывод о применимости SFT, без баллов.
Риски и подводные камни
Приведён один численный результат, для одной базовой модели, Qwen3-VL-8B-Instruct, без сравнения с другими методами или моделями. Шкала среднего балла и размер бенчмарка в тексте не раскрыты, поэтому масштаб улучшения трудно оценить. Размеры моделей PocketWorker не указаны, помимо слова «компактные». Эффект RL не подтверждён числами, а перенос на другие бенчмарки показан только для SFT.