Factorized VQ: дискретные визуальные токены сравнялись по пониманию с непрерывными представлениями
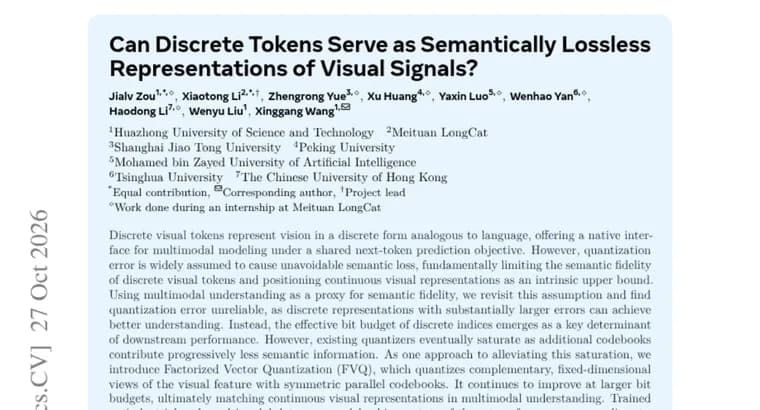
В статье с Hugging Face Papers (id 2610.37662) пересматривается распространённое допущение: дискретные визуальные токены, которые представляют изображение в дискретной форме, похожей на язык, и позволяют обучать мультимодальные модели единой задачей предсказания следующего токена, будто бы неизбежно теряют смысл из-за ошибки квантования. Из этого допущения следует, что непрерывные визуальные представления, это принципиальный верхний предел качества.
Авторы берут мультимодальное понимание как показатель семантической точности и проверяют допущение. Они находят, что ошибка квантования, ненадёжный ориентир: дискретные представления со значительно большей ошибкой могут давать лучшее понимание. Ключевым фактором качества на последующих задачах оказывается эффективный битовый бюджет дискретных индексов.
При этом существующие квантизаторы в итоге упираются в насыщение: каждая дополнительная кодовая книга (codebook) добавляет всё меньше смысловой информации. В качестве одного из способов смягчить это авторы предлагают Factorized Vector Quantization (FVQ, факторизованное векторное квантование). Метод квантует дополняющие друг друга «взгляды» на визуальный признак фиксированной размерности с помощью симметричных параллельных кодовых книг. По словам авторов, качество FVQ продолжает расти при увеличении битового бюджета и в итоге сравнивается с непрерывными визуальными представлениями в мультимодальном понимании.
Модель обучена на мультимодальных данных промышленного масштаба и, как заявляют авторы, показывает лучший результат среди моделей с дискретными представлениями: она опережает UniAR на 22,8%, а Emu3-Chat на 59,2% по среднему значению девяти метрик (относительный это прирост или в пунктах, в аннотации не сказано). Кроме того, по мнению авторов, это первая модель с дискретными представлениями, сопоставимая по качеству с сильными моделями на непрерывных представлениях вроде Qwen3-VL, в том числе в задачах точного распознавания текста (OCR). Авторы также говорят, что выделили ключевые принципы и практический рецепт, обеспечивающие такую конкурентоспособность.
Итоговый вывод осторожный: результаты, по мнению авторов, подтверждают потенциал дискретных визуальных представлений как основы для крупных «нативно» мультимодальных базовых моделей. Код и модели выложены в репозитории github.com/hustvl/FVQ.
Ключевые факты
- Авторы ставят под сомнение допущение, что ошибка квантования неизбежно ограничивает смысловую точность дискретных визуальных токенов: представления с заметно большей ошибкой могут понимать изображения лучше.
- Ключевым фактором качества оказывается эффективный битовый бюджет дискретных индексов; существующие квантизаторы насыщаются, поскольку новые кодовые книги дают всё меньше смысловой информации.
- Factorized Vector Quantization квантует дополняющие виды визуального признака фиксированной размерности параллельными симметричными кодовыми книгами и, по заявлению авторов, при больших битовых бюджетах догоняет непрерывные представления в мультимодальном понимании.
- Среди моделей с дискретными представлениями результат лучший: выше UniAR на 22,8% и Emu3-Chat на 59,2% по среднему значению девяти метрик; также заявлена сопоставимость с Qwen3-VL, включая точное OCR.
- Код и модели опубликованы: github.com/hustvl/FVQ.
Почему это важно
Дискретные визуальные токены позволяют обрабатывать изображения и текст единым способом, предсказанием следующего токена. Мешало им убеждение, что квантование неизбежно теряет смысл и непрерывные представления всегда лучше. Если результаты авторов подтвердятся, этот предел окажется не принципиальным: узкое место, по их данным, в битовом бюджете и насыщении кодовых книг, а не в самой дискретности. Авторы считают, что это поддерживает идею крупных нативно мультимодальных моделей на дискретных токенах.
Кому это важно
Исследователям мультимодальных моделей и визуальной токенизации, командам, которые строят единые модели для текста и изображений на основе предсказания следующего токена, и тем, кто сравнивает дискретные и непрерывные визуальные представления, например модели вроде Qwen3-VL.
Как это применить
Код и модели доступны в репозитории github.com/hustvl/FVQ. Авторы также говорят о выделенных принципах и практическом рецепте обучения. Практически полезный вывод для разработчиков токенизаторов: оценивать их стоит не только по ошибке реконструкции, но и по качеству мультимодального понимания, а также следить за эффективным битовым бюджетом индексов.
Можно ли доверять
Это аннотация статьи, и все утверждения, слова самих авторов; сравнения «конкурентоспособна» и «сопоставима» даны без числовых данных для Qwen3-VL. Не указано, относительные ли 22,8% и 59,2% или в пунктах, и какие именно девять метрик усреднялись; абсолютные оценки моделей, размеры моделей и состав обучающих данных в аннотации не приведены. Фразу «первая модель» авторы сопровождают оговоркой «насколько нам известно». Независимой проверки в тексте нет.
Риски и подводные камни
Совпадение с непрерывными представлениями заявлено именно для мультимодального понимания; о качестве генерации изображений в аннотации ничего не сказано. Авторы называют FVQ лишь одним из подходов к преодолению насыщения, а не единственным. Вывод о потенциале дискретных представлений для больших нативных мультимодальных моделей, заявка на будущее, а не уже продемонстрированный результат. Без значений битовых бюджетов и полных таблиц оценить цену такого качества трудно.
«Мы пересматриваем это допущение и находим, что ошибка квантования ненадёжна: дискретные представления со значительно большей ошибкой могут обеспечивать лучшее понимание.»
— Из аннотации статьи на Hugging Face Papers