EvoSafeHarness: фреймворк сам создаёт защиту для ИИ-агентов под модель
LLM-агенты, модели, которые не просто отвечают текстом, а совершают реальные действия, нуждаются в защите не только внутри самой модели, но и отдельным защитным слоем поверх неё: от косвенных инъекций в промпт (когда вредоносная команда прячется в контенте, который обрабатывает агент) и от прямых вредоносных запросов. Обычно такой защитный слой один раз проектируют эксперты и без изменений применяют к разным моделям и разным областям применения (доменам). Но эффективная защита зависит от конкретного развёртывания: у моделей разный запас прочности, после которого начинает падать полезность, а у доменов, разные наборы действий, состояний и последовательностей шагов, которые вообще нужно контролировать. Слой, достаточно строгий для одной модели, может чрезмерно блокировать другую, а политика, перенесённая из одного домена в другой, упустить связи безопасности, характерные именно для этого приложения.
Работу представляют Наньси Ли (Nanxi Li) с соавторами. Они предлагают EvoSafeHarness, фреймворк для оптимизации защиты, который синтезирует готовый к развёртыванию защитный слой под конкретную «замороженную» (неизменяемую, без дообучения) модель и целевой домен. Фреймворк совместно подбирает текстовую политику на естественном языке и исполняемую программную логику, ориентируясь на поведение модели, спецификацию домена и отдельную состязательную проверку со «свежим контекстом», она отбраковывает правила, слишком точно подогнанные под конкретный тестовый бенчмарк, вместо того чтобы работать в целом.
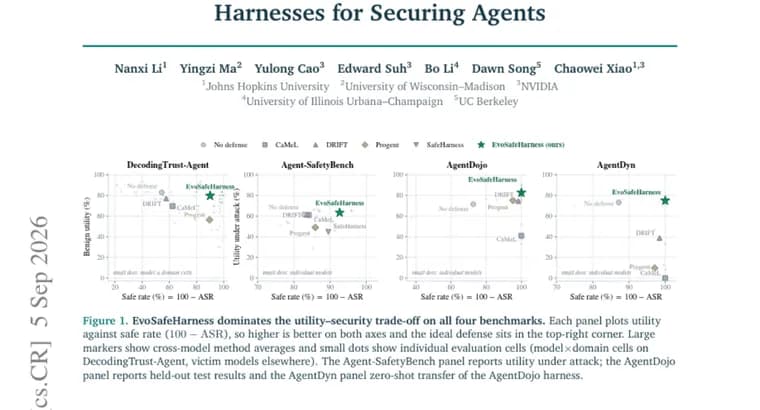
На четырёх семействах агентных бенчмарков EvoSafeHarness показывает более выгодное соотношение безопасности и полезности, чем фиксированные защиты, спроектированные экспертами. На DecodingTrust-Agent он снижает среднюю долю успешных атак (ASR) с 45,6% до 10,0% ценой падения полезности всего на 3,3 процентного пункта и берёт лучший результат в 14 из 15 ячеек оценки. На AgentDojo фреймворк достигает 82,8% полезности при нулевой доле успешных атак, вдвое больше полезности, чем у сравниваемой системы CaMeL в той же точке (тоже при 0% ASR), и без изменений переносится на новые, не встречавшиеся ранее наборы AgentDyn. На Agent-SafetyBench EvoSafeHarness показывает лучший результат для каждой из проверяемых моделей и держит среднюю ASR ниже 20% даже под адаптивными атаками PAIR с бюджетом уточнения в 16 попыток.
По анализу авторов, какие именно связи безопасности и какое состояние действий агента нужно контролировать, задаёт семантика домена, а как и в какой момент эти связи нужно применять на практике, определяют поведение конкретной модели и её работа во время выполнения.
Ключевые факты
- EvoSafeHarness автоматически синтезирует защитный слой (текстовую политику плюс исполняемый код) под конкретную «замороженную» модель и целевой домен, а не использует единый набор правил для всех.
- На DecodingTrust-Agent фреймворк снижает среднюю долю успешных атак (ASR) с 45,6% до 10,0% при потере полезности всего в 3,3 процентного пункта и берёт лучший результат в 14 из 15 ячеек оценки.
- На AgentDojo он достигает 82,8% полезности при нулевой доле успешных атак, вдвое больше полезности, чем у системы CaMeL в той же точке, и без изменений переносится на новые наборы AgentDyn.
- На Agent-SafetyBench показывает лучший результат для каждой из проверяемых моделей и держит среднюю ASR ниже 20% даже под адаптивными атаками PAIR с бюджетом уточнения в 16 попыток.
- По выводу авторов, какие связи безопасности нужны, определяет семантика домена, а как и когда их применять, поведение конкретной модели и её работа во время выполнения.
Почему это важно
LLM-агенты, модели, которые не просто отвечают текстом, а совершают реальные действия, нуждаются в защите не только внутри самой модели, но и отдельным защитным слоем поверх неё: от косвенных инъекций в промпт (когда вредоносная команда прячется в контенте, который обрабатывает агент) и от прямых вредоносных запросов. Проблема в том, что такой защитный слой обычно один раз проектируют эксперты и без изменений применяют к разным моделям и разным доменам. Но, как отмечают авторы, эффективная защита зависит от конкретного развёртывания: у моделей разный запас прочности, после которого начинает падать полезность, а у доменов, разные наборы действий, состояний и последовательностей шагов, которые вообще нужно контролировать. Слой, достаточно строгий для одной модели, может чрезмерно блокировать другую, а политика, перенесённая из одного домена в другой, упустить связи безопасности, характерные именно для этого приложения. EvoSafeHarness решает это тем, что подбирает защиту под каждую пару «модель + домен» отдельно и автоматически, и, по заявленным авторами цифрам, получает более выгодное соотношение безопасности и полезности, чем фиксированные защиты, спроектированные вручную.
Кому это важно
Тем, кто уже развёртывает LLM-агентов с реальными полномочиями, доступом к файлам, внешним сервисам, действиям от имени пользователя, и вынужден либо вручную писать правила безопасности под каждую связку «модель + сценарий использования», либо полагаться на общую защитную надстройку, не учитывающую специфику конкретного домена. Полезно и исследователям безопасности ИИ-агентов, которые сравнивают защитные механизмы на признанных агентных бенчмарках (DecodingTrust-Agent, AgentDojo, Agent-SafetyBench) и ищут способ не жертвовать полезностью агента ради безопасности.
Как это применить
Фреймворк берёт «замороженную» (неизменяемую, без дообучения) модель и спецификацию целевого домена и совместно подбирает для них текстовую политику на естественном языке и исполняемую программную логику поверх модели. Подбор ведётся с оглядкой на реальное поведение модели, описание домена и отдельную состязательную проверку со «свежим контекстом», она отбраковывает правила, которые слишком точно подогнаны под один тестовый бенчмарк, вместо того чтобы работать в целом. Результат, готовый защитный слой, который разворачивается поверх модели без её переобучения. Слой защиты, полученный на AgentDojo, по данным авторов, без изменений переносится и на новые, не встречавшиеся ранее наборы AgentDyn. В тексте не сказано, планируют ли авторы выпустить код, данные или готовые конфигурации для самостоятельного повторения экспериментов.
Можно ли доверять
Результаты, из препринта на странице HuggingFace Papers со ссылкой на arXiv. Первым автором на странице значится Наньси Ли (Nanxi Li), вероятно, с соавторами, но их состав, организация-разработчик и дата публикации в самом тексте не приведены. Все цифры авторы получили сами на четырёх признанных в индустрии агентных бенчмарках безопасности (DecodingTrust-Agent, AgentDojo, Agent-SafetyBench, AgentDyn); о независимой проверке или стороннем повторении экспериментов текст не сообщает. Сравнение с системой CaMeL дано только относительным числом («вдвое больше полезности»), собственный процент полезности CaMeL не раскрыт, и сопоставить цифры напрямую нельзя.
Риски и подводные камни
Какая именно модель защищалась в экспериментах, не названа, поэтому неясно, насколько хорошо результат переносится за пределы моделей, которые тестировали сами авторы. На Agent-SafetyBench средняя доля успешных атак не равна нулю: под адаптивными атаками PAIR с бюджетом уточнения в 16 попыток она остаётся ниже 20%, то есть часть атак всё же проходит. Автоматически синтезированная защита в принципе может давать ложное чувство безопасности, если встретится тип атаки, не предусмотренный ни спецификацией домена, ни состязательной проверкой на этапе синтеза.