Эмбеддинги переоценены? Замороженный словарь в 16 МБ заменил обучаемую таблицу в малой модели
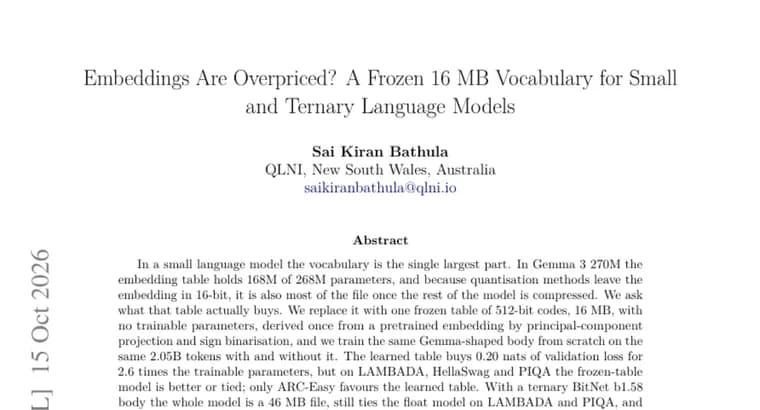
В малой языковой модели словарь (таблица эмбеддингов), самая крупная часть. Авторы препринта приводят пример Gemma 3 270M: из 268 млн параметров 168 млн приходится на таблицу эмбеддингов. Кроме того, методы квантизации оставляют эмбеддинг в 16-битном виде, поэтому после сжатия остальной модели именно он занимает большую часть файла.
Авторы задаются вопросом, что эта таблица на самом деле даёт. Они заменяют её одной замороженной таблицей 512-битных кодов размером 16 МБ без обучаемых параметров. Таблицу один раз получают из предобученного эмбеддинга: проекцией на главные компоненты и бинаризацией по знаку. Затем одно и то же «тело» модели в архитектуре типа Gemma обучают с нуля на одних и тех же 2,05 млрд токенов, с такой таблицей и без неё (с обучаемой).
Результаты. Обучаемая таблица даёт выигрыш в 0,20 нат по потерям на валидации, но ценой 2,6 раза большего числа обучаемых параметров. При этом на LAMBADA, HellaSwag и PIQA модель с замороженной таблицей лучше или не хуже; только ARC-Easy в пользу обучаемой таблицы.
С троичным телом BitNet b1.58 вся модель умещается в файл на 46 МБ и по-прежнему на уровне модели с плавающей точкой на LAMBADA и PIQA. На процессоре ноутбука она генерирует 615-740 токенов в секунду, занимая 62 МБ памяти. Это в пять, шесть раз быстрее 8-битной GGUF-версии модели с плавающей точкой в llama.cpp при седьмой части памяти.
На редких словах замороженная таблица выигрывает 1,7-2,3 нат. После обучения она принимает 10 000 новых слов ценой 3%, тогда как у обучаемой таблицы качество обваливается на 43%. Авторы сообщают, что опубликовали всё: веса, данные и каждый ответ при оценке.
Ключевые факты
- В Gemma 3 270M таблица эмбеддингов занимает 168 млн из 268 млн параметров; её предлагают заменить замороженной таблицей 512-битных кодов размером 16 МБ без обучаемых параметров.
- При обучении на одних и тех же 2,05 млрд токенов обучаемая таблица даёт 0,20 нат выигрыша по потерям, но требует в 2,6 раза больше обучаемых параметров; на LAMBADA, HellaSwag и PIQA модель с замороженной таблицей лучше или не хуже, только ARC-Easy в пользу обучаемой.
- Троичная версия с BitNet b1.58 весит 46 МБ и на процессоре ноутбука выдаёт 615-740 токенов в секунду в 62 МБ памяти, в 5-6 раз быстрее 8-битной GGUF-версии в llama.cpp при седьмой части памяти.
- На редких словах замороженная таблица выигрывает 1,7-2,3 нат; добавление 10 000 новых слов после обучения стоит ей 3%, обучаемой таблице, обвал на 43%.
Почему это важно
В малых моделях словарь, крупнейшая часть, и квантизация её не сжимает: эмбеддинг остаётся 16-битным и занимает большую часть файла. Работа проверяет, можно ли обойтись без обучения этой части. По заявлению авторов, замороженная таблица в 16 МБ на трёх из четырёх тестов не уступает обучаемой, а вместе с троичным телом модель умещается в 46 МБ. Это интересно для запуска нейросетей на слабом железе.
Кому это важно
Тем, кто делает компактные языковые модели для устройств с малым объёмом памяти и процессором без видеокарты. Также исследователям квантизации и архитектур в духе BitNet и тем, кого интересует расширение словаря уже после обучения.
Как это применить
Авторы сообщают, что опубликовали веса, данные и каждый ответ при оценке, так что результаты можно перепроверить и воспроизвести. Рецепт построения таблицы описан в аннотации: один раз взять предобученный эмбеддинг, спроецировать на главные компоненты и бинаризовать по знаку; тело модели обучается с нуля. Ссылки на публикацию материалов в тексте аннотации нет.
Можно ли доверять
Это препринт на странице Hugging Face Papers, в аннотации не названы авторы и организации. Все цифры, заявления самих авторов. Сильная сторона: сравнение «с таблицей и без» на одном теле и одних и тех же 2,05 млрд токенов, а также заявленная публикация весов, данных и ответов при оценке. В аннотации нет самих значений по LAMBADA, HellaSwag, PIQA и ARC-Easy, только направление сравнения, и не указано, какой именно предобученный эмбеддинг использован.
Риски и подводные камни
Результаты относятся к одной конфигурации, телу размером около 270 млн параметров в архитектуре типа Gemma; про другие размеры в аннотации ничего нет. По потерям на валидации обучаемая таблица всё же лучше (на 0,20 нат), и на ARC-Easy выигрывает именно она. Скорость 615-740 токенов в секунду измерена на «ноутбучном процессоре», модель которого не указана. Таблица берётся из предобученного эмбеддинга, то есть зависит от уже существующей модели.