CriticOPD: в дистилляции учитель разбирает ошибки ученика Qwen3
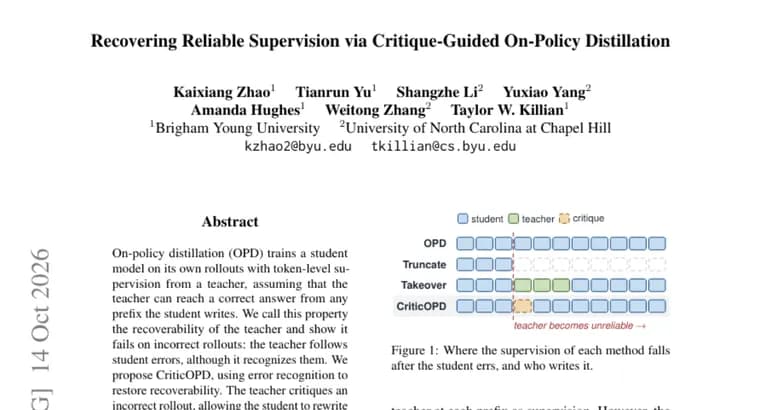
В статье предложен CriticOPD, доработка on-policy дистилляции (on-policy distillation, OPD). В обычном OPD ученик обучается на собственных ответах, а учитель даёт пошаговую (на уровне токенов) оценку. Здесь заложено допущение: учитель способен прийти к верному ответу из любого начала решения, которое написал ученик.
Авторы называют это свойство «восстановимостью» (recoverability) учителя и показывают, что на неверных ответах ученика оно не выполняется: учитель следует за ошибками ученика, хотя и распознаёт их. Из-за этого сигнал для обучения на ошибочных траекториях оказывается ненадёжным.
CriticOPD использует способность учителя распознавать ошибки, чтобы вернуть восстановимость. Схема такая: учитель критикует неверный ответ ученика, после чего ученик переписывает решение с учётом найденной ошибки. Получившийся результат оценивает учитель, причём критика служит для него привилегированной информацией (privileged information). Сам же ученик учится на переписанном варианте без критики.
Метод проверен на двух моделях-учениках семейства Qwen3 и шести бенчмарках по математическим рассуждениям. По словам авторов, CriticOPD улучшает OPD, а наибольший выигрыш даёт на задачах уровня соревнований. В аннотации нет числовых значений прироста, размеров моделей Qwen3, названия учителя и списка бенчмарков.
Ключевые факты
- OPD обучает ученика на его собственных ответах с пошаговой оценкой учителя и предполагает, что учитель может прийти к верному ответу из любого начала решения.
- Авторы показывают, что на неверных ответах это не так: учитель следует за ошибками ученика, хотя и распознаёт их.
- В CriticOPD учитель критикует неверный ответ, ученик переписывает решение, а учитель оценивает результат с критикой как привилегированной информацией; ученик учится на версии без критики.
- Проверка: две модели-ученика Qwen3 и шесть бенчмарков по математическим рассуждениям; наибольший выигрыш на соревновательных задачах.
- Числовой размер улучшения в аннотации не указан.
Почему это важно
Дистилляция на собственных ответах ученика, распространённый способ переносить умения большой модели в малую. Работа указывает на конкретную слабость такого подхода: на ошибочных траекториях учитель не исправляет ученика, а продолжает за ним ошибку, хотя умеет её замечать. CriticOPD предлагает использовать это умение, чтобы сигнал обучения на неверных ответах стал надёжнее.
Кому это важно
Исследователям и инженерам, которые обучают небольшие модели рассуждений методом дистилляции, особенно на математических задачах. Для остальных читателей это пока методологическое наблюдение без готового продукта.
Как это применить
Схема из аннотации: взять неверный ответ ученика, получить от учителя критику, дать ученику переписать решение, оценить результат учителем с критикой в контексте, а обучать ученика на исправленной версии без критики. Сведений о выпуске кода, моделей или данных в тексте нет, поэтому воспроизводить придётся по описанию в статье.
Можно ли доверять
Это препринт, и оценка опирается только на аннотацию. Заявленное улучшение относится к двум моделям-ученикам Qwen3 и шести математическим бенчмаркам. Числовых результатов, названий бенчмарков и сравнения с методами, кроме обычного OPD, в тексте нет, поэтому оценить масштаб эффекта по аннотации нельзя.
Риски и подводные камни
Результаты показаны на математических рассуждениях; перенос на другие области из аннотации не следует. Метод требует дополнительных шагов (критика, переписывание, повторная оценка), а о затратах на обучение в тексте ничего не сказано. Наибольший выигрыш заявлен на соревновательных задачах, а величина эффекта не раскрыта.
«Учитель следует за ошибками ученика, хотя и распознаёт их.»
— из аннотации статьи о CriticOPD