CoDA: симулятор и политика робота учатся вместе, успех вырос с 5,3% до 27,6%
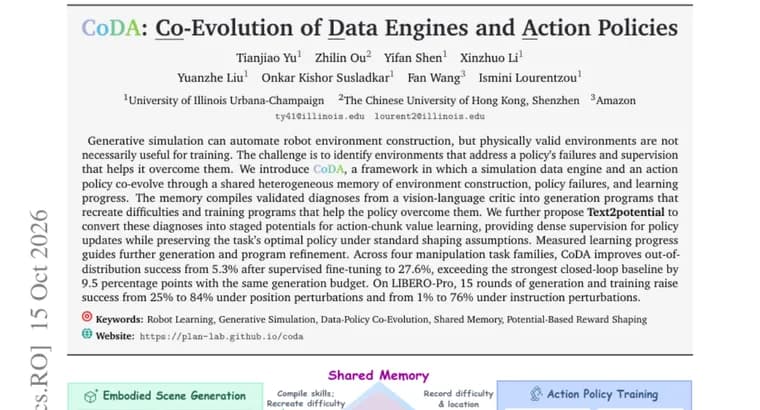
Авторы препринта исходят из того, что генеративная симуляция умеет автоматически строить среды для обучения роботов, но физически корректная среда не обязательно полезна для обучения. Задача в том, чтобы находить среды, бьющие по конкретным ошибкам политики (модели, выбирающей действия робота), и такой обучающий сигнал, который помогает эти ошибки преодолеть.
Для этого предложен CoDA: фреймворк, в котором симуляционный генератор данных и политика действий развиваются совместно через общую разнородную память. В ней хранятся сведения о построении сред, об ошибках политики и о ходе обучения. Память превращает проверенные диагнозы от критика на основе модели «зрение-язык» в два вида программ: генерирующие, которые воссоздают трудные ситуации, и обучающие, которые помогают политике с ними справиться.
Отдельно авторы предлагают Text2potential. Он переводит эти диагнозы в поэтапные потенциалы для обучения функции ценности на блоках действий (action-chunk value learning). Это даёт плотный сигнал для обновления политики и, как утверждают авторы, сохраняет оптимальную политику задачи при стандартных допущениях о формировании вознаграждения (reward shaping). Измеренный прогресс обучения, в свою очередь, направляет дальнейшую генерацию сред и доработку программ.
Результаты из аннотации. На четырёх семействах задач манипуляции CoDA поднимает успех вне обучающего распределения с 5,3% после обычной дообучки с учителем (supervised fine-tuning) до 27,6%. При том же бюджете на генерацию это на 9,5 процентного пункта выше сильнейшего базового метода с замкнутым циклом. На LIBERO-Pro после 15 раундов генерации и обучения успех вырос с 25% до 84% при возмущениях положения объектов и с 1% до 76% при возмущениях инструкций.
Ключевые факты
- CoDA связывает генератор симуляционных сред и политику действий робота общей памятью о построении сред, ошибках политики и прогрессе обучения.
- Критик на основе модели «зрение-язык» ставит диагнозы ошибок; память превращает их в программы генерации сложных сред и программы обучения.
- Text2potential переводит диагнозы в поэтапные потенциалы для плотного сигнала обучения и, по заявлению авторов, сохраняет оптимальную политику задачи при стандартных допущениях.
- На четырёх семействах задач манипуляции успех вне обучающего распределения вырос с 5,3% до 27,6%, на 9,5 п.п. выше сильнейшего базового метода при том же бюджете генерации.
- На LIBERO-Pro за 15 раундов успех вырос с 25% до 84% при возмущениях положения и с 1% до 76% при возмущениях инструкций.
Почему это важно
Автоматическая генерация сред для обучения роботов упирается в вопрос, какие именно среды стоит создавать. CoDA отвечает на него замкнутым циклом: среды строятся под ошибки текущей политики, а прогресс обучения влияет на следующую генерацию. По заявленным цифрам, результат вне обучающего распределения вырос с 5,3% до 27,6%, а на LIBERO-Pro при возмущениях инструкций успех поднялся с 1% до 76%. Это сообщения самих авторов из аннотации препринта.
Кому это важно
Исследователям обучения роботов и манипуляции, а также тем, кто строит конвейеры генеративной симуляции и обучения политик. Подход интересен и тем, кто работает с обучением по плотному сигналу и с моделями «зрение-язык» в роли критика.
Как это применить
Из аннотации видна общая схема: критик диагностирует провалы политики, память превращает диагнозы в программы генерации и обучения, прогресс обучения корректирует следующий раунд. Сведений о выпуске кода или данных в источнике нет, поэтому воспроизведение потребует полного текста работы.
Можно ли доверять
Это препринт, пересказ построен только по аннотации. Авторы и организации в ней не названы, сами четыре семейства задач и базовые методы тоже не перечислены. Не указан и собственный результат базового метода: известен лишь разрыв в 9,5 п.п. Цифры 5,3% и 27,6%, единые агрегированные значения без разбивки по задачам. Заявление о сохранении оптимальной политики верно лишь при стандартных допущениях, как оговаривают сами авторы.
Риски и подводные камни
Абсолютный уровень остаётся невысоким: 27,6% успеха вне обучающего распределения. Из аннотации неясно, какая политика и какой критик использовались, каков размер бюджета генерации и проверялась ли система на физических роботах. Большой рост на LIBERO-Pro получен после 15 раундов генерации и обучения, то есть ценой заметных вычислений. Независимой проверки результатов в источнике нет.