Бенчмарк DataVista: лучшая из 19 моделей, Gemini-3.1-Pro, набрала 70,0%
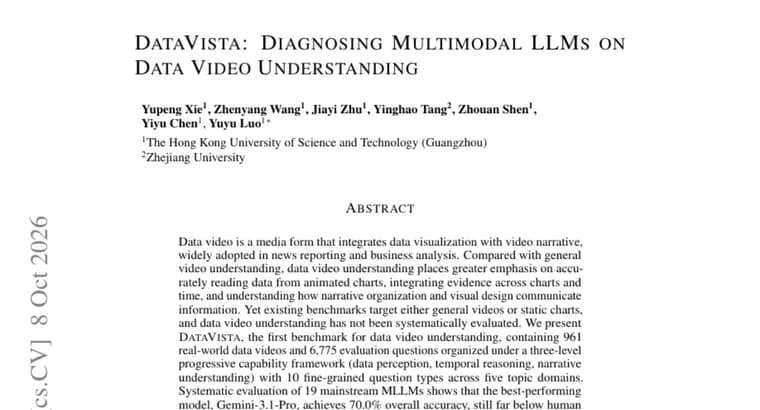
Data video (видео с данными), это формат, где визуализация данных соединена с видеоповествованием; его широко используют в новостях и бизнес-аналитике. По словам авторов статьи, такое видео требует от модели больше, чем обычное: точно считывать значения с анимированных графиков, сопоставлять свидетельства между графиками и по времени, а также понимать, как композиция рассказа и визуальное оформление передают информацию. При этом существующие бенчмарки ориентированы либо на обычное видео, либо на статичные графики, и понимание видео с данными систематически не проверялось.
Авторы представляют DataVista, по их заявлению, первый бенчмарк для понимания видео с данными. В нём 961 реальное видео с данными и 6 775 оценочных вопросов. Вопросы организованы по трёхуровневой иерархии возможностей: восприятие данных, временные рассуждения и понимание повествования. Внутри, 10 детальных типов вопросов в пяти тематических областях.
Систематическая оценка 19 распространённых мультимодальных языковых моделей (MLLM) показала, что лучшая из них, Gemini-3.1-Pro, достигает общей точности 70,0%. Это, как подчёркивают авторы, всё ещё далеко от уровня экспертов-людей. Хуже всего модели справляются с вопросами на причинно-следственные рассуждения (Causal Reasoning) и на структуру повествования (Narrative Structure).
Увеличение числа кадров и добавление субтитров в основном помогает на уровнях восприятия данных и временных рассуждений, а в понимании повествования выигрыш ограничен. Разбор ответов моделей выявил типичные сбои в чтении графиков, оценке свидетельств и понимании инструкций. Бенчмарк опубликован на GitHub: https://github.com/HKUSTDial/DataVista.
Ключевые факты
- DataVista, по заявлению авторов, первый бенчмарк для понимания видео с данными: 961 реальное видео и 6 775 вопросов, 10 типов вопросов в пяти тематических областях.
- Вопросы разложены на три уровня: восприятие данных, временные рассуждения, понимание повествования.
- Из 19 проверенных мультимодальных моделей лучшая, Gemini-3.1-Pro, набрала 70,0% общей точности, всё ещё далеко от уровня экспертов-людей.
- Слабее всего модели справляются с причинно-следственными рассуждениями и структурой повествования.
- Больше кадров и субтитры в основном помогают восприятию данных и временным рассуждениям, а в понимании повествования выигрыш ограничен.
Почему это важно
Видео с данными, это анимированные графики в новостях и бизнес-аналитике, и по словам авторов, понимание таких роликов раньше системно не проверяли: бенчмарки касались либо обычного видео, либо статичных графиков. DataVista закрывает этот пробел и показывает, что даже лучшая из 19 моделей, Gemini-3.1-Pro, даёт 70,0% общей точности и заметно уступает экспертам-людям. Особенно слабо модели понимают причинно-следственные связи и структуру повествования, то есть то, что делает видео рассказом, а не набором графиков.
Кому это важно
Исследователям мультимодальных моделей, которые ищут задачи, где текущие системы всё ещё проседают. Командам, которые хотят автоматически разбирать новостные и аналитические видео с анимированными графиками. Тем, кто выбирает модель для работы с видеографикой и хочет понимать, на каких типах вопросов она наиболее уязвима.
Как это применить
Бенчмарк опубликован на GitHub (репозиторий HKUSTDial/DataVista), поэтому его можно взять для проверки собственной мультимодальной модели на видео с данными по трём уровням: восприятие данных, временные рассуждения, понимание повествования. Практический вывод из анализа авторов: увеличение числа кадров и добавление субтитров в основном улучшает восприятие данных и временные рассуждения, но в понимании повествования выигрыш ограничен.
Можно ли доверять
Это научная статья, и все цифры взяты из её аннотации. Утверждение о «первом бенчмарке» и оценка «далеко от экспертов» принадлежат самим авторам статьи. Точность людей-экспертов в аннотации не приведена, как и результаты других 18 моделей, поэтому сравнивать можно только общую цифру Gemini-3.1-Pro. Имена авторов в тексте аннотации не названы.
Риски и подводные камни
Из аннотации известна лишь одна числовая оценка, 70,0% у лучшей модели; разбивки по типам вопросов и по моделям не приведены, а размер выигрыша от дополнительных кадров и субтитров не количественно описан. Результат относится к конкретному набору из 961 видео и 6 775 вопросов, и переносить его на любые видео с данными без проверки не стоит. Перечень типичных сбоев (чтение графиков, оценка свидетельств, понимание инструкций) дан в общем виде и требует чтения полной статьи.