Бенчмарк Continual Learning Exam: ИИ-агенты плохо учатся на опыте
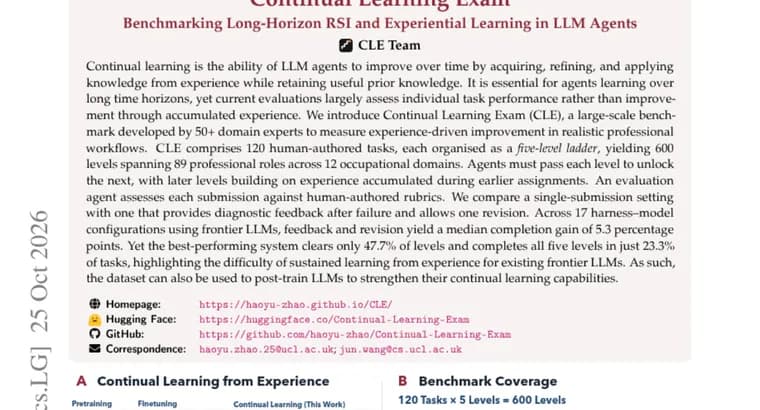
Авторы препринта вводят Continual Learning Exam (CLE), масштабный бенчмарк для проверки непрерывного обучения ИИ-агентов на основе больших языковых моделей. Непрерывное обучение они определяют как способность агента со временем улучшаться: получать, уточнять и применять знания из опыта, не теряя полезных прежних знаний. По мнению авторов, такая способность необходима агентам, которые работают на длинных временных горизонтах, но нынешние оценки в основном измеряют качество на отдельных задачах, а не рост за счёт накопленного опыта.
CLE разработали более 50 экспертов из разных предметных областей, и он имитирует реалистичные профессиональные рабочие процессы. В бенчмарк входят 120 задач, написанных людьми. Каждая задача устроена как лестница из пяти уровней, всего получается 600 уровней, которые охватывают 89 профессиональных ролей в 12 профессиональных областях. Чтобы открыть следующий уровень, агент должен пройти текущий, а поздние уровни опираются на опыт, накопленный на ранних заданиях. Каждую работу оценивает отдельный агент-оценщик по рубрикам, составленным людьми.
Авторы сравнили два режима: однократную сдачу работы и режим, где после неудачи агент получает диагностическую обратную связь и может один раз переделать работу. Эксперимент охватил 17 конфигураций «обвязка агента + модель» на передовых языковых моделях. Обратная связь с правкой дала медианный прирост доли выполненных уровней на 5,3 процентного пункта.
При этом результаты остаются скромными: лучшая система проходит только 47,7% уровней и целиком, все пять уровней, выполняет лишь в 23,3% задач. Авторы делают вывод, что для существующих передовых моделей устойчивое обучение на опыте остаётся трудным. Они также отмечают, что набор данных можно использовать для дообучения моделей, чтобы усилить их способность к непрерывному обучению; это названо возможностью, эксперименты с таким дообучением в тексте не описаны.
Ключевые факты
- Continual Learning Exam (CLE), бенчмарк, который разработали более 50 экспертов, чтобы измерять улучшение ИИ-агентов за счёт накопленного опыта в профессиональных рабочих процессах.
- В нём 120 задач, написанных людьми; у каждой пять уровней, всего 600 уровней в 89 профессиональных ролях и 12 областях.
- Следующий уровень открывается только после прохождения предыдущего; работы оценивает агент по рубрикам, составленным людьми.
- Обратная связь после неудачи и одна попытка правки дают медианный прирост 5,3 процентного пункта по 17 конфигурациям «обвязка + модель».
- Лучшая система проходит лишь 47,7% уровней и все пять уровней выполняет только в 23,3% задач.
Почему это важно
Обычно агентов проверяют на отдельных задачах, а не на том, становятся ли они лучше по мере накопления опыта. Авторы утверждают, что для работы на длинных горизонтах нужно именно это. CLE пытается закрыть пробел: уровни связаны между собой, и поздние опираются на опыт ранних. Результат при этом сдержанный: лучшая система проходит 47,7% уровней, а все пять уровней осиливает в 23,3% задач.
Кому это важно
Исследователям непрерывного обучения и разработчикам ИИ-агентов, которым нужна проверка роста от опыта, а не разовой точности. Авторы также указывают, что датасет можно использовать для дообучения моделей, чтобы усилить их способность к непрерывному обучению.
Как это применить
Из доступного описания видно, как устроена проверка: пятиуровневые лестницы задач, рубрики, составленные людьми, и агент-оценщик. Режим с диагностической обратной связью и одной правкой можно взять как образец сравнения с однократной сдачей. В тексте нет ссылки на данные или код, а также сведений о лицензии, поэтому о доступности бенчмарка сказать нечего.
Можно ли доверять
Это препринт, и у нас есть только его аннотация. Цифры взяты из неё: медианный прирост 5,3 процентного пункта, 47,7% пройденных уровней, 23,3% полностью выполненных задач. В аннотации не названы лучшая система и 17 конфигураций, поэтому сопоставить результаты с конкретными моделями нельзя. Неясно, к какому режиму относятся 47,7% и 23,3%, и не указана доля выполнения при однократной сдаче, так что относительный выигрыш 5,3 пункта оценить нельзя.
Риски и подводные камни
Выводы опираются на 17 конфигураций и на оценку агентом-оценщиком по рубрикам; независимая проверка в тексте не описана. Режим с обратной связью допускает только одну правку, поэтому он показывает ограниченный срез обучения на опыте. Пользу дообучения на датасете авторы называют лишь возможной: результатов такого эксперимента в источнике нет.