AMD Zen 6 и Zen 6c: разбор Chips and Cheese, ядра теперь различаются
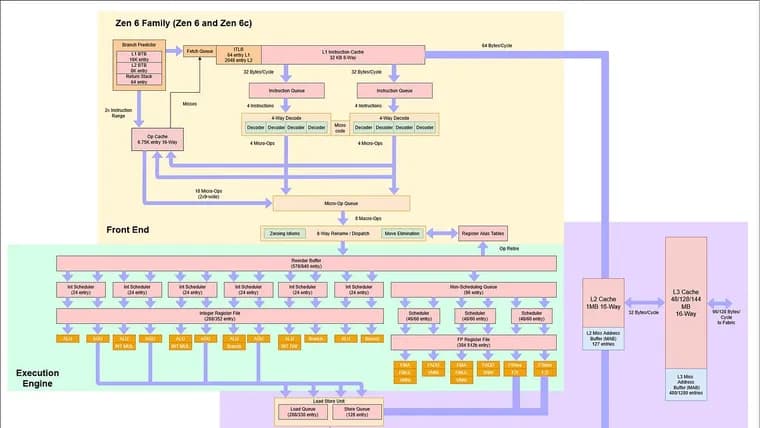
Издание Chips and Cheese опубликовало разбор микроархитектуры следующего поколения ядер AMD: Zen 6 и плотного варианта Zen 6c. По общей оценке, Zen 6, естественное развитие Zen 5 с увеличенными внеочередными структурами, но внутри AMD сильно переработала несколько частей ядра, что напоминает изменения от Zen 1 к Zen 2. Особенно заметны целочисленные планировщики: компоновка возвращается к схеме, близкой к Zen 3 и Zen 4.
Предсказание ветвлений. Направляющий предсказатель Zen 5 издание считало лучшим из измеренных, а Zen 6, судя по всему, строится на нём же. Оба ядра упираются в предел примерно в одном и том же месте; дальше предсказатель угадывает случайные данные, и время на ветвление отражает скорость восстановления после ошибки. Эта «полка» составляет примерно 3,5-4 нс дополнительного времени на ветвление у Zen 5 и примерно 3-3,5 нс у Zen 6, то есть задержка при ошибочном предсказании снизилась. Zen 6 умеет обрабатывать по 2 ветвления за такт в пределах кэша инструкций L1; при выходе за L1i остаётся одно ветвление за такт. По мнению автора, в BTB (буфере адресов переходов) AMD сосредоточилась на скорости, а не на ёмкости; точность блока близка к Zen 5.
Выборка инструкций. Двойная схема кластеров декодирования пришла из Zen 5, но если там один поток мог эффективно использовать лишь один кластер, то в Zen 6 один поток использует оба.
Исполнительный движок. На целочисленной стороне вернулось «спаривание» NOP из Zen 4: до 16 NOP за такт на выбытии. Для простых целочисленных инструкций Zen 6 ближе к теоретическому максимуму: 5,96 64-битных сложений за такт против 5,25 у Zen 5 при тех же шести АЛУ. Число блоков целочисленного умножения сократилось с трёх до двух, пропускная способность PDEP и PEXT упала с трёх инструкций за такт до двух; по словам AMD, третий блок умножения в Zen 5 не оправдывал занимаемую площадь. Блоки с плавающей запятой не менялись: по-прежнему две 512-битные операции FADD, FMUL или FMA за такт. Зато блоков VNNI стало четыре вместо двух, и 512-битный тест VNNI вырос с 1,99 до 3,88 инструкции за такт (Zen 6c показывает то же). VNNI полезны во внутреннем цикле квантованного инференса и в видеофильтрах кодеков. Кроме того, 256-битные векторные загрузки выросли до четырёх за такт на обоих ядрах (в Zen 5 векторных загрузок было две), 512-битные остались на двух, так что обе ширины дают по 128 байт за такт; это важно, потому что большая часть выпускаемого векторного кода всё ещё рассчитана на AVX1/2.
Где расходятся Zen 6 и Zen 6c. Раньше классические и плотные ядра были функционально идентичны, различаясь числом ядер в CCD и объёмом L3 на ядро. У семейства Zen 6 это изменилось: различия начинаются после диспетчеризации микроопераций и заканчиваются примерно у очереди загрузок. У Zen 6c больше внеочередные структуры: буфер переупорядочивания вырос с 576 до 640 записей, целочисленный регистровый файл, с 288 до 352, планировщик векторных операций, со 138 до 180, очередь загрузок, с 280 до 330. Автор делает вывод, что AMD специализирует дизайны: Zen 6 настроено на высокую частоту, Zen 6c, на терпимость к сравнительно высокой задержке памяти.
Кэш. CCD у Zen 6 содержит 12 ядер, у Zen 6c, 32, при этом на каждое ядро приходится по 4 МБ L3: 48 МБ и 128 МБ на CCD соответственно. Задержка L3 выросла примерно с 47 тактов у Zen 5 до 55 у Zen 6 и 66 у Zen 6c; вероятно, сказываются большие кэши и больше узлов сети (mesh). В наносекундах более высокая частота скрывает почти весь рост у Zen 6: 10,7 нс против 10,3 нс у EPYC 9355P на Zen 5, а у Zen 6c, 16,4 нс. Zen 6 также исправил странность пропускной способности L2 в Zen 5, где ядро получало лишь около 42 байт за такт на большей части объёма L2: теперь чтение стабильно даёт 64 байта за такт. Пересылка из хранилища в загрузку, по всей видимости, не изменилась и ведёт себя одинаково на Zen 6 и Zen 6c: 32-битная загрузка с адреса 64-битного сохранения идёт с практически нулевой задержкой, полностью вложенные загрузки занимают 7 тактов, частичные перекрытия, 14.
SPEC CPU 2026. Приведены оценочные однопоточные результаты. EPYC 9686F (Zen 6) примерно равен Ryzen 9 9950X3D2 в целочисленном тесте и опережает его в вещественном; на одинаковых 4,1 ГГц отрыв около 4% в целых числах и 11% в плавающей запятой, несмотря на гораздо больший L3 у модели X3D. EPYC 9996 (Zen 6c) примерно равен предыдущему EPYC 9575F на Zen 5, хотя работает на меньших частотах и имеет вчетверо больше ядер: 5,25 против 5,13 в целочисленном и 8,99 против 9,01 в вещественном тесте при частоте примерно на 900 МГц ниже. Он слегка обходит NVIDIA Vera в целочисленном тесте и примерно на 20% опережает её в вещественном. EPYC 9686F впереди EPYC 9996 примерно на 18% в обоих наборах: 6,20 против 5,25 в целочисленном и 10,6 против 8,99 в вещественном. Если же выровнять частоту 4,1 ГГц, картина переворачивается: EPYC 9686F даёт 4,92 и 8,64, и Zen 6c оказывается впереди на такт примерно на 6,7% в целых числах и на 4% в плавающей запятой.
Почему так. В ядро-ограниченных подтестах профили почти одинаковы, а разрыв возникает в тестах с интенсивной работой с памятью. Доля простоев бэкенда на памяти при переходе от EPYC 9996 к EPYC 9686F растёт с 37,9% до 50,0% слотов конвейера в 729.abc, с 19,0% до 34,1% в 723.llvm, с 24,8% до 33,2% в 708.sqlite. При одинаковой частоте самое заметное различие, простои по задержке фронтенда в подтестах с большой кодовой базой: в 727.cppcheck 35,2% у 9686F против 16,6% у 9996, в 721.gcc, 25,8% против 10,0%. Поскольку фронтенд у ядер общий, автор считает, что причина скорее в различиях кэшей и иерархии памяти; 128 МБ L3 у Zen 6c, вероятно, обслуживают больше запросов, чем 48 МБ у Zen 6.
В итоговых выводах автор называет Zen 6 поколенческим приростом над Zen 5 (оба декодера для одного потока, более быстрый предсказатель, более крупные внеочередные структуры), а разделение на Zen 6 и Zen 6c, самым интересным изменением: выбор между ними теперь сильнее зависит от поведения нагрузки. EPYC 9686F опережает EPYC 9575F на Zen 5 примерно на 21% в целочисленном и 18% в вещественном тесте.
Ключевые факты
- В Zen 6 один поток может использовать оба кластера декодирования (в Zen 5, фактически один), а задержка при ошибочном предсказании ветвления снизилась: полка 3-3,5 нс против 3,5-4 нс у Zen 5.
- Блоков VNNI стало четыре вместо двух (1,99 → 3,88 инструкции за такт в 512-битном тесте), 256-битные векторные загрузки выросли до четырёх за такт; блоков целочисленного умножения теперь два вместо трёх.
- Zen 6 и Zen 6c впервые различаются внеочередным движком: у Zen 6c буфер переупорядочивания 640 против 576 записей, регистровый файл 352 против 288; CCD, 12 и 32 ядра, L3, 48 и 128 МБ.
- Оценочный SPEC CPU 2026: EPYC 9686F (Zen 6) примерно на 18% впереди EPYC 9996 (Zen 6c) при штатных частотах, но при равных 4,1 ГГц Zen 6c впереди на такт примерно на 6,7% в целых числах и на 4% в плавающей запятой.
- Задержка L3 выросла с 47 тактов (Zen 5) до 55 (Zen 6) и 66 (Zen 6c); пропускная способность чтения L2 на Zen 6 стабильно составляет 64 байта за такт.
Почему это важно
Разбор показывает, что Zen 6, не просто Zen 5 с увеличенными буферами: AMD переработала целочисленные планировщики, ускорила предсказание ветвлений и расширила векторные загрузки и блоки VNNI. Главная новость по версии автора, раскол внутри семейства: если раньше классические и плотные ядра различались лишь числом ядер на CCD и L3 на ядро, то теперь они отличаются самим внеочередным движком. Zen 6 настроено на частоту, Zen 6c, на терпимость к задержке памяти, и выбор между ними становится вопросом профиля нагрузки.
Кому это важно
Прежде всего тем, кто оценивает серверные процессоры AMD EPYC и следит за развитием архитектуры: разработчикам компиляторов и высокопроизводительного кода, инженерам, подбирающим платформы под нагрузки. Увеличенное число блоков VNNI и 256-битные загрузки интересны тем, кто запускает квантованный инференс и векторный код под AVX1/2, а читателям, интересующимся устройством процессоров, разбор даёт конкретные измерения по ветвлениям, кэшам и очередям.
Как это применить
Практический вывод из текста, выбирать между Zen 6 и Zen 6c по профилю нагрузки. Нагрузки, чувствительные к частоте и ядро-ограниченные, судя по измерениям, выигрывают от Zen 6 (EPYC 9686F впереди примерно на 18% при штатных частотах). Нагрузки с большой кодовой базой и интенсивной работой с памятью лучше проявляют себя на Zen 6c: при равных 4,1 ГГц он впереди на такт на 6,7% в целых числах и на 4% в плавающей запятой. Для кода с PDEP/PEXT и целочисленным умножением стоит учесть, что блоков умножения стало два, а пропускная способность PDEP и PEXT упала с трёх до двух инструкций за такт.
Можно ли доверять
Материал основан на собственных измерениях Chips and Cheese, а выводы о замыслах AMD сформулированы как предположения автора («судя по всему», «вероятно»). Результаты SPEC CPU 2026, оценочные однопоточные, а не официально поданные. Автор в видимом тексте не назван. От AMD приведено одно замечание, о том, что третий блок целочисленного умножения в Zen 5 не оправдывал занимаемую площадь.
Риски и подводные камни
Оценочные результаты SPEC не равны официальным и описывают однопоточную производительность, а не работу всего многоядерного процессора. Сравнения при разных частотах легко прочитать неверно: 18%-ное преимущество EPYC 9686F при штатных частотах превращается в отставание на такт при равных 4,1 ГГц. Объяснения разрывов (кэш и иерархия памяти, влияние L3 Zen 6c) в тексте даны как вероятные, а не доказанные. Кроме того, в видимом тексте нет сроков выхода, цен, техпроцесса и энергопотребления, поэтому выводы о выборе платформы пока неполны.
«По словам AMD, третий блок целочисленного умножения в Zen 5 не оправдывал занимаемую площадь.»
— Chips and Cheese, разбор AMD Zen 6