ZGCM-1: открытая 7B-модель конкурирует с 235B-гигантами в математике
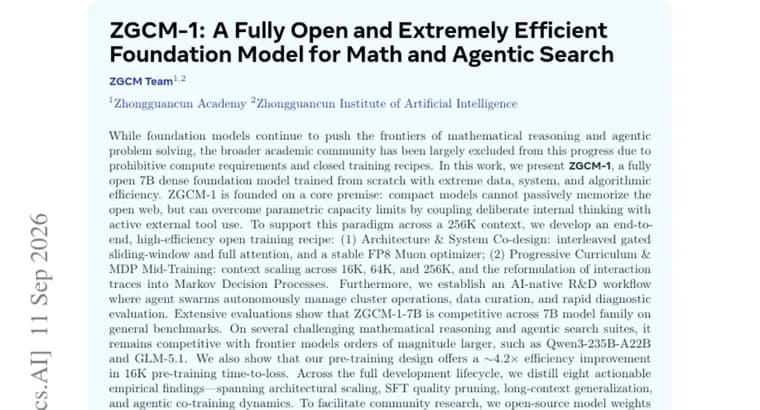
Представлена ZGCM-1, полностью открытая плотная базовая модель на 7 млрд параметров, обученная с нуля с упором на эффективность данных, вычислительной системы и алгоритмов. В основе модели лежит идея: компактная модель не способна пассивно запомнить весь открытый веб, но может обойти ограничения своей параметрической ёмкости, сочетая осознанное внутреннее рассуждение с активным использованием внешних инструментов.
Чтобы реализовать этот подход на контексте до 256 тысяч токенов, авторы разработали сквозной, высокоэффективный рецепт обучения. Архитектурно-системная часть включает чередующееся управляемое скользяще-оконное и полное внимание, а также стабильный оптимизатор Muon в формате FP8. Обучение построено как прогрессивная учебная программа: масштабирование контекста последовательно проходит стадии 16K, 64K и 256K токенов, а на промежуточном этапе («MDP mid-training») траектории взаимодействия модели с окружением переформулируются как марковские процессы принятия решений. Отдельно авторы выстроили ориентированный на ИИ процесс разработки: рои автономных агентов сами управляют операциями кластера, курируют данные и проводят быструю диагностическую оценку.
По заявлению авторов, ZGCM-1-7B конкурентоспособна внутри своего класса 7B-моделей на общих бенчмарках, а на ряде сложных наборов задач по математическому рассуждению и агентному поиску остаётся конкурентоспособной с топовыми моделями на порядки большего размера, такими как Qwen3-235B-A22B и GLM-5.1. Отдельно указано, что сам дизайн предобучения даёт примерно 4,2-кратное ускорение по времени достижения целевого значения loss при обучении на контексте 16K. По итогам всего цикла разработки авторы выделили восемь практических выводов, касающихся масштабирования архитектуры, отбора данных для SFT по качеству, обобщения на длинный контекст и динамики совместного обучения с агентными задачами.
Для исследовательского сообщества открыт полный набор материалов: веса модели со стадий предобучения, промежуточного и финального (post-training) обучения, промежуточные чекпоинты, код обучения, данные и рецепты для каждой стадии, а также логи экспериментов W&B.
Ключевые факты
- ZGCM-1, полностью открытая плотная базовая модель на 7 млрд параметров, обученная с нуля
- Ключевая идея: вместо пассивного запоминания веба модель сочетает внутреннее рассуждение с активным вызовом внешних инструментов
- Архитектура сочетает управляемое скользящее-оконное и полное внимание плюс стабильный FP8-оптимизатор Muon; контекст масштабируется по стадиям 16K → 64K → 256K, взаимодействия переформулируются как марковские процессы принятия решений
- На сложных задачах по математике и агентному поиску модель заявлена как конкурентоспособная с моделями на порядки крупнее, Qwen3-235B-A22B и GLM-5.1; дизайн предобучения даёт ~4,2-кратный выигрыш по времени до целевого loss на контексте 16K
- Открыты веса всех стадий обучения, промежуточные чекпоинты, код, данные и рецепты по стадиям, логи W&B; отдельно описаны восемь практических выводов по итогам разработки
Почему это важно
ZGCM-1, редкий случай, когда компактная 7-миллиардная модель, по заявлению её создателей, приближается по результатам на математике и агентном поиске к моделям на порядки крупнее, включая Qwen3-235B-A22B и GLM-5.1. Ставка сделана не на грубое увеличение параметров, а на сочетание внутреннего рассуждения с активным вызовом инструментов и на инженерную эффективность обучения: заявленный выигрыш в 4,2 раза по времени достижения целевого значения loss при предобучении на контексте 16K, это про то, что дорогие результаты становятся доступнее без гигантских кластеров. Модель полностью открыта вместе со всем рецептом обучения, что превращает её не только в готовый инструмент, но и в разбираемый пример архитектурных и системных решений для небольших моделей.
Кому это важно
Прежде всего исследователям и инженерам, которые строят или дообучают компактные модели и хотят получить от них поведение, близкое к моделям на порядки крупнее, без соответствующих вычислительных затрат. Полезно и командам, занятым агентными системами и математическим рассуждением: рецепт совмещения рассуждения с вызовом инструментов и переформулирование диалоговых траекторий в марковские процессы принятия решений, конкретная, воспроизводимая техника, а не общая идея. Открытый код, данные и чекпоинты также важны для сообщества open source в машинном обучении, которому обычно достаются только финальные веса, а не полный путь обучения.
Как это применить
Авторы открыли весь путь модели: веса со стадий предобучения, промежуточного и финального обучения, промежуточные чекпоинты, код обучения, данные и рецепты для каждой стадии, а также логи экспериментов W&B. Это позволяет не просто взять готовую модель, а воспроизвести или адаптировать сам процесс обучения, включая архитектурно-системные решения (чередование скользящего-оконного и полного внимания, FP8-оптимизатор Muon) и прогрессивное масштабирование контекста с 16K до 256K токенов. Отдельно полезны восемь эмпирических выводов о масштабировании архитектуры, отборе данных для SFT по качеству, обобщении на длинный контекст и динамике совместного обучения с агентными задачами, их можно применять как чек-лист при построении собственных компактных моделей. Данных о цене, лицензии или дате релиза в тексте нет.
Можно ли доверять
Материал, это описание самой работы её создателями, а не независимый обзор: в самом тексте не названы ни авторы, ни организация (имя в метаданных источника взято только из служебных данных карточки, а не из текста работы). Сравнения с более крупными моделями в математическом рассуждении и агентном поиске сформулированы качественно, как «конкурентоспособность», без конкретных цифр результатов; единственная точная цифра эффективности (~4,2 раза) относится только к времени предобучения на контексте 16K, а не к итоговому качеству модели. Проверить заявления можно будет по факту через открытые веса и код, но на момент публикации это самоотчёт разработчиков.
Риски и подводные камни
Ключевые утверждения о конкурентоспособности с моделями на порядки крупнее, это формулировки самих авторов, которые в аннотации не приводят числовых результатов сравнения, что оставляет простор для интерпретации термина «конкурентоспособна». Не раскрыто, что конкретно означает и как измерялось утверждение о «роях агентов, автономно управляющих операциями кластера», это скорее описание процесса разработки, чем проверяемый результат. Для GLM-5.1, в отличие от Qwen3-235B-A22B, не указан размер модели, из-за чего масштаб сравнения по этой паре понятен не до конца.