Вышла Hunyuan-A13B, открытая MoE-модель с 13 из 80 млрд параметров
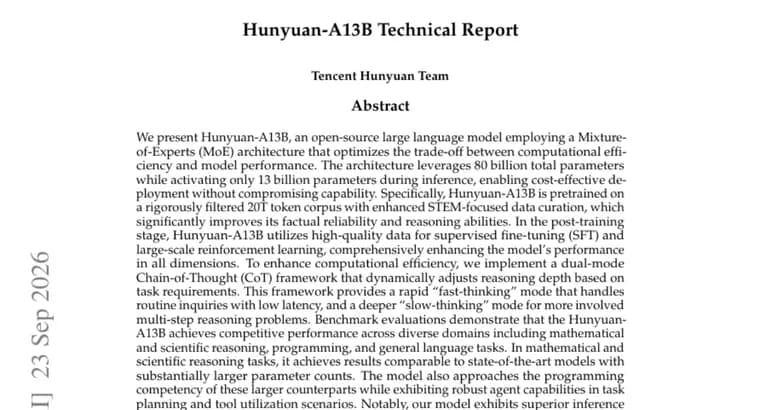
Опубликован технический отчёт о модели Hunyuan-A13B, открытой большой языковой модели на архитектуре Mixture-of-Experts (MoE, «смесь экспертов»). Всего модель содержит 80 миллиардов параметров, но при выводе (инференсе) задействует лишь 13 миллиардов из них, авторы называют это балансом между возможностями модели, вычислительной эффективностью и стоимостью развёртывания.
Модель предобучена на корпусе объёмом 20 триллионов токенов, который прошёл строгую фильтрацию и содержит расширенный набор STEM-данных (естественные науки, технологии, инженерия, математика), это, по утверждению авторов, повышает фактическую достоверность ответов и способность модели к рассуждениям. После предобучения модель дополнительно прошла качественное контролируемое дообучение (supervised fine-tuning) и масштабное обучение с подкреплением (reinforcement learning), что улучшило её итоговую производительность.
Ключевая особенность Hunyuan-A13B, двухрежимная схема рассуждений (dual-mode Chain-of-Thought), которая подстраивает глубину рассуждений под сложность задачи: для рядовых запросов используется «быстрое мышление», а для сложных многошаговых задач, «медленное мышление» с более развёрнутой цепочкой рассуждений.
По словам авторов, тестирование показало конкурентоспособные результаты в математике, естественных науках, программировании, задачах на общее понимание языка и агентных сценариях, местами приближающиеся к результатам значительно более крупных моделей. Конкретные числовые оценки бенчмарков и названия моделей для сравнения в тексте не приводятся. Отдельно отмечается высокая скорость вывода модели, что делает её подходящей для приложений, чувствительных к задержке отклика. Модель выложена в открытый доступ, авторы заявляют, что цель релиза, поддержать открытые исследования и практическое развёртывание больших языковых моделей.
Ключевые факты
- Hunyuan-A13B, открытая LLM на архитектуре Mixture-of-Experts: 80 млрд параметров всего, но активируется только 13 млрд при инференсе
- Предобучение на отфильтрованном корпусе из 20 трлн токенов с усиленной долей STEM-данных
- После предобучения применены контролируемое дообучение и масштабное обучение с подкреплением
- Введена двухрежимная схема рассуждений: быстрое мышление для простых запросов, медленное, для сложных многошаговых задач
- Заявлена конкурентоспособная производительность в математике, науке, программировании и агентных задачах при высокой скорости вывода; конкретные числовые результаты не приведены
Почему это важно
Модель показывает, что архитектура «смесь экспертов» с активацией лишь части параметров (13 из 80 млрд) позволяет получить качество, приближающееся к куда более крупным моделям, при заметно меньшей вычислительной нагрузке на инференсе. Это подтверждает тренд на разреженные MoE-архитектуры как способ снизить стоимость эксплуатации мощных моделей.
Кому это важно
Разработчикам и исследователям, которым нужна открытая модель с сильными результатами в математике, программировании и агентных задачах без затрат на инференс уровня моделей с десятками активных миллиардов параметров; инженерам, проектирующим системы с жёсткими требованиями к задержке отклика.
Как это применить
Модель заявлена как подходящая для практического развёртывания LLM и для сценариев, чувствительных к скорости ответа, благодаря высокой пропускной способности при выводе. Двухрежимная схема рассуждений (быстрое/медленное мышление) может использоваться для экономии вычислений на простых запросах при сохранении глубокого анализа для сложных задач.
Можно ли доверять
Материал, авторский технический отчёт (препринт) с описанием архитектуры, данных обучения и подхода к рассуждениям; конкретные числовые результаты бенчмарков и названия моделей для сравнения в доступном тексте отсутствуют, как и имена авторов или организации-разработчика, поэтому проверить заявления о «конкурентоспособности» независимо по этому тексту нельзя.
Риски и подводные камни
Заявления о производительности («часто приближается к результатам гораздо более крупных моделей») не подкреплены в тексте конкретными цифрами или названиями моделей сравнения, что затрудняет независимую проверку; также неизвестны дата релиза, лицензия и условия использования модели.