Unreal Labs выпустила Unreal Agent, харнес для ИИ-агентов с экономией до 40% против Codex
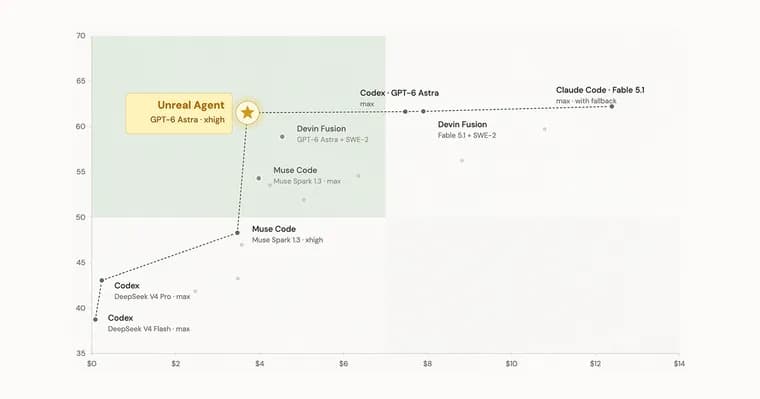
Компания Unreal Labs выпустила Unreal Agent, харнес (harness, программная обвязка, которая управляет вызовами инструментов агента) для ИИ-агентов, рассчитанный на продакшен-нагрузки. Разработчики объясняют его появление тем, что при работе агентов много времени и токенов модели уходит именно на обслуживание вызовов инструментов: ожидание ответов, опрос статуса, служебные сообщения о том, что задача ещё выполняется.
Ключевое отличие Unreal Agent, полностью асинхронная обработка вызовов инструментов. Как только харнес получает от модели вызов инструмента, он сразу добавляет в журнал сессии запись о том, что инструмент работает («в процессе»), а сам инструмент продолжает выполняться в фоне; когда он реально завершается, в журнал добавляется итоговый результат, и только тогда харнес снова обращается к модели. Это даёт два эффекта: пользователь может в любой момент направить агента новым сообщением, не дожидаясь завершения текущих вызовов инструментов, а харнес может ставить в очередь больше полезной работы инструментов между обращениями к модели, не тратя токены модели на ожидание и опрос.
По словам Unreal Labs, за счёт этого текущая версия Unreal Agent даёт до 40% экономии по стоимости по сравнению с Codex и до 20%, по сравнению с системой Pi на реальных рабочих нагрузках и агентных бенчмарках; источник не поясняет, что такое Pi и кто её разрабатывает, называя её лишь одной из сравниваемых систем. Небольшую разницу в доле пройденных задач между системами компания относит на разброс самих бенчмарков, а не на реальную разницу в качестве. Тесты проводились на модели GPT-6 Astra (режим xhigh) на бенчмарках Terminal-Bench 4.0, SWE-Atlas Codebase QnA, DeepSWE 1.1 и Agents' Last Exam (ALE-CLI); числовые значения доли пройденных задач и средних баллов в тексте статьи не приведены, они вынесены на графики. Компания поясняет, что тестирует в основном «кодинговые» бенчмарки, потому что они доступны на платформе Harbor и это упрощает воспроизведение и проверку результатов, хотя сам харнес называет доменно-независимым.
Отдельно Unreal Labs объясняет, почему решила строить собственный харнес, а не использовать готовые SDK. По опыту компании, CLI-ориентированные SDK, в качестве примера назван Claude Agent SDK, несут допущения о локальных сессиях, дочерних процессах и лимитах ресурсов, которые плохо переносятся в продакшен: завершение задач, отмену и фоновые процессы приходится оборачивать собственным управлением жизненным циклом. Поддержка нескольких провайдеров моделей добавляет работы по совместимости, переключение режимов API может ломать инструменты или сжатие контекста, а обновления SDK, менять формат сообщений и вынуждать переписывать интеграцию. Тяжёлые деревья зависимостей, по мнению компании, добавляют риски сопровождения и цепочки поставок для рантайма, который и так приходится самостоятельно понимать и патчить. Кроме того, в Unreal Labs считают, что защита и подтверждения действий, завязанные на хуки харнеса и специализированные инструменты, требуют больше сопровождения и менее надёжны, чем детерминированные ограничения вне харнеса, например, списки разрешённых и запрещённых хостов, токены доступа с ограниченными правами, прокси со шлюзами подтверждения.
SDK Unreal Agent сейчас включает библиотеку на Go для встраивания в собственный код, исполняемый файл-раннер (по аналогии с claude -p/codex exec) и раннер для бенчмарков, совместимый с Harbor; репозиторий с кодом компания предлагает изучить всем желающим на GitHub.
Ключевые факты
- Unreal Labs выпустила Unreal Agent, харнес для ИИ-агентов, который обрабатывает вызовы инструментов полностью асинхронно, без ожидания и опроса статуса моделью
- По данным компании, это даёт до 40% экономии по стоимости по сравнению с Codex и до 20%, по сравнению с системой Pi на реальных нагрузках и агентных бенчмарках
- Тесты проводились на модели GPT-6 Astra (режим xhigh) на бенчмарках Terminal-Bench 4.0, SWE-Atlas Codebase QnA, DeepSWE 1.1 и Agents' Last Exam; числовые результаты вынесены на графики, а не в текст статьи
- SDK включает библиотеку на Go, исполняемый раннер и раннер для бенчмарков, совместимый с Harbor; код открыт на GitHub
- Компания критикует CLI-ориентированные SDK вроде Claude Agent SDK за допущения о локальных сессиях и лимитах ресурсов, плохо подходящие для продакшена
Почему это важно
Unreal Labs показывает конкретную инженерную причину, по которой запуск ИИ-агентов в продакшене обходится дороже, чем кажется: модель тратит время и токены не на саму задачу, а на ожидание, опрос статуса и служебные сообщения о вызовах инструментов. Их решение, сделать обработку вызовов полностью асинхронной, убирает эти накладные расходы и, по заявлению компании, даёт заметную (до 40%) экономию по стоимости без потери качества. Это укладывается в более широкий тренд: дизайн харнеса (программной обвязки вокруг модели) авторы прямо называют отдельной областью исследований, а не второстепенной технической деталью.
Кому это важно
В первую очередь, разработчикам, которые строят собственных ИИ-агентов для продакшена и выбирают между готовыми SDK от крупных вендоров и самописной инфраструктурой. Также это касается инженеров, которые уже используют CLI-ориентированные SDK (в тексте назван Claude Agent SDK) и сталкиваются с описанными в статье ограничениями, сессиями, дочерними процессами, лимитами ресурсов, когда переносят такие инструменты в продакшен-сервисы.
Как это применить
Unreal Agent распространяется как SDK: библиотека на языке Go для встраивания в собственный код, исполняемый раннер (аналог claude -p/codex exec) и отдельный раннер для бенчмарков, совместимый с платформой Harbor. Код открыт на GitHub компании, и Unreal Labs прямо предлагает желающим протестировать харнес самостоятельно. Авторы называют харнес доменно-независимым, хотя опубликованные тесты, почти исключительно кодинговые бенчмарки, потому что именно они доступны на Harbor и их проще воспроизвести и проверить.
Можно ли доверять
Цифры экономии (до 40% и до 20%) и результаты бенчмарков, это собственные измерения Unreal Labs, опубликованные в её же блоге; в статье нет указания на независимую проверку или аудит этих цифр. Численные показатели pass rate и средних баллов по бенчмаркам в тексте статьи не приведены, они вынесены на графики, которые не входят в исходный текст. Система сравнения «Pi» упомянута без пояснений, что это и кто её делает, это тоже стоит учитывать при оценке заявленной экономии в 20% относительно неё.
Риски и подводные камни
Из статьи не видно ни версии, ни даты релиза, ни условий доступа или цены на Unreal Agent как продукт, только описание технологии и SDK. Сама компания признаёт нерешённые технические вопросы: по её словам, формат с двумя элементами результата вызова инструмента (промежуточным и финальным) в одном контексте недостаточно специфицирован в документации Responses API, и при тестировании у части моделей и провайдеров инференса случались отказы обработки такого формата. Асинхронная модель вызовов также добавляет архитектурную сложность по сравнению с типовыми SDK, это осознанный компромисс ради экономии, а не бесплатное улучшение.