TorchNeuron на AWS Trainium: как профилировать PyTorch и найти узкие места
В блоге Hugging Face опубликована первая часть серии о профилировании на AWS Trainium, специализированном ИИ-чипе для обучения и инференса. Работа идёт через TorchNeuron, открытый нативный бэкенд PyTorch для Trainium. По словам автора поста, он поддерживает обычные сценарии PyTorch (eager-режим, torch.compile, стандартные API) с минимальными правками кода, а через Neuron Kernel Interface (NKI) позволяет делать собственные операторы. Пост рассчитан на тех, у кого нет опыта профилирования.
Сначала объясняется устройство бэкенда: Neuron подключается к PyTorch через точку расширения PrivateUse1, которая позволяет ускорителю встроиться во фреймворк без отдельного ключа диспетчеризации вроде cuda; пакет torch_neuronx регистрирует Neuron как нативный бэкенд. Затем настраивается профайлер: объект NeuronConfig задаёт, какие потоки данных (режимы DEVICE и RUNTIME) и какие NeuronCore записывать и куда писать результат; параметр correlate_device_time=True переносит время устройства в таблицу key_averages(). NeuronProfiler добавляет колбэк export_trace. В torch.profiler.profile нужно включить ProfilerActivity.PrivateUse1 и передать NeuronConfig как experimental_config. Расписание: wait=2, warmup=1, active=1 на четыре вызова prof.step(), записывается одна прогретая итерация. Внутри цикла обязателен torch.neuron.synchronize(): без него профайлер может выгрузить данные до завершения работы устройства, и столбец с временем Neuron окажется пустым.
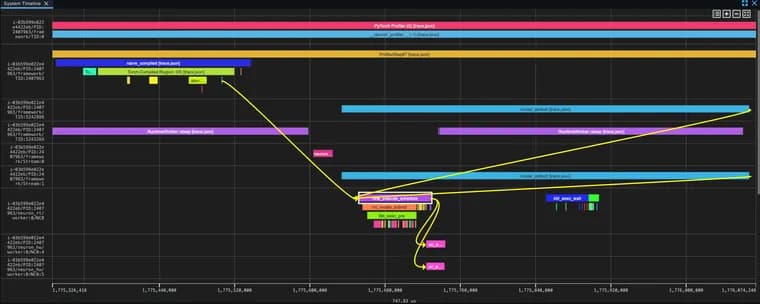
Для просмотра трассы служит Neuron Explorer, браузерный просмотрщик системной трассы, временной шкалы устройства и разбивки по движкам; он доступен через SSH-туннель или расширение Visual Studio Code. На выходе профилирования лежат системная трасса и парные файлы .neff (скомпилированный исполняемый файл) и .ntff (трасса аппаратных инструкций), связанные общим числовым хешем. В Explorer каждая операция ATen проходит через три дорожки: создание во фреймворке, планирование в рантайме (nrta_execute_schedule) и выполнение на устройстве (nc_exec_running); просмотрщик цепочки зависимостей позволяет проследить одну операцию, например aten::mul.Tensor, по всем слоям.
Эксперимент: три реализации RMSNorm на входе torch.randn(4, 512, dtype=torch.bfloat16). Профиль 1, наивный код из отдельных операций (умножение, mean, добавление эпсилон, rsqrt, умножение). В таблице key_averages() больше всего времени устройства занимает aten::mul, потому что функция делает три умножения (x * x, x * rms и умножение на weight); aten::add запускает копирование с хоста на устройство, так как скаляр изначально на CPU. Итого Self NEURON total, 2,355 мс. Профиль 2, встроенный torch.rms_norm, который Neuron сводит к одному объединённому ядру (kernel): 403,3 мкс, одна диспетчеризация и одно аппаратное событие без пауз между операциями. Профиль 3, тот же наивный код под @torch.compile(backend='neuron', fullgraph=True): TorchDynamo снимает байткод в граф FX, AOTAutograd сводит его к операциям ATen, бэкенд получает весь граф целиком, объединяет операции и компилирует в один артефакт NEFF, который запускается одной аппаратной диспетчеризацией. Результат, 375,5 мкс; автор называет это сопоставимым с torch.rms_norm (375 мкс против 403 мкс в этом запуске).
Вывод поста: в этих запусках любой из двух подходов занимает около одной шестой времени устройства наивной реализации. Слияние убирает паузы между аппаратными выполнениями и не требует материализовать промежуточные значения вроде x_sq и mean_sq между раздельными операциями. Предлагаемый порядок работы для больших моделей: найти горячую точку в таблице, проверить её в трассе и решить, поможет ли объединённая операция или torch.compile. Во второй части обещан разбор на уровне устройства: открыть NEFF, посмотреть разбивку по TensorEngine, VectorEngine и прямому доступу к памяти (DMA) и поместить ядро на модель roofline, чтобы понять, что его ограничивает, вычисления или память.
Ключевые факты
- TorchNeuron, открытый нативный бэкенд PyTorch для чипа AWS Trainium; подключается через точку расширения PrivateUse1 и поддерживает eager-режим и torch.compile.
- Профайлер настраивается через NeuronConfig и NeuronProfiler; в цикле нужен torch.neuron.synchronize(), иначе столбец со временем Neuron может остаться пустым.
- Наивный RMSNorm из отдельных операций: Self NEURON total 2,355 мс, больше всего времени у трёх вызовов aten::mul.
- torch.rms_norm даёт 403,3 мкс, а тот же наивный код под torch.compile, 375,5 мкс; оба около одной шестой времени наивной версии в этих запусках.
- Измерения сделаны на крошечной операции (тензор 4×512, bfloat16); во второй части обещан разбор на уровне устройства (NEFF, TensorEngine, VectorEngine, DMA, roofline).
Почему это важно
Многие знают, как ускорять модели, но реже умеют разбираться, почему они медленные. Пост показывает воспроизводимый порядок действий на Trainium: таблица key_averages() показывает, какие операции занимают время устройства, а Neuron Explorer, что происходит между диспетчеризациями. Наглядный итог, слияние операций, будь то встроенная torch.rms_norm или torch.compile, сокращает время устройства для RMSNorm примерно до одной шестой в этих запусках.
Кому это важно
Разработчикам, которые запускают PyTorch-инференс на AWS Trainium или присматриваются к нему и не имеют опыта профилирования. Автор прямо говорит, что пост начинается с нуля. Для тех, кто работает на других ускорителях, материал интересен главным образом как пример методики.
Как это применить
Включите в torch.profiler.profile активность ProfilerActivity.PrivateUse1 и передайте NeuronConfig как experimental_config; используйте расписание wait=2, warmup=1, active=1 и вызывайте torch.neuron.synchronize() в цикле. Отсортируйте key_averages() по self_privateuse1_time_total, найдите горячую точку, проверьте её в Neuron Explorer (загрузите всю выходную папку для системного профиля или пару .neff и .ntff для профиля только устройства) и решите, поможет ли объединённая операция или torch.compile. Скрипты для воспроизведения лежат в каталоге примеров torch-neuronx.
Можно ли доверять
Это обучающий пост в блоге Hugging Face. Конкретный автор в тексте не назван: в конце есть благодарность Aritra Roy Gosthipaty за вдохновение начать серию и коллегам-рецензентам. Числа приведены с оговоркой «в этих запусках»; автор сам называет время torch.compile и torch.rms_norm сопоставимым и не утверждает, что одно из них в целом быстрее.
Риски и подводные камни
Одна шестая, результат на очень маленьком RMSNorm (тензор 4×512 в bfloat16); данных по более крупным моделям в посте нет, как нет и сравнения с GPU или другими ускорителями. Версия Trainium, тип инстанса и версии программного обеспечения в тексте не указаны. Без torch.neuron.synchronize() столбец со временем Neuron может оказаться пустым. Дата выхода второй части не названа.