TokenRouter: система для маршрутизации токенов между LLM ускоряет декодирование в 2,01, 64,15 раза
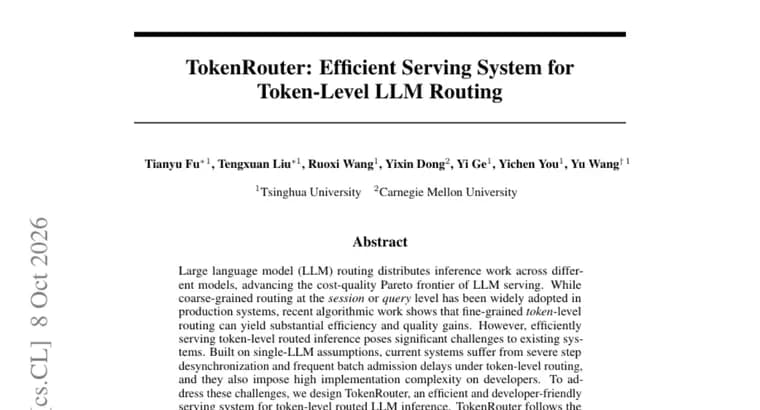
Маршрутизация LLM распределяет работу инференса между разными моделями и сдвигает границу Парето «стоимость, качество» при обслуживании нейросетей. Грубая маршрутизация на уровне сессии или запроса, как отмечают авторы, уже широко применяется в production-системах. Недавние алгоритмические работы показывают, что более тонкая маршрутизация на уровне отдельных токенов может дать существенный выигрыш по эффективности и качеству.
Проблема в том, что существующие системы обслуживания рассчитаны на одну модель. При токенной маршрутизации они, по словам авторов, страдают от сильной рассинхронизации шагов и частых задержек при допуске запросов в батч (пакет), а ещё усложняют работу разработчиков: реализовать такую маршрутизацию в них трудно.
В ответ авторы создали TokenRouter, систему обслуживания для инференса с токенной маршрутизацией, которая должна быть эффективной и удобной для разработчиков. Принцип назван «запрос-центричное программирование, модель-центричное выполнение»: разработчик описывает логику маршрутизации с точки зрения одного запроса, а среда выполнения запускает отдельный подсервер для каждой LLM и асинхронно распределяет запросы между ними. Каждый подсервер использует планировщик с отложенным батчингом (delayed batching); его оптимальные гиперпараметры выводятся из математической модели пропускной способности системы.
По заявлению авторов, на разных алгоритмах маршрутизации, нагрузках и парах моделей TokenRouter даёт в 2,01-64,15 раза более высокую пропускную способность декодирования, чем существующие системы. Код опубликован на GitHub: thu-nics/TokenRouter.
Ключевые факты
- TokenRouter, система обслуживания LLM, в которой маршрутизация между моделями идёт на уровне отдельных токенов, а не сессии или запроса.
- Авторы объясняют проблему тем, что существующие системы рассчитаны на одну модель: при токенной маршрутизации возникают рассинхронизация шагов и задержки допуска запросов в батч.
- Разработчик описывает маршрутизацию с точки зрения одного запроса, а среда выполнения запускает подсервер на каждую LLM и асинхронно раздаёт запросы.
- Каждый подсервер использует планировщик с отложенным батчингом, чьи гиперпараметры выводятся из математической модели пропускной способности.
- Заявленный выигрыш, в 2,01, 64,15 раза выше пропускная способность декодирования по сравнению с существующими системами; код доступен на GitHub.
Почему это важно
Грубая маршрутизация между моделями на уровне запроса уже распространена в production, а токенная, как пишут авторы, по алгоритмическим работам обещает выигрыш в эффективности и качестве. Но для неё не хватает системной основы: существующие серверы инференса рассчитаны на одну модель. TokenRouter, попытка закрыть этот пробел на уровне самой системы обслуживания.
Кому это важно
Командам, которые строят или эксплуатируют системы обслуживания LLM, и исследователям алгоритмов токенной маршрутизации, которым нужна среда, где такие алгоритмы можно запускать эффективно и без большой сложности реализации.
Как это применить
Код опубликован на GitHub: thu-nics/TokenRouter. Разработчик описывает логику маршрутизации с позиции одного запроса, а запуск подсерверов для каждой LLM и асинхронную раздачу запросов берёт на себя среда выполнения. Требования к оборудованию и условия лицензии в доступном описании не приведены.
Можно ли доверять
Это самоотчёт авторов в аннотации препринта: цифры 2,01-64,15 раза относятся к пропускной способности декодирования по сравнению с «существующими системами». Конкретные системы сравнения, алгоритмы, модели и нагрузки в тексте не названы, также не указано, к какому режиму относятся крайние значения диапазона и является ли он средним, медианным или максимальным. Независимой проверки в источнике нет, но открытый код позволяет повторить замеры.
Риски и подводные камни
Широкий диапазон ускорения (от 2,01 до 64,15 раза) говорит о сильной зависимости результата от конфигурации, а в какой именно ситуации получается верхняя граница, неизвестно. Заявлен выигрыш только по пропускной способности декодирования; результаты по задержке и качеству ответов в аннотации не приведены. Это препринт, и переносимость на ваши модели и нагрузки придётся проверять самостоятельно.