SenseNova-U1.5 объединила понимание и генерацию изображений в одной модели
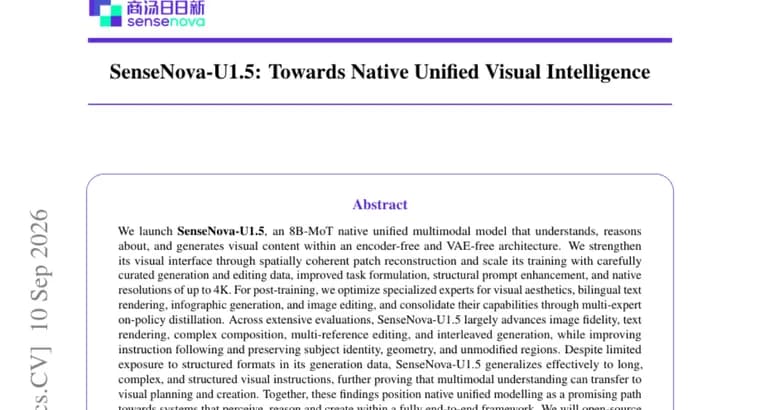
Исследователи представили SenseNova-U1.5, мультимодальную модель с архитектурным тегом «8B-MoT» (источник не говорит, что «B» означает параметры, и не раскрывает, что стоит за «MoT»). Модель задумана как «нативно единая» (native unified): без отдельного визуального энкодера и без вариационного автоэнкодера (VAE) она в одной архитектуре понимает визуальный контент, рассуждает о нём и генерирует изображения.
Авторы усилили визуальный интерфейс модели «пространственно согласованной реконструкцией патчей» (spatially coherent patch reconstruction) и масштабировали обучение на специально подобранных данных генерации и редактирования, с улучшенной постановкой задач, усилением структуры промптов (structural prompt enhancement) и нативным разрешением до 4K. На этапе дообучения команда отдельно настроила специализированных «экспертов», по визуальной эстетике, двуязычному рендерингу текста на изображениях, генерации инфографики и редактированию изображений, а затем объединила их способности методом дистилляции нескольких экспертов в режиме on-policy (on-policy distillation).
По словам авторов, по итогам обширных оценок SenseNova-U1.5 в основном продвигает вперёд точность передачи изображения, рендеринг текста, сложную композицию, редактирование по нескольким референсам (multi-reference editing) и чередующуюся генерацию (interleaved generation), одновременно лучше следуя инструкциям и сохраняя идентичность объекта, геометрию сцены и неизменённые области изображения. Конкретных числовых оценок, названий бенчмарков или сравнений с другими моделями источник не приводит, все улучшения описаны только качественно.
Отдельно авторы отмечают: несмотря на ограниченное присутствие структурированных форматов в данных для генерации, SenseNova-U1.5 хорошо обобщается на длинные, сложные и структурированные визуальные инструкции. Они видят в этом ещё одно подтверждение того, что мультимодальное понимание переносится на визуальное планирование и создание контента, и на этом основании называют «нативно единое» моделирование перспективным, но не окончательно доказанным, путём к системам, которые воспринимают, рассуждают и создают контент в рамках полностью сквозной архитектуры.
Команда сообщает, что откроет исходный код обучения, включая обучение с учителем (supervised fine-tuning), обучение с подкреплением (reinforcement learning) и дистилляцию в режиме on-policy. Источник не называет ни сроков публикации, ни репозитория и не говорит прямо, будут ли открыты веса самой модели, обещание касается именно кода обучения.
Текст публикации написан от первого лица множественного числа («we launch…») на HuggingFace Papers и не называет ни компанию, ни институт, стоящие за проектом. Первым в списке авторов значится Хайвэнь Дяо (Haiwen Diao), но, судя по формулировкам источника, это один из соавторов, а не единственный автор работы.
Ключевые факты
- SenseNova-U1.5, мультимодальная модель с тегом «8B-MoT»: без отдельного визуального энкодера и без VAE она в одной архитектуре понимает, рассуждает и генерирует визуальный контент.
- Обучение масштабировано на подобранных данных генерации и редактирования с нативным разрешением до 4K; отдельно дообучены эксперты по эстетике, двуязычному рендерингу текста, инфографике и редактированию изображений, объединённые дистилляцией нескольких экспертов в режиме on-policy.
- По заявлению авторов, модель в основном улучшает точность изображения, рендеринг текста, сложную композицию, редактирование по нескольким референсам и чередующуюся генерацию, но источник не приводит ни одной цифры, бенчмарка или сравнения с другими моделями.
- Авторы отмечают, что модель хорошо обобщается на сложные структурированные визуальные инструкции, и считают это подтверждением того, что мультимодальное понимание переносится на генерацию и планирование визуального контента.
- Команда обещает открыть исходный код обучения (SFT, RL, on-policy дистилляция), без сроков и репозитория, и без ответа на вопрос, будут ли открыты веса самой модели; ни компания, ни институт за проектом в тексте не названы.
Почему это важно
SenseNova-U1.5 пробует объединить в одной архитектуре то, что обычно разносят по отдельным модулям: понимание изображений, рассуждение о них и генерацию нового визуального контента, без отдельного визуального энкодера и без VAE. Отдельный акцент авторов, точный рендеринг текста внутри изображений и работа с разрешением до 4K, то есть задачи, где генеративные модели обычно теряют качество. Сами авторы формулируют свою работу как аргумент в пользу «нативно единого» подхода к мультимодальным моделям, построения модели изначально как одной системы, а не «сшивания» отдельных энкодера и генератора; в тексте это прямо названо перспективным путём к системам, которые воспринимают, рассуждают и создают контент в одной сквозной архитектуре, но не выдаётся за окончательно решённую задачу.
Кому это важно
Инженерам и исследователям, которые строят или выбирают мультимодальные генеративные системы, особенно там, где одновременно нужны понимание изображения, его редактирование по нескольким референсам и точный текст на картинке (инфографика, дизайн, локализация). Командам, которые сравнивают архитектуры без отдельного визуального энкодера и VAE с более традиционными пайплайнами из нескольких моделей. Тем, кто впоследствии сможет воспроизвести часть подхода по обещанному открытому коду обучения (SFT, RL, on-policy дистилляция), если и когда команда его опубликует.
Как это применить
Применить модель на практике сегодня нельзя: источник не говорит, опубликованы ли веса самой модели, есть ли к ней доступ через API или демо, и не даёт ссылок на код или чекпоинты. Команда обещает открыть только исходный код обучения, без даты и без ссылки на репозиторий. Единственное, с чем можно работать сейчас, сама публикация на HuggingFace Papers с описанием архитектуры и подхода к обучению; тем, кому нужен рабочий инструмент, стоит дождаться подтверждённого релиза кода или весов.
Можно ли доверять
Текст написан самими авторами от первого лица («we launch…») и опубликован как препринт на HuggingFace Papers, без указания компании или института за проектом и без упоминания независимой рецензии. Все заявленные улучшения (точность изображения, рендеринг текста, композиция, редактирование, следование инструкциям) описаны только качественно: источник не приводит ни одного бенчмарка, числовой оценки или сравнения с другими моделями, так что масштаб улучшений проверить по самому тексту нельзя. Первым в списке авторов публикации значится Хайвэнь Дяо (Haiwen Diao), но это, судя по формулировкам источника, один из соавторов, а не единственный автор работы.
Риски и подводные камни
Тег «8B-MoT» в тексте не раскрыт: неясно, о параметрах ли модели идёт речь и что означает «MoT», судить о реальном размере и устройстве архитектуры по одному этому ярлыку нельзя. Обещание открыть код касается только обучения (SFT, RL, on-policy дистилляция): источник не говорит, будут ли открыты веса самой модели, и не называет ни сроков, ни репозитория, так что обещание может остаться нереализованным или частичным. Заявленные улучшения, качественные, без чисел и без сравнения с другими моделями, поэтому реальный прирост качества нельзя оценить со стороны до появления независимых тестов.
«Эти результаты позволяют рассматривать нативно единое моделирование как перспективный путь к системам, которые воспринимают, рассуждают и создают контент в рамках полностью сквозной архитектуры.»
— авторы SenseNova-U1.5, в описании работы на HuggingFace Papers