Саймон Уиллисон выпустил datasette-arrows 0.1a0: экспорт в Arrow для Datasette
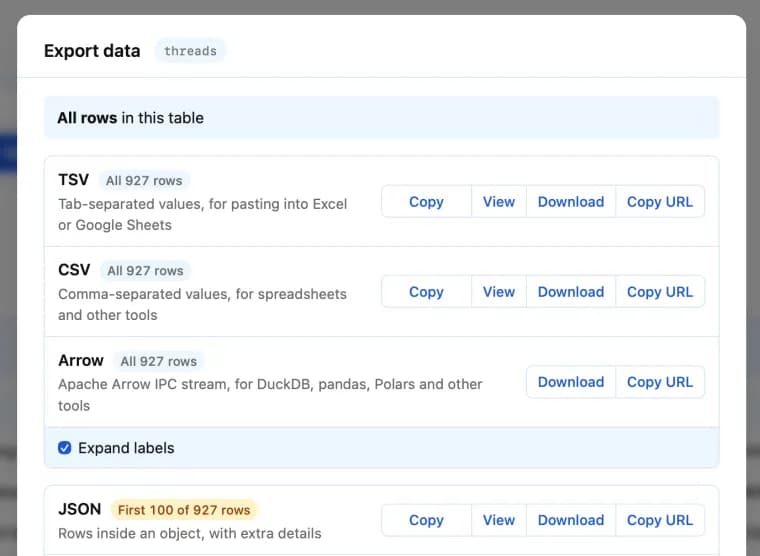
Саймон Уиллисон (запись от 18 ноября 2026 года) представил datasette-arrows 0.1a0, плагин для Datasette. Он добавляет в диалог экспорта новый вариант: потоковую выгрузку в формате Apache Arrow.
Контекст такой. В версии Datasette 1.0a43 появилась возможность реализовывать потоковые форматы экспорта в плагинах. Ядро Datasette уже умеет потоково выгружать CSV и TSV: из таблицы можно экспортировать миллионы строк, не загружая их целиком в память, потому что эти два формата допускают передачу данных частями. Хук register_output_renderer() теперь позволяет повторить тот же приём для других форматов. Плагин datasette-arrows применяет этот приём к формату Arrow.
Уиллисон поясняет, почему выпустил плагин сразу: он взял за правило никогда не выпускать новую возможность для плагинов без плагина, который ею пользуется. Выбор формата и реализацию он приписывает модели Claude Fable 5.2: по его словам, она предложила потоковый формат Apache Arrow как хороший вариант и написала плагин почти с одного захода.
Установка: datasette install datasette-arrows. После этого в диалоге экспорта появляется пункт Arrow. Скриншот в записи сделан на основной ветке (main) Datasette. В последнем релизе потоковые форматы вроде Arrow пока не сгруппированы с TSV и CSV в разделе «All rows in this table» («Все строки этой таблицы»). Автор пишет, что это появится в следующем альфа-релизе.
Ключевые факты
- Саймон Уиллисон выпустил datasette-arrows 0.1a0: плагин добавляет в диалог экспорта Datasette вариант Arrow.
- Плагин опирается на возможность, добавленную в Datasette 1.0a43: плагины могут реализовывать потоковые форматы экспорта через хук register_output_renderer().
- Ядро Datasette уже потоково выгружает CSV и TSV: миллионы строк из таблицы можно экспортировать без загрузки всего в память.
- По словам автора, формат Apache Arrow предложила модель Claude Fable 5.2, и она же написала плагин почти с одного захода.
- Установка: datasette install datasette-arrows; на скриншоте основная ветка Datasette, в последнем релизе группировка потоковых форматов пока не готова и ожидается в следующем альфа-релизе.
Почему это важно
Событие небольшое, но показательное: плагин доказывает, что новая возможность Datasette 1.0a43 работает. Теперь сторонние плагины могут добавлять потоковый экспорт не только в CSV и TSV, как в ядре, но и в другие форматы. Здесь выбран Apache Arrow. Заодно это пример подхода автора: каждая новая возможность для плагинов выходит вместе с плагином, который её использует.
Кому это важно
Пользователям Datasette, которым нужно выгружать большие таблицы в формате Arrow. Авторам плагинов, которые хотят реализовать собственный потоковый формат через register_output_renderer(): datasette-arrows служит рабочим образцом. Тем, кто следит за практикой разработки с помощью ИИ: автор прямо говорит, что Claude Fable 5.2 собрала плагин почти с одного захода.
Как это применить
Добавьте плагин в Datasette командой datasette install datasette-arrows. После установки в диалоге экспорта появится новый вариант Arrow. Учтите, что скриншот в записи сделан на основной ветке: в последнем релизе потоковые форматы пока не сгруппированы с TSV и CSV в разделе «All rows in this table», это обещано в следующем альфа-релизе. Авторам собственных форматов экспорта нужна Datasette версии 1.0a43 или новее.
Можно ли доверять
Источник, личная запись самого автора плагина, написанная от первого лица. Утверждения о том, что формат предложила и плагин почти с одного захода написала Claude Fable 5.2, его собственная оценка. Подробности сессии, промптов и объёма ручной правки не приведены, их проверить нельзя. Цифр производительности, размеров файлов и замеров в тексте нет. Заявление о миллионах строк относится к потоковому экспорту CSV и TSV в ядре, а не к Arrow-плагину.
Риски и подводные камни
Версия 0.1a0 помечена как альфа, поэтому поведение и интерфейс могут меняться. В последнем релизе Datasette пункт Arrow пока не сгруппирован с TSV и CSV в нужном разделе диалога, это ожидается только в следующем альфа-релизе, и срок не назван. Производительность выгрузки в Arrow в тексте не измерялась. Генерация кода моделью почти с одного захода не отменяет необходимости самостоятельно проверить плагин перед использованием на рабочих данных.
«Я усвоил: никогда не выпускать новую возможность для плагинов без плагина, который ею пользуется.»
— Саймон Уиллисон