RSIAgent помог Kimi-K3 и GLM-5.3 обойти GPT-6 в тестах
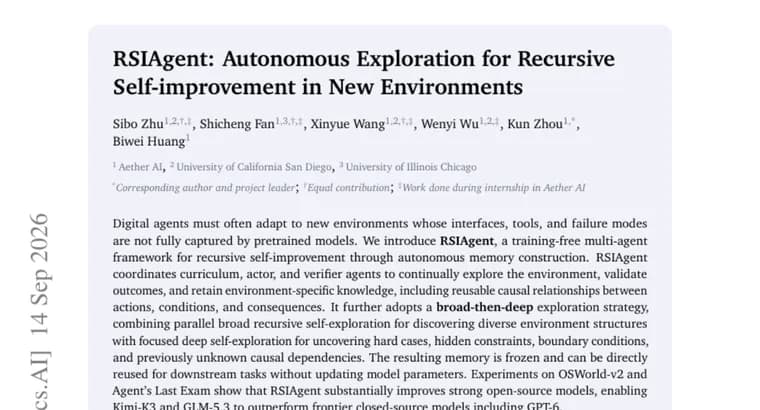
RSIAgent, training-free (то есть не требующий дообучения весов модели) мультиагентный фреймворк для рекурсивного самосовершенствования цифровых агентов в новых средах. Вместо того чтобы менять параметры модели под каждую новую среду, система автономно строит память об этой среде и переиспользует накопленные знания.
Фреймворк координирует агентов трёх ролей: куратор (curriculum) задаёт программу исследования, исполнитель (actor) действует в среде, а проверяющий (verifier) валидирует результаты. Вместе они постоянно исследуют среду и сохраняют специфичные для неё знания, в том числе переиспользуемые причинно-следственные связи между действиями, условиями и последствиями.
Исследование среды устроено по стратегии «сначала широко, потом глубоко» (broad-then-deep): параллельное широкое рекурсивное самоисследование находит разнообразные структуры среды, а сфокусированное глубокое самоисследование вскрывает сложные случаи, скрытые ограничения, граничные условия и ранее неизвестные причинно-следственные зависимости. Построенная таким образом память «замораживается» и напрямую переиспользуется для последующих задач без обновления параметров модели.
На бенчмарках OSWorld-v2 и Agent's Last Exam RSIAgent, по словам авторов, существенно улучшает сильные открытые модели: с его помощью Kimi-K3 и GLM-5.3 обходят закрытые модели переднего края, включая GPT-6. Конкретных числовых показателей улучшения, баллов, процентов, доли решённых задач, в тексте не приведено, есть только качественное утверждение о превосходстве. Имена авторов и организация в самом тексте работы не указаны, как и сроки выхода или версия фреймворка.
Ключевые факты
- RSIAgent, training-free мультиагентный фреймворк: агенты-куратор, исполнитель и проверяющий вместе исследуют новую среду и строят память без изменения весов модели.
- Стратегия «сначала широко, потом глубоко»: широкое параллельное исследование структур среды сочетается с глубоким исследованием сложных случаев и скрытых ограничений.
- Построенная память замораживается и переиспользуется напрямую для новых задач, без дообучения модели.
- На бенчмарках OSWorld-v2 и Agent's Last Exam фреймворк, по заявлению авторов, помогает открытым моделям Kimi-K3 и GLM-5.3 обойти закрытые модели переднего края, включая GPT-6.
- Числовых показателей улучшения, имён авторов и сроков выпуска в тексте источника нет.
Почему это важно
Цифровые агенты часто сталкиваются с новыми интерфейсами, инструментами и сценариями сбоев, которые не заложены в предобученную модель. RSIAgent предлагает обойтись без дообучения: вместо изменения весов модель «запоминает» среду через самостоятельное исследование, строит причинно-следственные связи между действиями и их последствиями и переиспользует эти знания дальше. Это избавляет от необходимости дообучать модель под каждую новую среду.
Кому это важно
Разработчикам ИИ-агентов и командам, которые разворачивают агентов в незнакомых цифровых средах, десктопных интерфейсах, веб-приложениях, новых инструментах, и хотят обойтись открытыми моделями вместо закрытых платных API. Полезно и исследователям агентных систем, которые ищут способ повышать качество модели без доступа к её весам.
Как это применить
Фреймворк координирует три роли агентов, куратор задаёт программу исследования, исполнитель действует в среде, проверяющий валидирует результат. Сначала идёт широкое параллельное самоисследование, которое находит разные структуры среды, затем, сфокусированное глубокое исследование, вскрывающее сложные случаи и скрытые ограничения. Построенная так память замораживается и подключается к модели напрямую для последующих задач без обновления параметров, то есть встраивается как внешний слой памяти поверх уже существующей модели.
Можно ли доверять
Источник, аннотация научной работы без указания авторов и организации в самом тексте, публикация пока набрала немного внимания (16 баллов, 1 комментарий на Hugging Face). Заявление о превосходстве Kimi-K3 и GLM-5.3 над GPT-6, самоотчёт авторов работы, а не независимая проверка, и не подкреплено конкретными цифрами: сказано только «существенно улучшает», без баллов или процентов.
Риски и подводные камни
Без числовых показателей нельзя оценить, насколько велико заявленное превосходство и на каких именно задачах оно проявляется. Качество training-free подхода зависит от того, насколько полно агент успевает исследовать конкретную среду во время работы, в средах со скрытыми ловушками или ограниченным временем на исследование результат может оказаться хуже заявленного. Данных о сроках выхода, версии или доступности кода фреймворка в тексте нет.