Разработчик Platypush заменил openWakeWord на microWakeWord в голосовом ассистенте
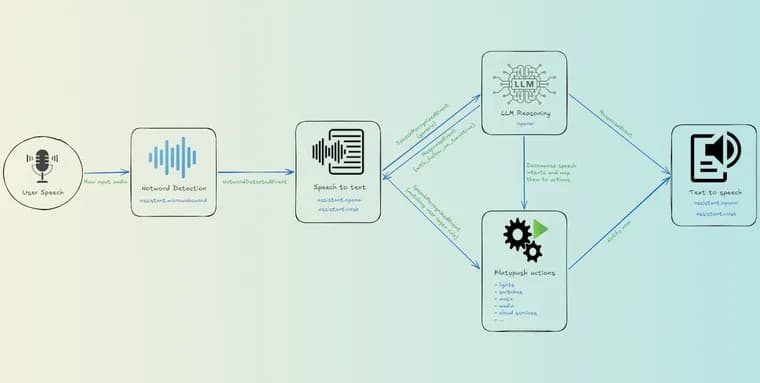
Автор блога Platypush описывает очередную переделку своего самостоятельно развёрнутого голосового ассистента на Raspberry Pi. Пару месяцев он пользовался предыдущей версией конвейера как основной, но после привычки к надёжности коммерческих ассистентов его перестали устраивать частые ложные срабатывания и пропуски слова активации, а также слабое определение начала и конца речи, особенно в шумной обстановке и с дешёвыми микрофонами. После нескольких дней опытов с новой конфигурацией он счёл результат достаточно удовлетворительным, чтобы написать об этом короткую статью.
Первое изменение, детектор слова активации. Раньше использовался плагин assistant.openwakeword (обёртка над openWakeWord). По словам автора, проект давно затих, а все готовые модели, файлы версии v0.1 из 2023 года, обученные в основном на синтетической речи. На практике он получал и ложные срабатывания на фоновый шум, и пропуски, если не находился рядом с микрофоном. Вместо него автор добавил плагин assistant.microwakeword поверх microWakeWord через Python-привязки pymicro-wakeword. По его словам, microWakeWord используют ESPHome и Home Assistant Voice, его модели активно поддерживаются, а встроенные модели (okay_nabu, hey_jarvis, hey_mycroft, alexa) идут в составе пакета без отдельной загрузки. Можно подключать и свои модели: JSON-манифест с файлом .tflite кладётся в каталог моделей плагина. API плагина совпадает с assistant.openwakeword (те же параметры models, detection_threshold, frame_duration, patience_frames, input_device, input_volume, то же действие list_models и то же событие HotwordDetectedEvent), поэтому переход сводится к смене конфигурации. Среди деталей: без явного detection_threshold каждая модель берёт порог probability_cutoff из своего манифеста (0,9 для alexa); модели уже сглаживают выход скользящим окном, поэтому patience_frames здесь по умолчанию равен 0; аудиопоток не обращается к моделям TFLite напрямую, а передаёт кадры в главный поток через очередь, потому что MicroWakeWord.reset() перезагружает интерпретатор и небезопасен при одновременном вызове; плагин, как и openwakeword, освобождает аудиоустройство, когда другой плагин ассистента начинает разговор, и забирает его обратно по окончании.
Второе изменение, распознавание речи (assistant.openai, транскрипция через Whisper) и определение конца речи. Прежняя реализация брала покадровое булево значение от WebRTC VAD (детектора речевой активности): любой кадр, признанный речью, сбрасывал таймер тишины, и при малейшем фоновом шуме фраза заканчивалась лишь по достижении максимальной длительности разговора. Общий слой AudioPreprocessor, который используют все плагины распознавания, переработан: основным детектором стал Silero VAD (через onnxruntime, PyTorch не нужен), запасными, WebRTC VAD и простой детектор по уровню громкости (RMS); выбор идёт автоматически в порядке silero, webrtc, energy. Модель Silero скачивается при первом использовании в рабочий каталог Platypush с проверкой контрольной суммы. Добавлены гистерезис (кадр становится речью выше порога и остаётся ей, пока оценка не упадёт на заданную величину) и сглаживание голосованием по большинству в окне 0,5 с, так что одиночный всплеск шума больше не удерживает разговор открытым. Добавлен и адаптивный уровень фонового шума: кадры не громче noise_floor_factor (по умолчанию 2,0, примерно 6 дБ), умноженного на отслеживаемый уровень шума, никогда не считаются речью.
На синтетическом тесте (фразы, сгенерированные Piper, смешанные с гулом голосов и импульсными шумами) старые настройки держали разговор открытым 6-10 секунд после окончания речи, а новый конвейер закрывает его через 1,0-1,6 секунды после последнего слова, это заданный conversation_end_timeout плюс задержка сглаживания. Поскольку изменения сделаны в общем AudioPreprocessor, выигрывают и другие плагины распознавания, например assistant.vosk для полностью локального распознавания.
Дальше конвейер без изменений: распознанная фраза обрабатывается плагином openai (ключ API и контекст беседы), ответ озвучивается через настроенный tts_plugin, а если ответ заканчивается вопросительным знаком, разговор продолжается. Свои обработчики могут перехватывать фразы до ответа по умолчанию, например для локального управления домашней автоматикой без обращения к языковой модели; событие слова активации связывается со стартом разговора таким же обработчиком. Озвучивание, tts.openai; в тестах автора tts.piper тоже дал хороший результат и работает полностью локально, но на Raspberry Pi 5 добавил около 3-4 секунд задержки по сравнению с tts.openai. На время разговора плагины ассистента приостанавливают обнаружение слова активации, иначе ассистент слышал бы сам себя.
Из прочих правок в коде: в assistant.openwakeword кадры теперь по 80 мс (1280 отсчётов, как рекомендует openWakeWord) вместо 500 мс, потому что длинные куски возвращают лишь максимальную оценку своих подкадров и могут пропускать слово; добавлены параметр patience_frames и явный detection_threshold (по умолчанию 0,5); написана новая обёртка Silero VAD с ONNX-выводом и состоянием, переносимым между кадрами.
Оговорки автора: микрофон на его Raspberry Pi не поддерживает 16 кГц, поэтому звук захватывается на 44,1 кГц и программно пересчитывается; это работает, но при вялом отклике обнаружения первым подозреваемым стоит считать именно пересчёт. Значения VAD и порогов подбирались на синтетическом звуке и нескольких собственных записях автора, в других помещениях и с другими микрофонами результат может отличаться; при недовольстве стоит подстроить detection_threshold у плагина слова активации и noise_floor_factor у плагинов распознавания речи.
Ключевые факты
- Автор Platypush добавил плагин assistant.microwakeword на основе microWakeWord (его используют ESPHome и Home Assistant Voice) вместо assistant.openwakeword, у которого все готовые модели, v0.1 из 2023 года; API тот же, переход, правка конфигурации.
- Общий AudioPreprocessor переработан: Silero VAD через onnxruntime как основной детектор речи, гистерезис, сглаживание голосованием по большинству в окне 0,5 с и адаптивный уровень шума (noise_floor_factor по умолчанию 2,0, около 6 дБ).
- На синтетическом тесте старые настройки держали разговор открытым 6-10 секунд после конца речи, новые закрывают его через 1,0-1,6 секунды после последнего слова.
- В assistant.openwakeword кадры уменьшены с 500 до 80 мс, добавлены patience_frames и detection_threshold (по умолчанию 0,5).
- Пороги и параметры VAD подбирались на синтетическом звуке и нескольких записях автора; в других условиях их может понадобиться подстроить.
Почему это важно
Главная боль самостоятельных голосовых ассистентов, ненадёжность по сравнению с коммерческими: слово активации срабатывает на шум или не срабатывает, а разговор не закрывается после конца речи. Автор показывает конкретный путь исправления: смена движка слова активации на поддерживаемый и переработка определения конца речи. По его синтетическому тесту, задержка закрытия разговора после окончания речи снизилась с 6-10 до 1,0-1,6 секунды. Поскольку правки внесены в общий слой AudioPreprocessor, выигрывают и другие плагины распознавания речи, например assistant.vosk.
Кому это важно
Тем, кто собирает собственный голосовой ассистент на Raspberry Pi и особенно использует Platypush. Заметка полезна и всем, кто выбирает движок слова активации (microWakeWord против openWakeWord) или детектор речевой активности (Silero VAD против WebRTC VAD): автор объясняет, почему покадровое решение без сглаживания плохо работает в шуме и как это лечат гистерезисом, голосованием в окне и отслеживанием уровня шума.
Как это применить
Если вы уже пользуетесь assistant.openwakeword в Platypush, достаточно указать в конфигурации assistant.microwakeword с нужными моделями (например, alexa): параметры и событие те же. Встроенные модели, okay_nabu, hey_jarvis, hey_mycroft, alexa; свою модель можно подключить через JSON-манифест с файлом .tflite. Выбор детектора речи задаётся параметром vad_backend (auto перебирает silero, webrtc, energy в зависимости от того, что установлено). Если нужна полностью локальная работа, автор предлагает assistant.vosk для распознавания и tts.piper для озвучивания; на Raspberry Pi 5 tts.piper добавил в его тестах около 3-4 секунд задержки по сравнению с tts.openai. В основной конфигурации статьи распознавание через Whisper и озвучивание идут через OpenAI с ключом API. Если результат не устраивает, подстраивайте detection_threshold у плагина слова активации и noise_floor_factor у плагинов распознавания речи.
Можно ли доверять
Это личный технический блог разработчика проекта, описывающий его собственные изменения и впечатления. Имя автора в тексте не указано. Цифра 1,0-1,6 секунды против 6-10 получена только на синтетическом тесте, а измерений на реальных записях не приводится. Сравнение openWakeWord и microWakeWord по ложным срабатываниям и пропускам качественное, без цифр. Данных о задержке, точности или нагрузке на процессор для нового плагина на Raspberry Pi нет. Название выпуска Platypush, в который вошли правки, не указано.
Риски и подводные камни
Значения порогов и параметров VAD подобраны на синтетическом звуке и нескольких записях автора, поэтому в других помещениях и с другими микрофонами результат может отличаться. Микрофон на Raspberry Pi автора не поддерживает 16 кГц: звук захватывается на 44,1 кГц и пересчитывается программно, и при вялом обнаружении этот пересчёт стоит проверять первым. Конвейер из основной конфигурации не полностью локальный: распознавание через Whisper и озвучивание tts.openai идут через OpenAI, а локальные варианты, assistant.vosk и tts.piper, потребуют отдельной настройки, причём tts.piper медленнее на Raspberry Pi 5. Кроме того, плагин microWakeWord сам по себе не гарантирует отсутствия ложных срабатываний: автор оценивает результат после нескольких дней проверки как достаточно хороший для статьи.
«Значения VAD и порогов подбирались на синтетическом звуке и нескольких моих собственных записях. В других помещениях, с другими микрофонами и акустикой результат может отличаться.»
— Автор блога Platypush