Разбор Jev: по мнению автора, модель-классификатор быстрее и дешевле LLM
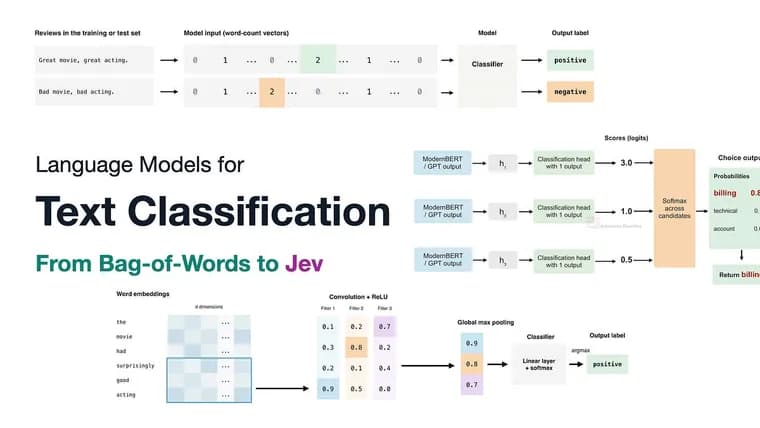
Недавно вышедшая ИИ-модель Jev, по словам автора статьи, последние две недели была настоящим культурным явлением в технических сообществах. Jev нацелена на классификацию, поэтому её легко отмахнуть как «просто классификатор». Сам автор признаётся, что его взгляд поменялся: от «классификаторы были моим хлебом, я легко сделаю такое сам» до «ого, это на самом деле работает лучше, чем я думал».
Позиция автора такова. Современные GPT и LLM с открытыми весами умеют те же задачи классификации и к тому же гораздо более общее принятие решений, но Jev справляется с классификацией заметно быстрее и дешевле. С другой стороны, для узкой чётко поставленной задачи Jev, скорее всего, не будет классифицировать ни лучше, ни быстрее, ни дешевле специализированного классификатора. Её козырь, куда большая универсальность по сравнению с узкими моделями. Автор обещает дальше в статье рассказать о методологии Jev (это будет его обоснованное предположение), о том, что модель умеет и почему так популярна. Он подчёркивает: Jev по сути текстовый классификатор, но не «просто» текстовый классификатор. Отдельно автор оговаривает, что никак не связан с Jev, бесплатного доступа ему не предлагали и статья не реклама продукта.
В доступной части материала (текст обрывается на разделе про свёрточные сети) автор идёт хронологически и разбирает классификацию текста до эпохи трансформеров.
Мешок слов. Около 15 лет назад, когда автор был аспирантом, текст обычно классифицировали через представление «мешок слов» (bag-of-words): оно превращает тексты разной длины в вектор фиксированного размера, который подходит классическим классификаторам, наивному Байесу, логистической регрессии, SVM, случайному лесу, XGBoost. Строится словарь всех уникальных слов обучающей выборки (при желании без стоп-слов вроде «a» и «the»), у каждого слова своя позиция в векторе, и считается, сколько раз слово встретилось. При словаре в 50 000 слов вектор будет из 50 000 элементов независимо от длины текста; большинство элементов нулевые. Вместо сырых счётчиков бывает нормализация вроде TF-IDF. Применения, от классификации новостей до почтового спам-фильтра; по слухам, даже исходный спам-фильтр Gmail использовал наивный Байес с мешком слов. Подход дёшев и хорош, когда отдельные слова сильно указывают на метку. Главный минус, потеря порядка слов: «the dog bites the man» и «the man bites the dog» дают одинаковые векторы. Частичное решение, n-граммы, но они раздувают словарь. Автор считает, что мешок слов всё ещё уместен в малозначимых задачах, а связка «мешок слов + логистическая регрессия» остаётся его базовым ориентиром для любой задачи классификации текста.
Глубокие сети. Мешок слов можно подать и простым нейросетям вроде многослойного перцептрона, но порядок слов так же теряется. Его сохраняют свёрточные (CNN) и рекуррентные (RNN) сети, принимающие на вход эмбеддинги слов. Эмбеддинг представляет отдельное слово плотным вектором обученных чисел (классические способы, Word2Vec и GloVe); такие эмбеддинги не зависят от контекста: у слова «bank» один и тот же вектор в «river bank» и «bank account».
Рекуррентные сети читают текст по одному слову, объединяя текущий эмбеддинг со скрытым состоянием предыдущего шага, поэтому порядок слов важен. Их варианты восходят к 1980-м и началу 1990-х; трансформеры, появившиеся в 2017 году, постепенно вытеснили их во многих задачах. RNN тяжело обучать, поэтому появились LSTM (1997) и GRU (2014), а совсем недавно, xLSTM (2024). Модели пространства состояний тоже используют идею скрытого состояния фиксированного размера: это дешевле внимания трансформера, но остаются ограничения по объёму удерживаемой информации и последовательной обработке.
Цифры на датасете рецензий IMDb: мешок слов с логистической регрессией дал около 89,9% точности (на сбалансированной выборке), LSTM-сеть, обученная с нуля, лишь 85,66%. Лучше сначала предобучить модель на большом наборе данных, а затем дообучить на целевом (перенос обучения). Одна из самых влиятельных работ такого рода, ULMFiT (2018), показавшая 95,4% точности на тесте IMDb. Последний доступный раздел начинает тему свёрточных сетей для текста: фильтр с окном из трёх слов применяет одни и те же веса к каждой группе из трёх соседних слов и скользит по входу. Всё, что идёт дальше (трансформеры и подробности о самой Jev), в доступном тексте отсутствует.
Ключевые факты
- Автор называет Jev культурным явлением в технических сообществах за последние две недели и считает её не «просто» классификатором, а куда более универсальным, чем узкие модели.
- По мнению автора, Jev быстрее и дешевле GPT и LLM с открытыми весами в задачах классификации, но для узкой чёткой задачи вряд ли обойдёт специализированный классификатор.
- Цифры на IMDb относятся к старым методам, а не к Jev: мешок слов с логистической регрессией, около 89,9%, LSTM с нуля, 85,66%, ULMFiT (2018), 95,4%.
- Мешок слов теряет порядок слов («собака кусает человека» и «человек кусает собаку» дают одинаковые векторы), но остаётся для автора базовым ориентиром.
- Автор заявляет, что не связан с Jev, бесплатного доступа не получал, а статья не реклама; методологию Jev он обещает изложить как обоснованное предположение.
Почему это важно
Автор описывает Jev как модель, которая заняла нишу между большими универсальными LLM и узкими специализированными классификаторами: быстрее и дешевле первых и общее вторых. Материал полезен как контекст: история классификации текста показывает, что именно Jev, по мнению автора, делает хорошо и чем всё это не является. Оговорка: в доступной части текста самой Jev почти нет, разбор её возможностей и методологии идёт позже и здесь не представлен.
Кому это важно
Разработчикам и аналитикам, которые решают задачи классификации текста (спам, тематики, тональность отзывов) и выбирают между простым базовым методом, специализированной моделью и вызовом большой LLM. Также тем, кто хочет понять, откуда взялись современные подходы: мешок слов, рекуррентные сети, перенос обучения.
Как это применить
Практический совет автора: начинать любую задачу классификации текста с базовой линии из мешка слов и логистической регрессии, её легко реализовать, она дёшева, а в примере с IMDb дала около 89,9% точности. Для перехода к более сложным методам автор указывает предобучение на большом наборе данных с последующим дообучением. Данных о доступности, цене и условиях использования Jev в доступном тексте нет.
Можно ли доверять
Это авторское объяснение, а не первоисточник о Jev. Автор заявляет, что не связан с Jev, бесплатного доступа не получал и не рекламирует продукт. Оценки Jev (быстрее и дешевле LLM, но не лучше узких моделей), его мнение, без приведённых в доступной части замеров скорости, стоимости и качества самой Jev. Методологию он сам называет обоснованным предположением. Текст источника обрывается, поэтому пересказаны только исторические разделы.
Риски и подводные камни
Цифры точности из статьи (89,9%, 85,66%, 95,4%) относятся к старым методам на датасете IMDb, их нельзя переносить на Jev. Сведения о том, кто создал Jev и когда, в доступном тексте не приводятся. Тезис об универсальности Jev пока подан без подтверждающих измерений, а утверждение о спам-фильтре Gmail автор сам сопровождает словом «по слухам».
«Ого, это на самом деле работает лучше, чем я думал.»
— автор статьи о своём изменившемся взгляде на Jev