Представлена Xiaomi-Lens-0: модель 4B на базе Qwen3.5 сама строит маски областей
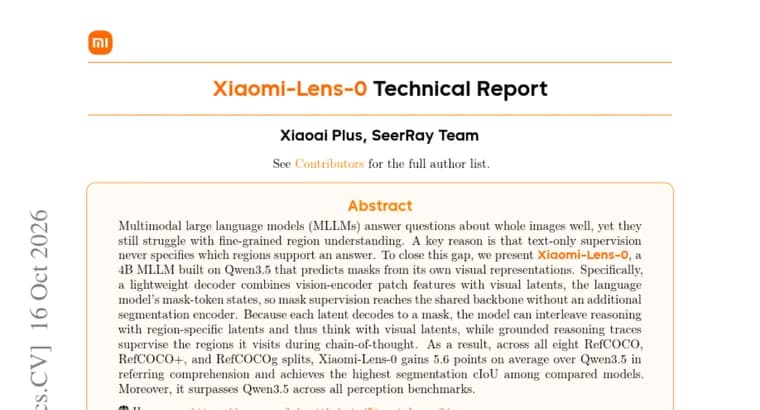
Мультимодальные большие языковые модели (MLLM) хорошо отвечают на вопросы о картинке целиком, но по-прежнему плохо справляются с тонким пониманием отдельных областей изображения. По мнению авторов отчёта, одна из ключевых причин, обучение только на тексте: оно никогда не указывает, какие именно области изображения подтверждают ответ.
Чтобы закрыть этот пробел, представлена Xiaomi-Lens-0, модель размера 4B, построенная на Qwen3.5. Она предсказывает маски (контуры нужных областей) по собственным визуальным представлениям. Устроено это так: лёгкий декодер объединяет признаки патчей из визуального энкодера с «визуальными латентами», состояниями маска-токенов языковой модели. Благодаря этому обучающий сигнал от масок доходит до общего базового блока модели, и отдельный сегментационный энкодер не нужен.
Поскольку каждый латент декодируется в маску, модель может вплетать в рассуждение латенты, привязанные к конкретным областям, то есть «думать визуальными латентами». Размеченные «заземлённые» цепочки рассуждений при этом обучают модель отслеживать те области, которые она проходит в ходе цепочки рассуждений (chain-of-thought).
Результаты, заявленные авторами: по всем восьми сплитам RefCOCO, RefCOCO+ и RefCOCOg Xiaomi-Lens-0 в среднем на 5,6 пункта опережает Qwen3.5 в понимании указаний на объект (referring comprehension) и показывает наивысшую метрику сегментации cIoU среди сравниваемых моделей. Кроме того, она превосходит Qwen3.5 на всех бенчмарках восприятия. В тексте приведена ссылка на домашнюю страницу проекта.
Ключевые факты
- Xiaomi-Lens-0, мультимодальная модель размера 4B на базе Qwen3.5, которая предсказывает маски по собственным визуальным представлениям.
- Лёгкий декодер объединяет признаки патчей визуального энкодера и состояния маска-токенов языковой модели; отдельный сегментационный энкодер не нужен.
- Каждый латент декодируется в маску, поэтому модель может вплетать в рассуждение латенты конкретных областей и «думать визуальными латентами».
- По всем восьми сплитам RefCOCO, RefCOCO+ и RefCOCOg средний прирост над Qwen3.5 в понимании указаний на объект, 5,6 пункта.
- Авторы заявляют наивысший cIoU среди сравниваемых моделей и превосходство над Qwen3.5 на всех бенчмарках восприятия.
Почему это важно
Тонкое понимание отдельных областей изображения остаётся слабым местом мультимодальных моделей: на вопросы о картинке целиком они отвечают хорошо. Авторы связывают это с тем, что обучение только на тексте не показывает, какие области подтверждают ответ. Xiaomi-Lens-0 предлагает добавить в обучение маски и использовать их прямо внутри рассуждения, не наращивая модель отдельным сегментационным энкодером.
Кому это важно
Исследователям мультимодальных моделей, работающим над локализацией объектов, сегментацией и привязкой ответа к областям изображения. Также тем, кто следит за развитием семейства Qwen и сравнивает, как базовую модель можно дообучить под понимание областей.
Как это применить
Это технический отчёт с домашней страницей проекта (seerray-lab.github.io/Xiaomi-Lens-0). Из текста источника не следует ничего о весах, лицензии или готовности модели к использованию, поэтому практический шаг сейчас, изучить страницу проекта и сам отчёт и проверить заявленные результаты на своих данных.
Можно ли доверять
Все цифры и выводы, заявления авторов в аннотации препринта, независимой проверки в источнике нет. Приведён только один количественный результат: средний прирост 5,6 пункта над Qwen3.5 по восьми сплитам RefCOCO-семейства. Абсолютные значения метрик не указаны; не названы модели, с которыми сравнивали cIoU, и бенчмарки восприятия, на которых модель превосходит Qwen3.5, а также размер и вариант базовой модели Qwen3.5. Авторы и организации в аннотации не названы.
Риски и подводные камни
Заявление «наивысший cIoU среди сравниваемых моделей» зависит от набора сравниваемых моделей, который в аннотации не раскрыт. Прирост в 5,6 пункта, среднее по сплитам и разность в пунктах, а не процент от базового уровня. Сведений о вычислительной стоимости, скорости работы и процедуре обучения в источнике нет, так что оценить цену подхода по нему нельзя.