Представлена LensErase: модель стирает объекты на фото по маске
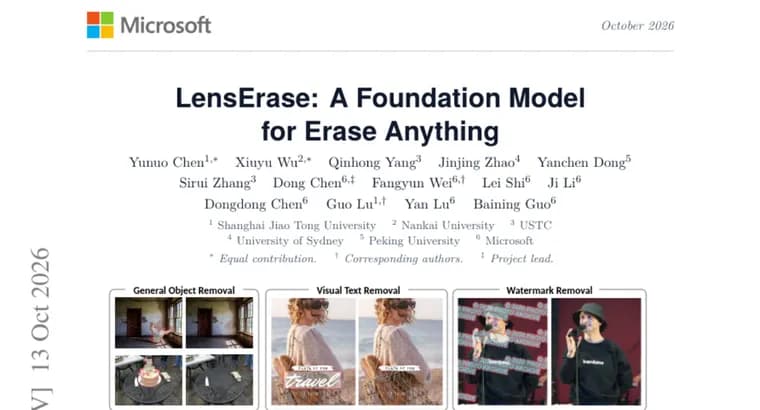
В препринте представлена LensErase, универсальная базовая модель класса «Erase Anything» (стереть что угодно), которая удаляет фрагменты изображения по заданной маске. Авторы заявляют, что она рассчитана на широкий круг реальных сценариев: разные объекты, визуальный текст, водяные знаки, сопутствующие визуальные эффекты, удаление сразу нескольких объектов, а также разные масштабы объектов, соотношения сторон и разрешения изображений.
Работа состоит из нескольких частей. Во-первых, авторы собрали датасет LensErase-100M: 101,07 млн парных примеров вида «исходное изображение, маска, результат», охватывающих разные сценарии удаления. Во-вторых, модель дообучена на основе text-to-image модели Lens: так авторы переносят сильную генеративную способность базовой модели на задачу стирания по маске.
Для эффективной подачи исходного изображения и маски предложен приём Mask-Aware RoPE, трёхмерное ротационное позиционное кодирование, которое встраивает информацию о маске прямо в токены исходного изображения и не требует отдельной последовательности токенов для маски. Затем модель доводят контролируемым дообучением и обучением с подкреплением с вознаграждениями, управляемыми контрактом и учитывающими область (contract-guided, region-aware rewards). На этапе вывода применяется TraceFusion, который сохраняет содержимое вне фактически изменяемой области с высокой точностью.
По заявлению авторов, на шести публичных бенчмарках и на предложенном ими LensErase-Bench LensErase показывает существенный выигрыш как по объективным метрикам с опорой на эталон, так и по оценке визуально-языковой моделью (VLM) без эталона. Конкретные значения метрик и названия конкурирующих методов в тексте источника не приведены. Авторы надеются, что LensErase станет базовой моделью для приложений и систем, связанных со стиранием.
Ключевые факты
- LensErase, универсальная модель «Erase Anything», удаляющая объекты, визуальный текст, водяные знаки и сопутствующие визуальные эффекты по маске.
- Датасет LensErase-100M содержит 101,07 млн парных примеров «исходник, маска, результат»; также предложен бенчмарк LensErase-Bench.
- Модель дообучена на основе text-to-image модели Lens; ключевой приём, Mask-Aware RoPE, встраивающий маску в токены изображения без отдельной последовательности токенов.
- Обучение включает контролируемое дообучение и обучение с подкреплением, а на этапе вывода применяется TraceFusion для сохранения содержимого вне области правки.
- Авторы сообщают о существенном выигрыше на шести публичных бенчмарках и LensErase-Bench, но числовых результатов в источнике нет.
Почему это важно
Удаление объектов, надписей и водяных знаков, одна из самых востребованных операций при редактировании изображений. Работа предлагает единую базовую модель вместе с очень крупным датасетом (101,07 млн примеров) и собственным бенчмарком, то есть пытается закрыть задачу целиком: данные, архитектуру, обучение и оценку. Технически интересен приём Mask-Aware RoPE, который кодирует маску внутри позиционного кодирования, а не отдельным потоком токенов.
Кому это важно
Исследователям генерации и редактирования изображений, разработчикам инструментов для ретуши и обработки фото, а также командам, которым нужна модель для удаления объектов, текста и водяных знаков в разных разрешениях и пропорциях.
Как это применить
Источник не содержит сведений о публикации кода, весов или лицензии, поэтому практическое применение на данный момент ограничено знакомством с идеями: Mask-Aware RoPE как способ подать маску в трансформер, двухэтапное обучение (контролируемое дообучение и обучение с подкреплением) и TraceFusion для сохранения области вне маски. Авторы сами называют цель, стать базовой моделью для приложений и систем, связанных со стиранием.
Можно ли доверять
Это препринт с самооценкой авторов: формулировка «существенные улучшения» в тексте не подкреплена конкретными числами, названиями сравниваемых методов или значениями метрик. В источнике не указаны ни авторы, ни организации. Заявления об оценке по шести публичным бенчмаркам и LensErase-Bench нужно проверять по полному тексту статьи.
Риски и подводные камни
Без цифр и сведений о сравниваемых методах величину улучшений оценить нельзя. Среди заявленных сценариев, удаление водяных знаков; в источнике это названо как возможность модели, и вопросы допустимого применения не обсуждаются. Данные о составе и способе построения датасета, кроме его размера и формы «исходник, маска, результат», в источнике не приведены.
«Мы надеемся, что LensErase сможет служить базовой моделью для приложений и систем, связанных со стиранием.»
— авторы статьи