Представлена Apriel Voice 27B Preview: открытая речевая модель на базе Gemma 4
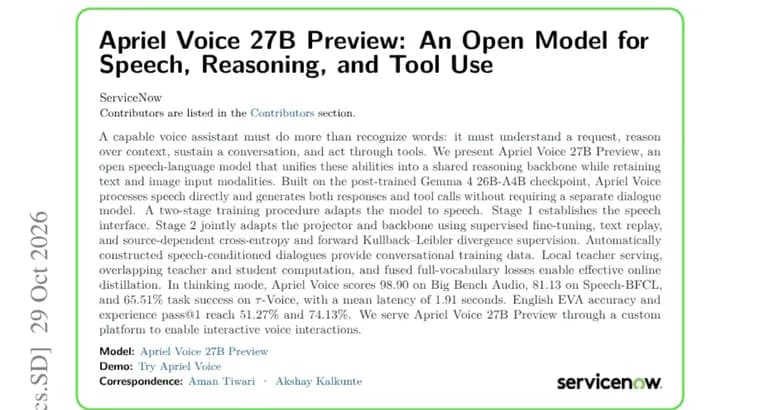
В статье на Hugging Face описана Apriel Voice 27B Preview, открытая речевая языковая модель (speech-language model). Исходная идея: хороший голосовой ассистент должен не просто распознавать слова, а понимать запросы, рассуждать по контексту, поддерживать разговор и действовать через инструменты. Авторы объединяют все эти возможности в одной общей рассуждающей основе (backbone), сохраняя при этом текстовый и графический входы.
Модель построена на дообученной (post-trained) контрольной точке Gemma 4 26B-A4B. Она напрямую обрабатывает речь и выдаёт и ответы, и вызовы инструментов, не требуя отдельной диалоговой модели.
Для адаптации к речи применена двухэтапная схема обучения. На первом этапе создаётся речевой интерфейс. На втором совместно дообучаются проектор и основная сеть: используются supervised fine-tuning (обучение на размеченных примерах), повторное включение текстовых данных (text replay) и надзор, зависящий от источника данных, кросс-энтропия и прямая дивергенция Кульбака, Лейблера (forward KL). Разговорные обучающие данные, автоматически построенные диалоги, обусловленные речью. Эффективную онлайн-дистилляцию обеспечивают локальный запуск модели-учителя, наложение вычислений учителя и ученика во времени и объединённые (fused) функции потерь по всему словарю.
Результаты в режиме рассуждения (thinking mode): 98,90 балла на Big Bench Audio, 81,13 на Speech-BFCL и 65,51% успешно выполненных задач на τ-Voice при средней задержке 1,91 секунды. Кроме того, заявлены 51,27% точности EVA на английском и 74,13% experience pass@1. Наконец, авторы развернули модель на специальной платформе для обслуживания, чтобы поддерживать интерактивное голосовое общение.
Ключевые факты
- Apriel Voice 27B Preview, открытая модель, которая объединяет понимание речи, рассуждение, разговор и вызов инструментов в одной основе и сохраняет текстовый и графический входы.
- Построена на дообученной контрольной точке Gemma 4 26B-A4B; отдельная диалоговая модель не нужна.
- Обучение двухэтапное: сначала речевой интерфейс, затем совместная адаптация проектора и основной сети с онлайн-дистилляцией.
- В режиме рассуждения: 98,90 на Big Bench Audio, 81,13 на Speech-BFCL, 65,51% успеха на τ-Voice при средней задержке 1,91 с.
- Дополнительно заявлены 51,27% точности EVA на английском и 74,13% experience pass@1.
Почему это важно
Голосовые ассистенты часто собираются из нескольких отдельных частей: распознавание речи, диалоговая модель, вызов инструментов. Здесь заявлен другой подход: одна открытая модель принимает речь и сама выдаёт ответы и вызовы инструментов. Для области открытых речевых моделей это заметная попытка совместить речь с рассуждением и действиями в одной системе. Название «Preview» говорит о предварительном характере выпуска.
Кому это важно
Разработчикам голосовых ассистентов и агентов, которым нужна открытая основа для речевых сценариев с вызовом инструментов, а также исследователям речевых моделей и дистилляции: описаны приёмы онлайн-дистилляции (локальный учитель, наложение вычислений учителя и ученика, объединённые функции потерь).
Как это применить
Из текста статьи (аннотации) видно, что модель принимает речь, текст и изображения и выдаёт ответы и вызовы инструментов. Лицензия, место размещения весов и требования к оборудованию в источнике не указаны, поэтому перед использованием их нужно проверить отдельно. Для оценки пригодности под свою задачу ориентиром служат те же бенчмарки: Big Bench Audio, Speech-BFCL, τ-Voice.
Можно ли доверять
Все цифры, собственные заявления авторов из аннотации статьи; в тексте источника нет сравнения с другими моделями, поэтому оценить, насколько результат силён, по нему нельзя. Не указано и то, в каком режиме измерены EVA и experience pass@1: с режимом рассуждения прямо связаны только результаты Big Bench Audio, Speech-BFCL, τ-Voice и задержка. В аннотации не названы авторы и организации.
Риски и подводные камни
Это предварительная версия (Preview). Задержка 1,91 с, средняя и относится к режиму рассуждения; для режима без рассуждения задержка не приведена. Непонятно, как «27B» в названии соотносится с базовой контрольной точкой 26B-A4B. Заявленные оценки получены на конкретных бенчмарках и не гарантируют такого же качества в реальных голосовых разговорах.