Omni-Embed-Mini: эмбеддинг-модель на 0,9 млрд параметров объединила текст, речь, аудио, изображения и видео
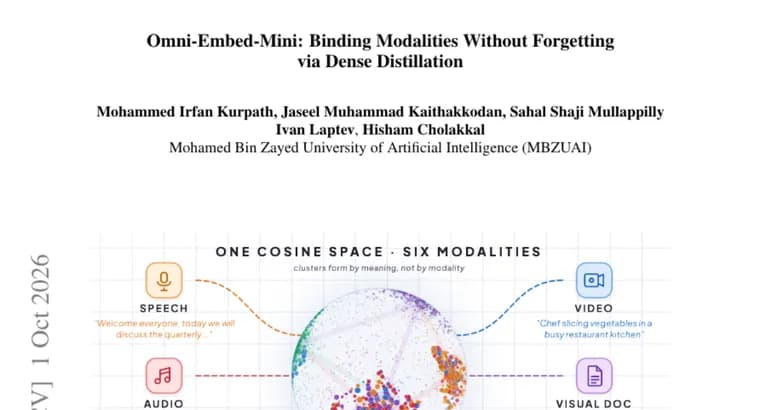
В статье представлена Omni-Embed-Mini, эмбеддинг-модель на 0,9 млрд параметров. Она переводит текст, речь, аудио, изображения, видео и визуально насыщенные документы (visually-rich documents) в единое общее косинусное пространство, при этом ни один параметр на текстовой стороне не обновляется. Авторы исходят из того, что при расширении текстовой эмбеддинг-модели на новые модальности качество текстового поиска обычно падает, а существующие омни-модальные модели компенсируют это многомиллиардным числом параметров.
Главная идея, по словам авторов, в том, что для обучения не нужна отдельная модель-учитель. Каждый медиаобразец сопоставляется с подробным описанием, собранным каскадным способом (dense cascaded caption), а целевым вектором служит эмбеддинг этого описания, посчитанный самой замороженной базовой моделью (backbone). Поскольку учитель и ученик используют одни и те же веса базовой модели, их геометрия пространства совпадает байт в байт, и для выравнивания хватает лёгких проекторов и поэтапно подключаемых адаптеров LoRA на энкодерах модальностей.
Обучение сочетает контрастивную функцию потерь Matryoshka SigLIP с онлайн-майнером сложных негативных примеров (hybrid hard-negative miner): негативы становятся «острее» по мере улучшения энкодера. Тот же рецепт переносится на вариант на 2,3 млрд параметров, для которого берётся нативная визуально-языковая базовая модель.
Текстовые веса Omni-Embed-Mini-0.9B остаются побитово идентичными базовой модели, поэтому обучение не может ухудшить текстовый поиск: модель сохраняет 49,57 nDCG@10 на MTEB-v2 BEIR-8 и при этом получает пять дополнительных модальностей. По утверждению авторов, она в 2,7, 9,5 раза меньше всех открытых омни-эмбеддеров, с которыми они сравнивают модель. Вариант на 2,3 млрд параметров, по их словам, конкурентоспособен с закрытой gemini-embedding-2 и немного опережает её по среднему результату по всем модальностям. Модели, код, данные и оценочный набор скриптов авторы выложили на странице проекта omniembed.cvmbzuai.com.
Ключевые факты
- Omni-Embed-Mini на 0,9 млрд параметров кодирует текст, речь, аудио, изображения, видео и визуально насыщенные документы в одно общее косинусное пространство.
- Текстовые веса остаются побитово идентичными базовой модели, поэтому текстовый поиск не ухудшается: 49,57 nDCG@10 на MTEB-v2 BEIR-8.
- Отдельная модель-учитель не нужна: целью служит эмбеддинг подробного описания образца, посчитанный замороженной базовой моделью; для выравнивания хватает лёгких проекторов и поэтапных адаптеров LoRA.
- По заявлению авторов, модель в 2,7, 9,5 раза меньше открытых омни-эмбеддеров, с которыми её сравнивали.
- Вариант на 2,3 млрд параметров, по словам авторов, конкурентоспособен с закрытой gemini-embedding-2 и слегка опережает её по среднему результату по всем модальностям.
Почему это важно
Расширение текстовой эмбеддинг-модели на другие модальности, как отмечают авторы, обычно ухудшает текстовый поиск, а существующие омни-модальные модели решают проблему ростом размера до многих миллиардов параметров. Omni-Embed-Mini предлагает другой путь: заморозить текстовую часть целиком и обучать только проекторы и адаптеры LoRA на энкодерах других модальностей. Так текстовое качество сохраняется по построению, а модель остаётся компактной, 0,9 млрд параметров.
Кому это важно
Тем, кто строит поиск и рекомендации по смешанным данным: тексту, звуку, видео, изображениям и документам в одном индексе. Также статья будет интересна исследователям эмбеддингов и дистилляции, потому что в ней предложен вариант обучения без отдельной модели-учителя: роль учителя играет та же замороженная базовая модель.
Как это применить
По словам авторов, модели, код, данные и оценочный набор скриптов доступны на странице проекта omniembed.cvmbzuai.com, так что результаты можно проверить самостоятельно. Для задач, где нужен общий поиск по нескольким типам данных и нельзя терять качество на тексте, имеет смысл посмотреть на вариант на 0,9 млрд параметров; вариант на 2,3 млрд параметров получается заменой базовой модели на нативную визуально-языковую. Лицензия выпущенных моделей, кода и данных в источнике не указана, перед использованием её нужно проверить на странице проекта.
Можно ли доверять
Все заявления в источнике принадлежат самим авторам статьи, независимой проверки в тексте нет. Сравнение с gemini-embedding-2 подано как «конкурентоспособно» с небольшим преимуществом по среднему по всем модальностям; сами значения и размер отрыва в источнике не приведены. Названия и размеры открытых омни-эмбеддеров, с которыми сопоставлялась модель, тоже не названы, поэтому диапазон «в 2,7, 9,5 раза меньше» проверить по этому тексту нельзя. Положительный момент, заявлено, что код, модели, данные и оценочный набор открыты.
Риски и подводные камни
Число 49,57 nDCG@10, это результат текстового поиска; в источнике не сказано, как он соотносится с показателем базовой модели или других моделей. Оценок по остальным модальностям и по среднему по всем модальностям в тексте нет, поэтому о качестве работы с речью, аудио, видео и документами судить по нему нельзя. Не указаны также объём обучающих данных, вычислительные затраты и название базовых моделей. Побитовая идентичность текстовых весов гарантирует лишь, что текстовый поиск не ухудшился, но не то, что межмодальный поиск будет хорош.